1.2 核心组件与工具链全景
1.2 核心组件与工具链全景
本节摘要:OpenVINO 的实用组件可归为四件套——负责转换的 ovc、负责执行的 Runtime、负责压缩的 NNCF、负责示范的 Open Model Zoo,外加 benchmark_app 等测量工具。本节给出全景分工图与组件速查表,让你在后续章节遇到任何工具名时都知道它站在流水线的哪个位置。
上一节把 OpenVINO 划成转换、编译、执行三段,这一节把每一段里的具体角色认领到人头。判断这一节学没学好的标准很实际:拿到一个报错或一个工具名,你能立刻说出它属于哪个环节、该去查哪章。组件认不全就动手,最常见的后果是拿量化工具去修转换报错、拿运行时参数去解决精度问题——力气花错地方。
一、四件套与它们的分工
先看全景。从训练框架产出的模型开始,到业务代码拿到推理结果为止,数据依次流过转换、压缩、编译执行三个阶段,测量工具横跨全程,模型库则在一旁提供现成示范。
图 1-1 OpenVINO 工具链全景:从训练模型到业务结果
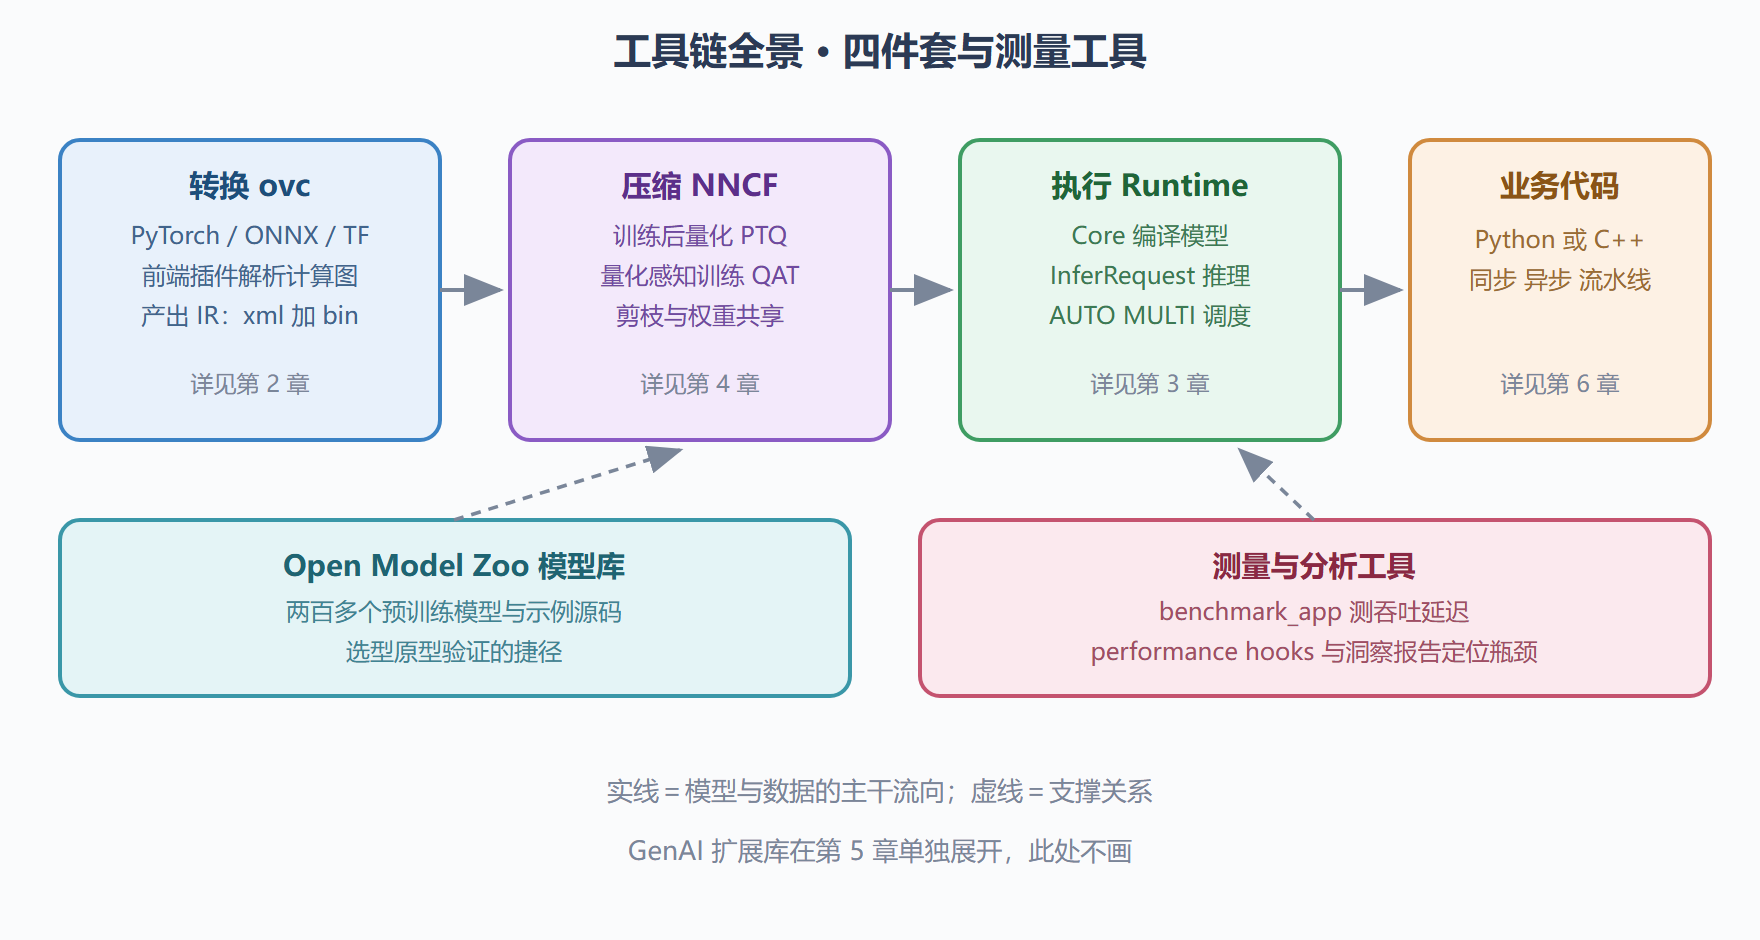
四件套的分工一句话概括:ovc 管进、Runtime 管跑、NNCF 管省、模型库管抄。ovc 吃进训练框架的模型,吐出 IR;Runtime 把 IR 编译到具体设备并执行推理;NNCF 在转换前后对模型做量化和剪枝;Open Model Zoo 提供现成的预训练模型与示例,让你在写自己的流水线之前先有个能跑的参照物。测量工具不在主干上,但它回答「跑得好不好」,没有它,前三件的所有决策都是盲调。
二、组件速查与常见误用
把每个组件的入口、产出和典型误用列成一张表,供随查随用:
| 组件 | 入口命令或类 | 产出 | 典型误用 |
|---|---|---|---|
| 模型转换 | ovc 命令 | IR(结构加权重两个文件) | 报算子错时反复重装环境,而不是查算子支持 |
| 运行时 | ov.Core 与 compile_model | CompiledModel 与 InferRequest | 拿运行时参数去补转换阶段欠的账 |
| 压缩量化 | nncf.quantize 等接口 | 压缩后的 IR | 把掉点原因归给推理引擎,实际是校准数据不当 |
| 模型库 | omz 工具族 | 预训练模型与示例 | 把示例代码原样上线,不做输入输出契约核对 |
| 性能测量 | benchmark_app | 吞吐、延迟、各层耗时报告 | 只看平均延迟不看百分位,漏掉尾延迟 |
误用的根源往往是把边界记反了。举个例子:某团队发现 INT8 模型精度下降两个点,第一反应是「推理引擎有 bug」,换设备、换版本折腾两天;后来用第 4 章的方法逐层对比 FP32 与 INT8 的输出,发现是校准集里全是白天画面、而现场有夜班光照。工具用对了地方,问题十分钟定位。这类「症状在这里、病灶在别处」的事,部署工作里占了大半,也是这本教程反复强调分阶段归因的原因。
组件之间还有一条隐性的版本契约:NNCF 产出的量化 IR 依赖较新 Runtime 的算子实现,老版本运行时遇到新量化 IR 可能直接报不支持的算子。混搭版本前先查兼容矩阵,或者干脆整条链一起升级——这是第 2 章转换排错时会展开的原则,这里先立个规矩。
三、模型库:被低估的选型工具
Open Model Zoo 值得单独一段,因为它在真实项目里的出场率比想象中高。它包含两百多个预训练模型,覆盖分类、检测、分割、人脸、姿态、OCR、语音等常见族,每个都附带精度指标与示例源码。选型阶段它的价值有两个:一是可行性验证——你的目标场景能不能做到实时,拿库里的同类模型在目标硬件上跑一遍 benchmark,半小时就能得出数量级判断,不用等自研模型训练完;二是工程参照——示例代码展示了输入预处理、输出解码的完整契约,自己模型的流水线可以照着骨架搭。
用法上有一条经验:模型库里的模型当「基线」,不要当「终点」。它给了你一个可运行的起点和一组可信的精度数字,但业务数据分布和公开数据集总有偏差,最终选型还是要把自己的数据灌进去验证。第 6 章的服务化部署会演示如何把模型库模型一路改造成生产服务。
一次组件误配的完整会诊
把「归因按阶段」落到一个真实的会诊过程里,你能看得更细。某团队的服务上线三周后出现周期性超时,最初的判断是「推理引擎在高负载下不稳定」,一度计划引入第二套运行时做降级。会诊从现象出发倒着走了一遍链路:超时集中在每天上午十点前后——不是流量峰值时段,却是批处理任务的启动时段;用第 3 章的属性查询确认推理服务与批任务共享同一块 GPU;再查批任务的预处理流程,发现它把全量历史图片回读进了共享内存。真相是批任务挤占了推理服务的内存带宽,推理请求排队超时。修复只用了两行配置:给批任务限速、错峰启动。
这个案例里每一步都在组件地图上有位置:现象归因到资源层而非引擎层,靠的是「先查属性、再下结论」;修复落在部署配置而非模型侧,靠的是「症状在这里、病灶在别处」的判断纪律。如果一开始就沿着「换运行时」的路走,三个月过去问题还在。组件地图的终极用途正在于此:它让团队的排查对话有共同的坐标系,减少各说各话的内耗。
还有一类高频误配值得单独点名:把预处理写了两遍。转换时用了均值缩放参数,应用侧又对输入做了归一化——两次归一化叠加,精度漂移却找不到原因。这类问题的诊断手法很简单:拿一张固定的测试图,分别喂「原始框架模型加原始预处理」与「IR 加部署预处理」,输出对拍(下一章会给出完整方法),偏差异常大时先怀疑预处理重复,再怀疑算子。把这类检查写进联调清单,能在联调第一周就拦住它。
安装与验证:动手前的最后一里
组件地图落实到机器上,还有一件小事值得写清楚:装什么、怎么确认装对了。运行时与工具链的安装包把组件拆成了可选部件——推理运行时是必装项,NNCF、GenAI 扩展库、开发样例都是可选的。最小验证三步走:查运行时版本号;用 1.3 节的三行代码列出可用设备,确认设备插件加载成功;跑一次官方示例的推理,确认端到端通畅。三步全过再进第 2 章,能把「环境问题」与「代码问题」干净地隔离——排错时环境嫌疑先排除,事半功倍。
版本策略上给一条务实建议:跟主线大版本,不追每一版小更新。工具链的次版本更新频繁,除非更新说明里有你正需要的修复,否则保持稳定版本直到一个里程碑(比如第 2 章全部走通)再统一升级。频繁升级带来的版本漂移,是新手环境问题的一大来源。
三个高频追问
组件地图讲完,回答三个最常见的追问。追问一:要不要把所有组件一次装全?不建议——按需安装是更稳的策略,本章四件套对应四个独立安装项,用到哪章装哪项,装得越少,版本冲突面越小。追问二:模型库里的模型精度可信吗?可信但不可全信——库内标注的精度来自公开数据集,与你的业务分布必然有偏差,它给的是「量级与可行性」,不是「上线指标」。追问三:组件之间可以混用不同版本吗?运行时与转换器尽量同版,NNCF 产出的 IR 对运行时有最低版本要求——查对应工具的兼容说明,混搭的排查成本远高于对齐的成本。三个追问的共同答案指向同一件事:组件地图的价值在「知道每件东西的边界」,边界清楚了,装什么、信多少、怎么配就都不再是问题。
本节要点回顾
- 四件套:ovc 管转换进 IR,Runtime 管编译执行,NNCF 管量化压缩,模型库管示范与基线。
- 测量横跨全程:benchmark_app 与性能洞察工具不属于任何单一阶段,但所有阶段的成绩单都由它出具。
- 归因按阶段:转换报错查第 2 章、性能不达标查第 3 与第 4 章、精度掉点先查校准数据再怀疑引擎。
- 版本契约:量化 IR 与运行时版本有配套关系,整条工具链尽量同步升级。
- 模型库的用法:原型验证与工程参照,最终以自有数据验证为准。
组件地图有了,接下来看它脚下的地形:OpenVINO 能跑在哪些硬件上、不同代际差在哪、多设备怎么协同——1.3 节讲硬件支持体系,这是选型决策树里「选哪块算力」这一分支的素材。