1.3 硬件支持体系与设备代际
1.3 硬件支持体系与设备代际
本节摘要:OpenVINO 的设备插件覆盖 CPU、核显、Arc 独显与 NPU 四类算力,各有代际与能力差异;AUTO、MULTI、HETERO 三种多设备模式解决「谁跑、怎么分」的问题。本节给出一台典型机器上的设备查看法、代际对照与选择直觉,是选型决策树「选哪块算力」分支的素材。
1.2 节认全了软件角色,这一节低头看它们脚下的硬件。部署选型里一半的分歧来自对硬件的模糊认知——「有 GPU」这句话在 2015 年和 2024 年的含义完全不同。读完本节,你应当能用一条命令列出自己机器的全部可用设备,并对每类设备的强弱项给出一句判断,下一节的运行时选型对比要用到这些判断。
一、四类设备,各有性格
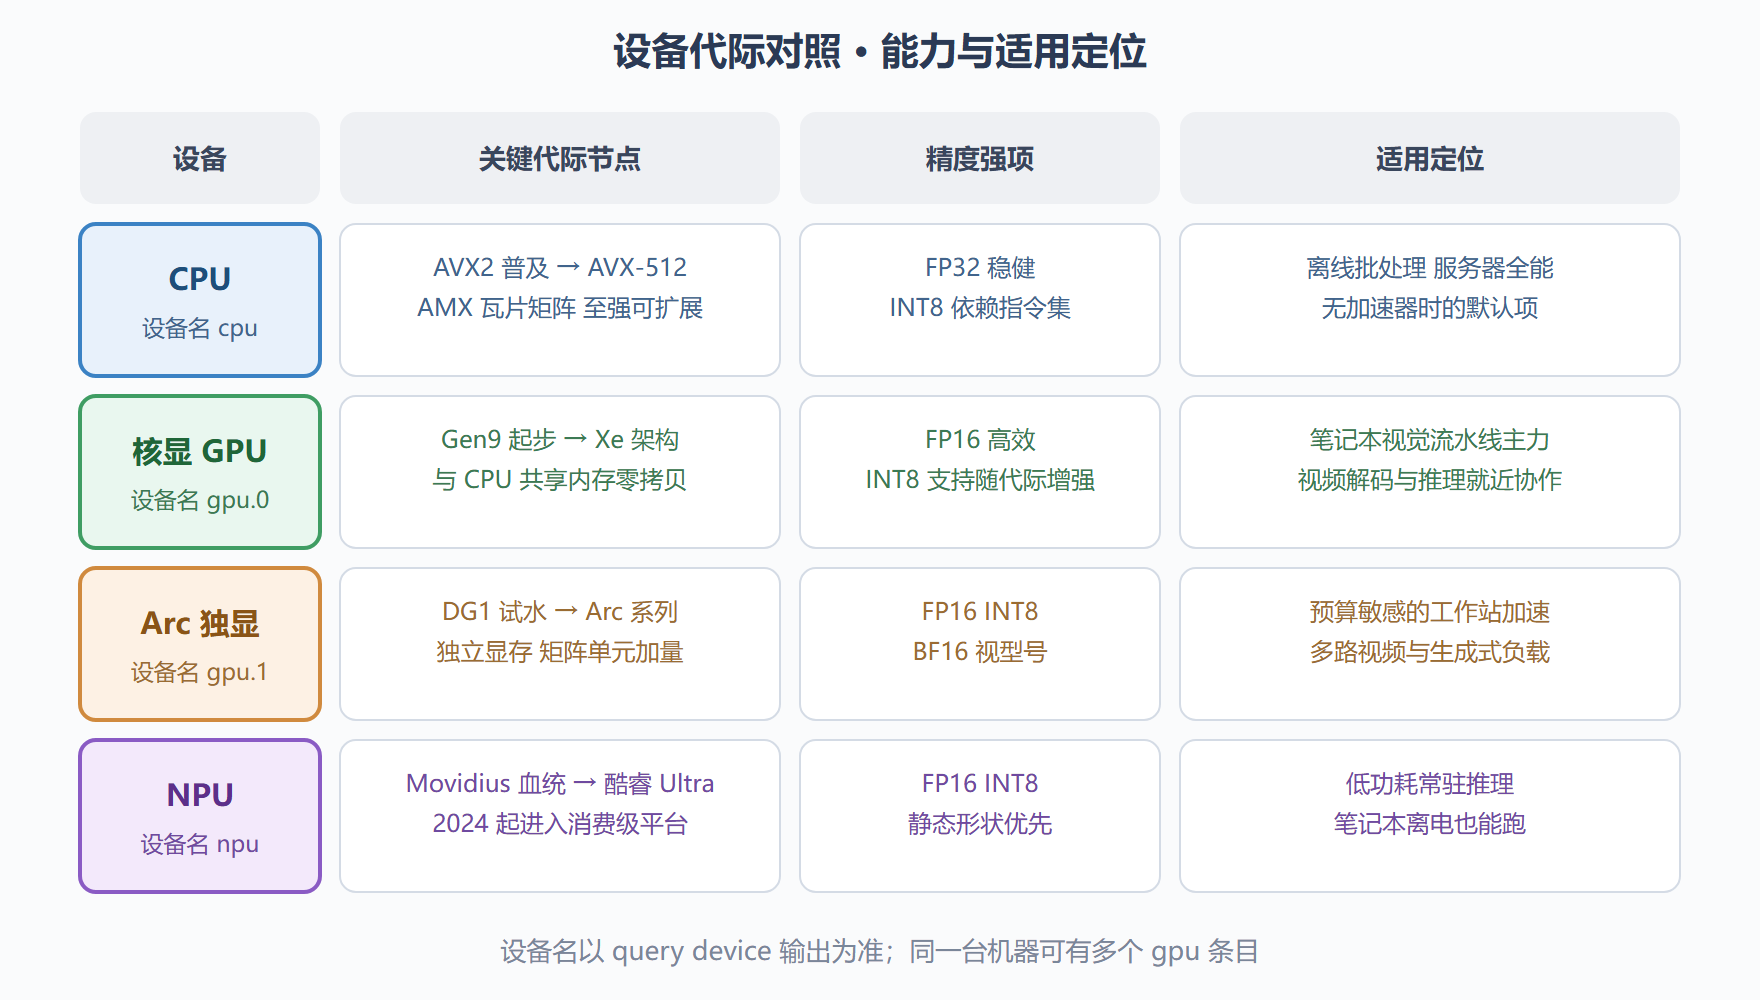
先说 CPU。它是最不会被低估却常被算错账的设备:AVX2 与 AVX-512 指令集让现代至强和酷睿在 FP32 与 INT8 上都有可观的吞吐,AMX 瓦片矩阵扩展在较新的至强上进一步拉大矩阵运算的优势。CPU 的长处是批处理吞吐与稳态可靠,短处是单请求延迟的能耗比不如专用单元。批式离线任务、现场没有可用加速器的场合,CPU 仍是默认答案。
核显(iGPU)是消费级笔记本上最容易被浪费的算力。Xe 架构核显支持 FP16 高效执行,与 CPU 共享内存意味着零拷贝——视频帧不用跨设备搬运,这对预processor较重的视觉流水线是实打实的优势。 Arc 独显把 Xe 架构做大,显存独立、矩阵单元更多,适合预算敏感又需要比核显更强算力的工作站。NPU 则是 2023 年之后的新角色:酷睿 Ultra 把它装进消费级笔记本,主打低功耗下的持续推理——待机监控、常驻语音这类「一直开着」的负载是它的主场,重吞吐反而是短板。
图 1-2 四类设备的代际与定位
二、亲手把设备摸一遍
与其背表格,不如直接问机器。三行 Python 就能列出可用设备与关键属性:
import openvino as ov core = ov.Core() print(core.available_devices) # 例如 ['CPU', 'GPU.0', 'NPU'] for dev in core.available_devices: name = core.get_property(dev, "FULL_DEVICE_NAME") print(dev, "->", name)
在一台带核显的酷睿 Ultra 笔记本上,输出通常是 CPU、GPU.0、NPU 三个条目;插上 Arc 独显后多出 GPU.1。查到的设备名就是 compile_model 的第二个参数——「CPU」「GPU.0」「NPU」这些字符串并非随意别名,而是插件注册表里的键。多设备模式在这个名字上做文章:AUTO 交给运行时挑、MULTI 串联多块一起跑、HETERO 按层切分,三者的机制与适用边界在第 3 章调度一节展开。
代际差异体现在属性查询里。同一台机器,核显是否支持 FP16 加速、CPU 有没有 AVX-512,都能通过设备属性接口确认。动手前的这套侦察值得养成习惯:我们见过不少「性能不达标」的案例,最后发现模型被编译到了错误设备——查询代码三行,排查时间省三天。
三、选择的直觉:三个问题定方向
设备选型可以从三个问题推出来。第一问:负载是不是一直开着?7×24 常驻、功耗预算紧(如电池供电或密闭盒子),先看 NPU;间歇性重计算,看 GPU。第二问:数据从哪来?视频流场景里解码就在核显旁边,选核显能省掉一次跨设备搬运;传感器数据进内存后由 CPU 预处理,CPU 后接核显的分工往往最顺。第三问:延迟还是吞吐优先?单请求低延迟追求响应速度,核显与 NPU 常够用;批量吞吐追求单位时间处理量,CPU 批模式与 Arc 独显有优势。
三个问题答完,方向通常就定了。剩下的量化验证交给第 4 章(精度与压缩的代价)与第 7 章(benchmark 实测)。此处只需记住一个原则:设备没有全场最优,只有场景匹配——任何「我的设备跑所有模型都最快」的说法,都值得先怀疑再验证。
设备问题的三个真实现场
选型判断在纸面上都通顺,落到现场才见分晓。补三个我们处理过的设备侧现场,每个都对应一类高频误区。
现场一:核显上模型加载奇慢。某客户的视频分析服务在核显上首次推理延迟高达数秒,一度怀疑核显性能不行。排查发现模型在加载后触发了即时的内核编译——核显路径的编译开销本来就比 CPU 高,服务又把编译放在了首个请求里。解法是把编译提前到服务启动阶段完成,再配合编译产物缓存,首请求延迟从秒级回到百毫秒内。这个现场的通用教训:核显与独显的「编译贵、执行快」特征要在架构上提前安置,别让第一个用户当测试员。
现场二:多设备共存下的驱动冲突。一台同时装有核显与 Arc 独显的工作站,独显设备时而可用时而消失。根因是两个设备的驱动版本来自不同发布线,共享组件互相覆盖。统一到同一版本线后问题消失。设备排查的清单里,「驱动版本是否同线」应该排在「重启试试」之前。
现场三:电池模式下的性能腰斩。同一台笔记本,插电与用电池,同一模型推理速度差了一倍。这不是玄学而是功耗策略:电池模式下系统限制设备频率与调度,推理作为计算密集负载首当其冲。给现场设备做性能验收时,必须记录供电状态——只记录「跑分多少」不记录「什么状态下跑的」,数据就没有可比性。这三条现场经验合并成一句话:设备层面的意外,多数不在算力本身,而在编译时机、驱动一致性与供电策略这些「设备外围」。
硬件采购清单的三个补充维度
如果你处在设备选型的采购环节,除了算力峰值,还有三个维度值得写进清单。内存与带宽:核显共享内存的容量受系统内存约束,模型常驻内存加运行余量要留够;独立显卡看显存带宽而不只看容量,带宽决定大模型的解码速度(第 5 章会展开)。编解码单元:视频类项目里,硬解码单元的支持规格(分辨率、路数、编码格式)往往比推理算力更先成为瓶颈。长期供货与驱动支持线:边缘设备的生命周期以年计,所选平台是否有持续数年的驱动维护承诺,直接决定三年后你的系统还能不能升级运行时。三个维度都过关的设备清单,才配得上「生产选型」四个字。
三个高频追问
设备话题收尾前回答三个高频追问。追问一:查询到的设备列表与官方支持列表对不上怎么办?先查两件事——运行时版本是否过旧(新设备插件随新版本发布),驱动是否装全(核显与独显的驱动包可能分开),两者都正常仍缺设备,再查主板 BIOS 里的核显开关。追问二:同一块设备在不同机器上表现差异大,正常吗?正常且常见——散热设计、供电能力、BIOS 功耗策略都会影响同一芯片的实际发挥,这也是「验收要在目标机型上做」的原因。追问三:NPU 现在适合上生产吗?按负载分:低功耗常驻、模型结构简单的场景已经在生产验证范围内;重算力、动态形状的场景建议先试点再定,把它当「补充算力」而非「主力算力」来规划。三个追问的共同底色:设备层的答案永远在「具体设备加具体环境」里,抽象讨论到此为止,动手查询开始落地。
本节要点回顾
- 四类设备:CPU 稳态吞吐、核显零拷贝与 FP16、Arc 独显补算力、NPU 低功耗常驻。
- 代际敏感:指令集与矩阵单元决定精度强项,查询设备属性比查网上评测更可靠。
- 设备名即接口:available_devices 列出的字符串就是编译目标,AUTO、MULTI、HETERO 在其上做组合。
- 三问定位法:负载常驻吗、数据从哪来、延迟还是吞吐优先——答完方向自现。
硬件地形摸清了,第 1 章的最后一道选择题摆上台面:同样做推理,OpenVINO、TensorRT、ONNX Runtime 三大运行时各强在哪、你的项目该押哪个——1.4 节用一张对比表和一棵决策树收尾本章。