2.1 模型准入与转换机制
2.1 模型准入与转换机制
本节摘要:把训练模型变成 IR 有两条路线——离线转换(ovc)与运行时导入(read_model),各有明确适用场景。本节讲清两条路线的机制差异、关键参数(输入形状、布局、均值缩放)的实际含义,以及选错路线的典型症状,这是本章决策树的第一层分叉。
第 1 章选完运行时,第一道实操门槛就横在面前:手里的 PyTorch 或 ONNX 模型怎么变成 IR。这一节是第 2 章的入口——先把「怎么转」的两条路线走通,2.2 节再剖开产物 IR 看内部结构,2.3 节处理转不过去的情况。转换是全书第一个高频故障点,值得把机制讲透再动手。
一、两条转换路线:离线铸造与运行时导入
OpenVINO 支持两种把外部模型变成可推理形态的方式,区别在「什么时候做图解析」。
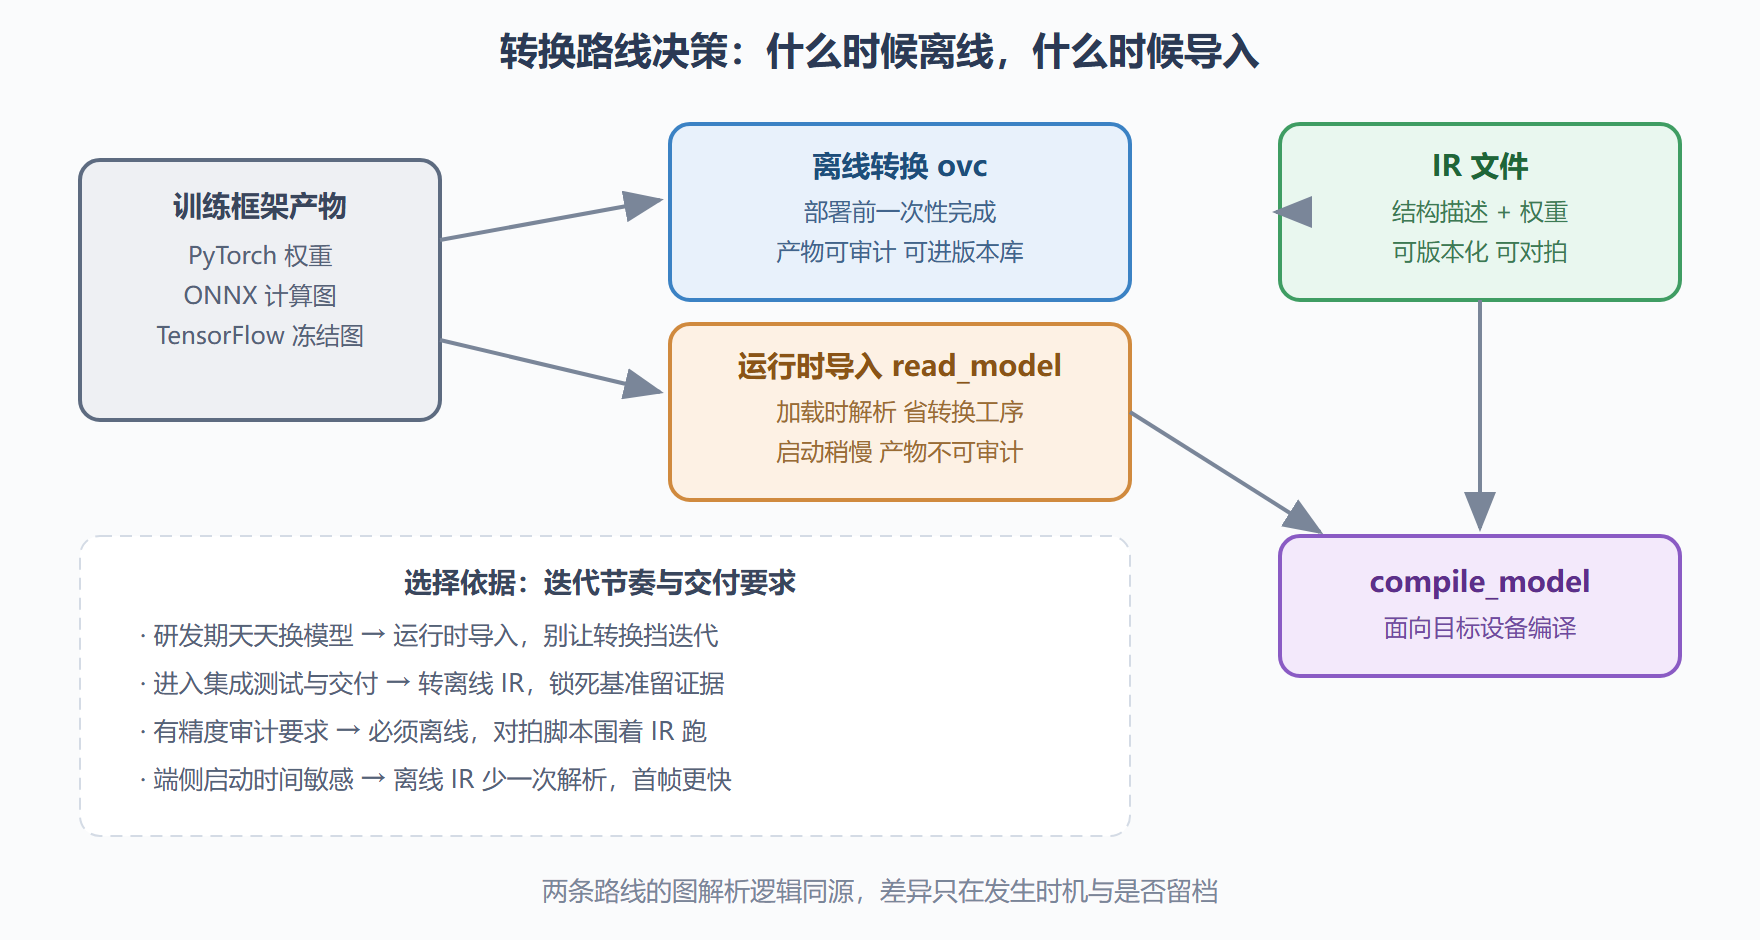
离线转换用 ovc 命令(或等价的 convert_model 接口)在部署前一次性产出 IR 文件。它的价值是确定性与可审计:转换在受控环境完成,产物可以进版本库、过审查、随发布包分发;转换前后跑一遍精度对拍脚本,误差曲线固化成验收证据。医疗、金融这类对可复现有硬要求的场景,基本没有第二种选择。代价是多一道工序:模型每次迭代都要重转,CI 流程里要为它留位置。
运行时导入则是把 ONNX 等格式直接交给 read_model,图解析推迟到加载时完成:
import openvino as ov core = ov.Core() # 路线一:运行时导入,直接吃 ONNX model = core.read_model("detector.onnx") compiled = core.compile_model(model, "CPU") # 路线二:离线转换的产物,加载的是 IR model_ir = core.read_model("detector.xml") compiled_ir = core.compile_model(model_ir, "CPU")
两段代码运行起来几乎一样,工程含义却不同。导入路线省掉转换工序,原型期一天迭代十次模型也不会被转换流程卡住;但每次加载都要重新解析,启动时间多了几百毫秒到几秒,且产物不可审查——你拿到的是运行时内部的图,不是一份可以拿去做精度对拍的文件。
怎么选?我们的判断标准是迭代节奏:还在调结构、天天换权重的研发期,用导入;结构冻结、进入集成测试的交付期,转离线 IR。拿不准时选离线——它不锁死任何后续选项,导入路线却没法回头补审计材料。
图 2-1 两条转换路线的分叉与合流
二、关键参数:三条会咬人的声明
无论哪条路线,转换时都绕不开三个参数。它们的坑不在语法而在语义——每个参数都在替模型做一项声明,声明错了运行期才爆发。
输入形状是第一个。静态形状声明给出固定维度,编译器据此预分配缓冲、选择最优内核,性能最好;动态形状用问号占位,保留运行期灵活性,代价是内核选择保守、内存规划粗放。折中方案是把动态轴限制在区间内——比如输入宽高限定在 256 到 1024 之间,编译器能按区间生成多套内核。常见翻车现场:训练时输入是动态的,部署到 NPU 时忘锁形状,编译直接被拒——NPU 对静态形状的偏好比 CPU 强得多,这类约束在 1.3 节的设备表里已有提示。
布局是第二个。NCHW 与 NHWC 之争本质是内存排布与指令集的亲和问题:CPU 的向量指令喜欢通道维连续,部分 GPU 路径偏爱空间维连续。转换时声明布局,转换器自动插入必要的转置节点。多输入模型要逐个声明——图像输入和检测框列表输入的布局各不相同,一锅烩的声明是隐性错误源。
均值与缩放是第三个。这两个参数把训练时预处理流水线的归一化常量固化进 IR,推理侧就能省掉一步预处理。风险在于它制造了一个隐式契约:IR 内部做了归一化,调用方再喂归一化过的数据就是二次归一化——精度悄悄漂移,且不报错。我们把这类问题称为「预处理藏进了模型」,团队协作时尤其要在接口文档里写明 IR 是否内嵌了预处理。
三、转换不是黑盒:可验证性是底线
离线转换最该被利用的一点是可验证。转换完成后跑一段对拍脚本,用同一批输入分别喂原始框架模型与转换后的 IR,比较输出误差:
# 对拍思路示例:省略了实际的双端推理细节 import numpy as np def check_agreement(outputs_a, outputs_b, tol=1e-3): for a, b in zip(outputs_a, outputs_b): diff = np.abs(a - b).max() if diff > tol: return False, diff return True, 0.0
FP32 转 FP32 的误差通常在浮点舍入量级;若对拍出现明显偏差,优先怀疑三处:预处理不一致(含上面说的二次归一化)、动态轴对不上、框架版本差异导致的算子实现差异。把对拍脚本留在 CI 里,每次模型迭代自动执行,转换环节就从「希望不出事」变成「出事必报警」。2.3 节处理算子不支持时,这套对拍思路同样是验证替换方案的主要工具。
动态形状的一单现场复盘
参数的语义再补一个现场案例,主角是最容易踩坑的输入形状。某文档扫描应用,训练时输入高度固定、宽度动态(适配不同页面比例),导出的模型带着动态宽度轴。原型在 CPU 上一切正常;切到核显后首次推理偶发数秒级卡顿,切到 NPU 直接编译失败。三台设备三种反应,把动态形状的代价展示得淋漓尽致:CPU 对动态轴最宽容,核显要按动态生成内核导致卡顿,NPU 则要求完全静态。
修复走的是 2.1 节埋的思路——形状收敛:业务上把页面宽度归一化为四档固定值,模型按四档各转一份静态 IR,运行时按输入比例选档。核显卡顿消失,NPU 编译通过,代价是四份模型文件的存储与一份档位选择逻辑。这单的账很有代表性:动态形状的灵活性在云端是免费午餐,在边缘是按秒计费的奢侈品。转换前先问一句「业务真的需要连续可变吗」,多数时候答案是需要的是「几档」而不是「任意」。
转换配置纳入版本管理
再补一条团队工程纪律。转换参数散落在个人终端的命令行历史里,是转换环节混乱的常见根源——同一个模型,两个工程师转出来的 IR 行为不同,谁也说不清差异在哪。解法是把转换动作固化成脚本入仓:参数写在转换脚本或配置文件里,与模型源文件同版本管理;CI 按脚本自动产出 IR,禁止手工转包入库。IR 产物的命名带上源模型与配置的版本标识,回溯时「哪个 IR 对应哪次模型改动」一目了然。这套做法的成本是一次性的脚本化工作,收益是转换环节从「手艺」变成「可复现的工序」——它是第 7 章自动化闸门的地基,越早打越好。
三个高频追问
转换话题收尾,回答三个高频追问。追问一:转换失败的第一救急动作是什么?读报错的算子名与版本号,然后升级工具链再试一次——相当比例的转换报错随工具链更新直接消失,这一步的成本几乎为零,却经常被跳过。追问二:转换后的模型文件变小很多,正常吗?正常——常量折叠合并了重复算子、训练期辅助节点被剥离,都是体积下降的正常来源;需要警惕的是「变小且精度对拍失败」的组合,那说明被裁掉的东西不是冗余。追问三:同一模型转两次,IR 字节级一致吗?不保证——工具链版本、转换参数顺序都可能影响内部表示的字节排布;判断「转换是否等价」要靠对拍脚本的数值结论,不能靠文件校验和。三个追问指向同一个原则:转换环节的信任基础是对拍数据,不是对工具的感觉。
本节要点回顾
- 两条路线:ovc 离线铸造换确定性与可审计,read_model 运行时导入换迭代速度,按研发节奏选。
- 输入形状即资源声明:静态最优性能,动态保灵活,NPU 等设备对静态形状有硬偏好。
- 布局与预处理参数是隐式契约:声明错了不报错,而是精度漂移,接口文档必须写明。
- 对拍脚本当守门员:转换后立即验证数值一致性,并纳入 CI 长期执行。
路线走通了,产物 IR 里到底装着什么——优化器都做了哪些手脚、动态形状在文件里长什么样?2.2 节剖开 IR 看内部。