2.2 中间表示 IR 深度解析
2.2 中间表示 IR 深度解析
本节摘要:IR 由结构描述与权重文件配对构成,是静态化的计算图加运行期元信息。本节剖开两个文件的内部:结构文件里有什么、权重怎么排布、版本与算子集如何标注,以及为什么「读得懂 IR」的工程师排错速度显著更快。
2.1 节把模型转成了 IR,这一节停下来拆开产物看内部。判断本节价值的标准很简单:转换报错、精度对不上、模型加载异常时,能不能打开结构文件直接看出问题在哪。IR 不是黑盒,它是一份人类可读的模型档案,读它的能力值得花一节来建立。
一、一对文件,两种职责
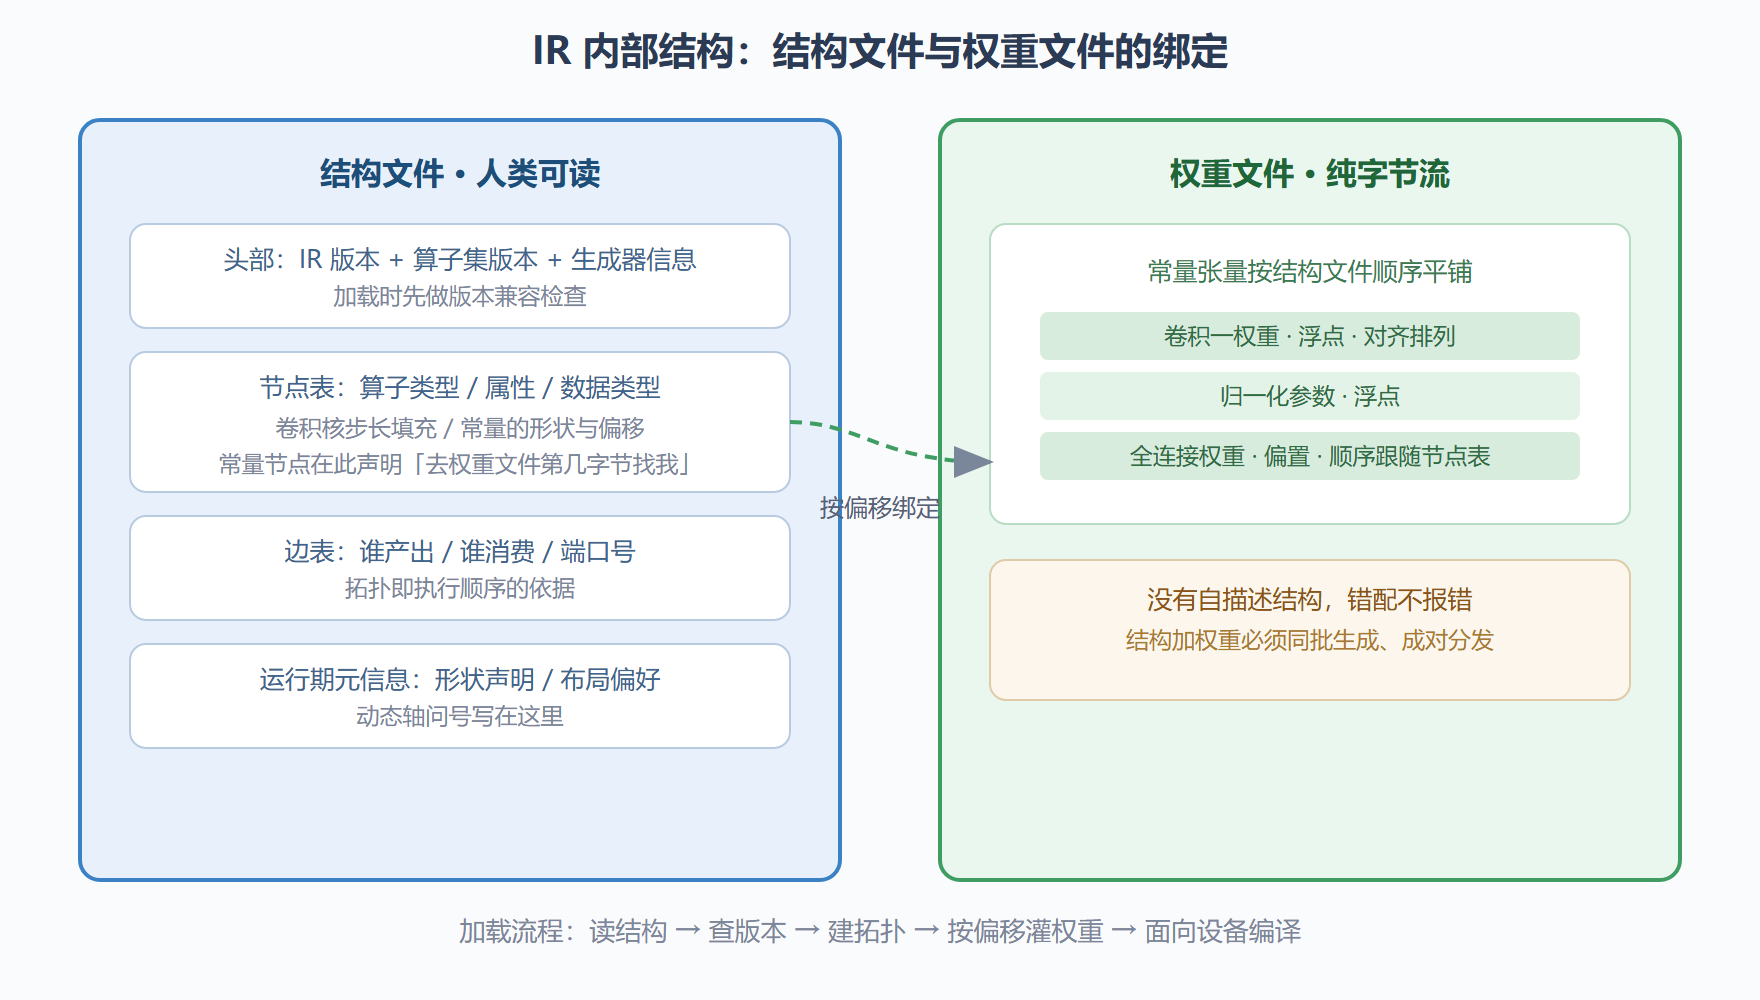
IR 的物理形态是一对文件:结构文件描述「网络是什么」,权重文件存储「网络有什么」。两者靠约定配对——结构文件里每个常量节点记录名称、形状与数据类型,权重文件按同样顺序平铺原始字节。拆开看各有分工。
结构文件是 XML 格式,开头声明 IR 版本与算子集版本,随后是节点与边的完整列表。每个节点带算子类型、输入输出与属性;每条边记录生产者与消费者。文件末尾是运行期元信息。权重文件没有任何结构信息,纯粹是按结构文件指令顺序排列的字节流——这也是为什么两个文件必须成对出现、同批生成:错配的结构与权重不会报错,而是产出错误结果,比报错危险得多。
图 2-2 IR 一对文件的内部结构与绑定关系
二、读一份真实的结构文件
抽象描述不如亲眼看。下面是一个卷积节点在结构文件里的样子(节选并简化):
<layer id="12" name="conv1_weight" type="Const" version="opset1"> <data element_type="f32" shape="32,3,3,3" offset="0" size="3456"/> </layer> <layer id="14" name="conv1/Conv2D" type="Convolution" version="opset1"> <data strides="1,1" pads_begin="1,1" pads_end="1,1" dilations="1,1" groups="1" output="32"/> <input> <port id="0" precision="FP32"> <dim>1</dim><dim>3</dim><dim>224</dim><dim>224</dim> </port> </input> <output> <port id="1" precision="FP32"> <dim>1</dim><dim>32</dim><dim>224</dim><dim>224</dim> </port> </output> </layer>
从这一小段能读出四件事:卷积核是 32 个 3 通道 3×3 的滤波器;步长为 1、四边补一圈零,所以空间尺寸保持 224 不变;输入是单张三通道 224×224 的 FP32 图像;权重存在权重文件的第 0 字节起共 3456 个元素处。排查「模型输入尺寸不对」「通道数不匹配」这类问题时,答案就写在这些 port 与 dim 标签里——比起反复改代码试错,先看一眼结构文件往往三分钟定案。
另一个实用技巧是统计节点类型分布。把结构文件里的算子类型做个计数,立刻知道这个模型是卷积为主还是矩阵乘为主、有没有复杂的动态算子。第 4 章评估量化收益、第 7 章分析逐层耗时之前,这个分布就是预期管理的起点。
三、静态图与动态轴:灵活性放在哪里
IR 是静态图——节点拓扑加载前完全确定。但「静态」不等于「死板」:形状可以声明为动态轴,属性可以参数化。设计哲学是把灵活性收进明确的格子:哪些维度可变、在哪个范围变,都写进形状声明,编译器据此生成带运行期形状推导的内核。
代价要心里有数。动态轴会让内存规划变粗(缓冲按上限留)、内核选择变保守(放弃针对特定尺寸的极限优化)。我们的实测经验:同一模型把可变分辨率锁成三档固定尺寸,CPU 延迟能差出一成以上;NPU 上差距更明显,甚至直接决定能否编译。所以发布前的形状收敛——把训练期的完全动态收敛成部署期的有限档位——是值得专门排入计划的一道工序,第 5 章大模型部署的 KV 缓存管理会把这道工序推到极致。
版本兼容也在头部声明里。结构文件根节点写明 IR 版本,节点写明各自算子集版本;新版运行时读旧 IR 通常向下兼容,反过来则未必。遇到「旧环境生成的 IR 在新版本上报警告」,先查头部版本号再动手改模型——多数时候升级一次工具链比改模型便宜。
从一份 IR 差异看版本治理
补一个用 IR 结构文件破案的实例。某团队发现同一模型两份 IR 的推理结果存在微小偏差,两份都「转换成功」,来源却不同:一份在 A 同事的机器上手工转换,一份出自 CI 流水线。打开两个结构文件对比,头部生成器信息直接暴露了差异——两台机器的工具链版本不同,跨版本的前端对同一个算子的规整策略有变。把 CI 版本回填到 A 的机器重新转换,偏差消失。这个案例把 2.1 节「转换配置入版本管理」的纪律补全了另一半:工具链版本也要入版本管理,它和转换参数一样是 IR 血统的一部分。
顺着版本话题再往前一步:怎么安全地做工具链升级。稳妥路径是「影子验证」——新旧版本各转一份 IR,对拍脚本全量比对,再跑一轮基准对比;数值与性能双双平稳,才切换生产转换线。升级最忌「顺手就升」,推理工具链的次版本偶有行为微调,影子验证半小时,省的是线上排查一整周。
精简与裁剪:IR 不是只能原样用
结构文件还有一类进阶玩法值得知道:有控制地对 IR 做裁剪与变换。工具链提供对 IR 的序列化与重载能力,配合图变换接口,可以把「预处理已固化」的推理版 IR 与「结构干净」的分析版 IR 分开维护;发布流水线里还能把校准与调试用的中间节点剥掉,让交付产物最小化。裁剪的每一刀都要过对拍——这是 2.1 节纪律的自然延伸:对 IR 的任何手动操作,验证责任都在操作者。
文件体积也值得一提。权重文件的大小基本等于参数量乘以每参数字节数,看到一份 FP32 模型转出的权重文件比预期大一截时,先查结构文件里有没有被固化的常量张量——某些训练期辅助节点会被原样带进 IR,转换参数里关闭不需要的输出、剔除辅助节点,文件能瘦一圈。瘦身的收益在边缘设备上尤其实际:OTA 分发体积、加载内存、烧录空间全都受益。
三个高频追问
IR 话题收尾,回答三个高频追问。追问一:IR 文件里会不会泄露训练数据或商业机密?结构文件只有拓扑与属性,权重文件就是参数本身——不含训练数据;但参数本身就是最有价值的资产,IR 的分发管控应等同于模型权重的管控,纳入资产保护范围。追问二:动态形状的模型,形状信息在结构文件里怎么看?找运行期元信息里的维度声明,动态轴以特殊标记呈现,静态轴直接给数值——「声明里写没写死」一眼可辨,这也是接收别人模型时的第一个检查动作。追问三:能不能手改结构文件?技术上文本可编辑,但手改等于绕过转换器的语义校验,端口对接、偏移计算错一点就是运行期错结果——确需修改时走图变换接口或重新转换,把手工编辑留给「改个名字排错用」这类只读诊断场景。三个追问的共同提醒:IR 是工程资产,读它、管它、改它都要有纪律。
本节要点回顾
- 一对文件:结构文件管「是什么」,权重文件管「有什么」,按偏移绑定,必须同批生成。
- 结构文件可读:算子类型、属性、端口形状一目了然,是排错的第一现场。
- 节点分布当体检报告:算子类型计数提前暴露量化收益与性能瓶颈所在。
- 静态图留了动态格:形状动态是显式声明的能力,部署前把动态轴收敛成有限档位通常更划算。
结构看懂了,剩下的问题是——如果模型里的算子 IR 不认识怎么办?2.3 节讨论算子映射与自定义算子的三条出路。