2.3 算子映射与自定义算子
2.3 算子映射与自定义算子
本节摘要:转换失败的大多数根源是算子问题。本节先讲清「算子支持」其实是个三维命题——算子集版本、目标设备、精度模式,再给出算子不被支持时的三条出路:替换等价实现、写扩展、回源框架改图,并配一条完整的排查路径。
前两节把转换流程与 IR 结构走通了,这一节处理第 2 章的最后一块硬骨头:转换器报「不支持的算子」时怎么办。这是部署新手最先撞上的墙,也是区分「会调包」与「会部署」的分水岭——墙上有门,而且不止一扇。
一、「支持」是个三维命题
说某个算子被 OpenVINO 支持,要同时满足三个条件,缺一不可。
第一维是算子集版本。OpenVINO 的算子集按版本演进,新版本不断吸收新算子;老版本运行时遇到新算子自然不认识。查支持列表时,先确认自己工具链的版本,再去对照——网上教程不会替你核对版本,这是「教程里能跑、本机报错」的第一大来源。
第二维是目标设备。同一个 IR 算子,CPU 插件支持、GPU 插件未必实现,NPU 的覆盖面更窄。转换成功只说明图合法,编译到具体设备时才算完成真正的验证。所以报错要分清发生在哪一步:转换期报错是前端解析问题,编译期报错才是设备算子缺口。
第三维是精度模式。算子存在不等于所有精度路径都通。某些组合算子在 FP32 下走融合内核、INT8 下却要回退到通用实现,性能骤降;个别算子在低精度下干脆没有实现。第 4 章量化时会再次遇到这个维度。
三维叠起来,正确的排查姿势就清楚了:报错信息里找算子名,然后逐一核对「工具链版本里有没有、目标设备支不支持、当前精度走不走得通」。三个坐标定位完,该走哪条出路自然浮出来。
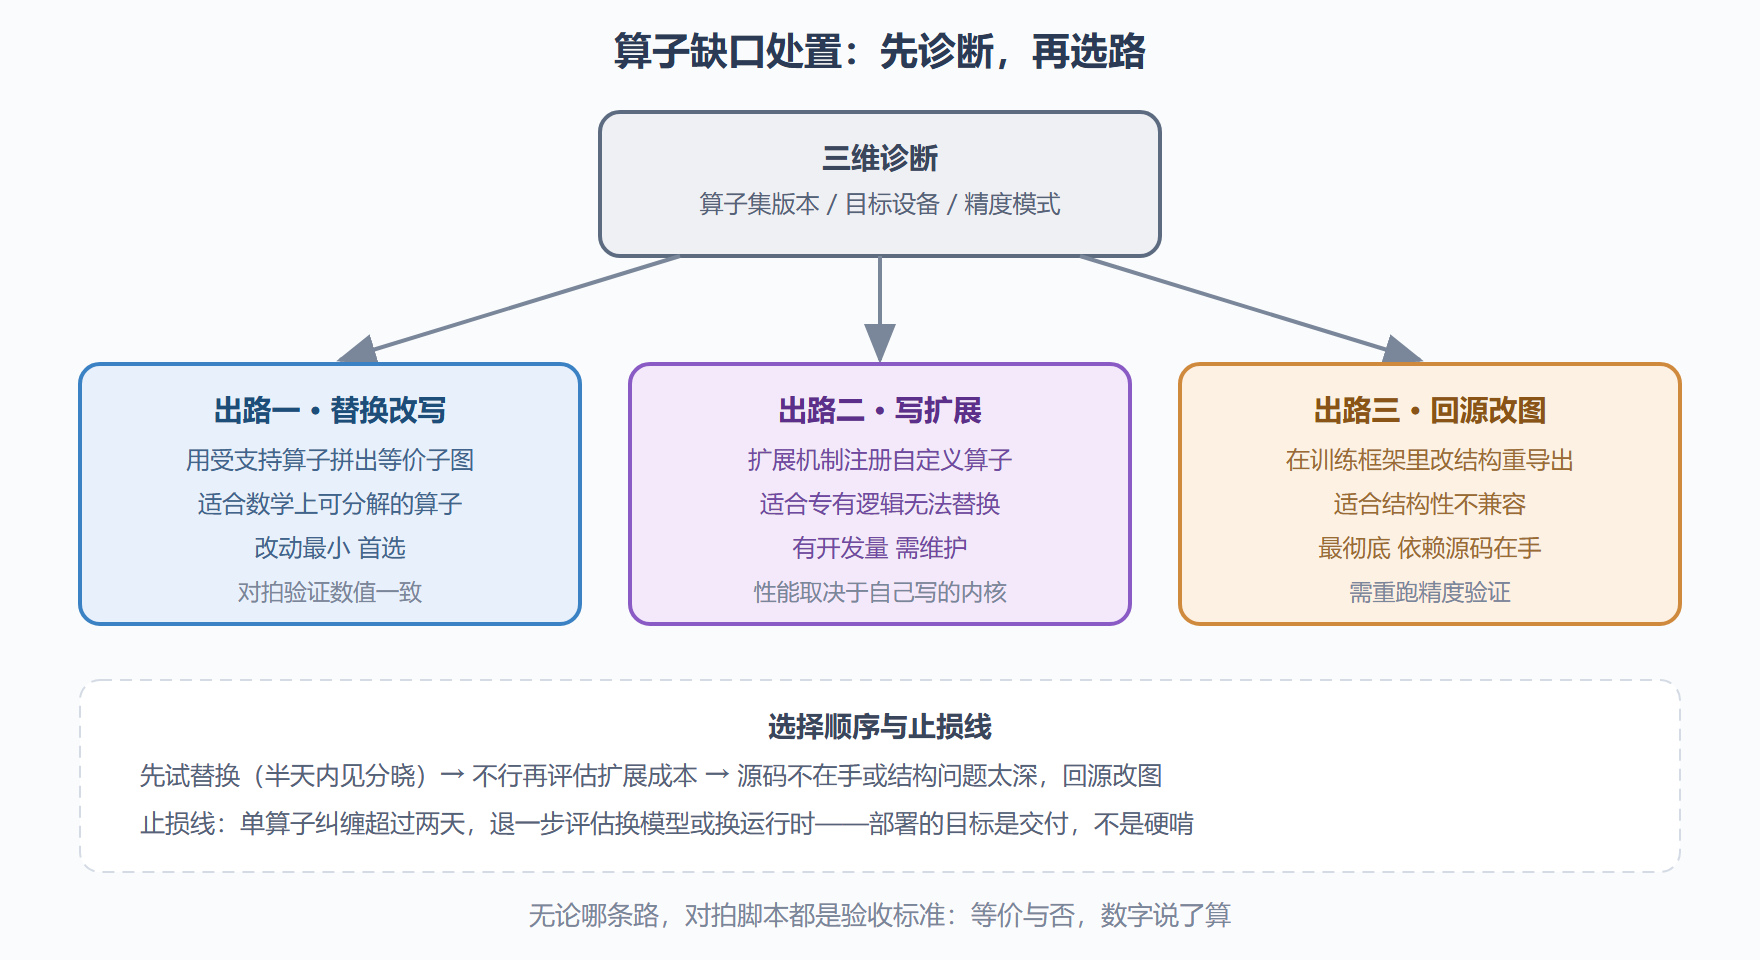
图 2-3 算子不被支持时的三条出路
二、出路一:替换与改写,多数问题的正解
数学上可分解的算子,用受支持的原子算子拼出等价子图,是改动最小、风险最低的路。典型场景:某个新式激活函数不被老版本算子集支持,用乘法与 sigmoid 原语组合即可等价替换;某些框架特有的归一化实现,用标准的归一化算子加仿射变换重写。
替换发生在哪一层有讲究。最外层是源框架层面——在 PyTorch 代码里把模块换掉再导出,转换器天然无感;中间层是转换期改写——部分前端提供转换钩子,把特定模式映射为等价子图;最内层是对 IR 做后处理。三层的取舍标准是「谁最接近你的维护边界」:改训练代码影响算法同事,改 IR 影响可维护性,多数团队落在源框架层。
无论在哪层替换,验收都靠 2.1 节建立的对拍脚本:同一批输入下,原模型与替换后模型的输出偏差必须在容忍范围内。替换是数学等价的游戏,数字不认口头保证。
三、出路二:扩展机制,给专有逻辑开门
遇到无法用现有算子组合表达的专有逻辑——自研的定制层、领域特有的后处理——OpenVINO 的扩展机制允许注册自定义算子:声明算子的形状推导规则,并为目标设备提供实现。现代版本鼓励用前端扩展的方式在图层面定义,再挂接设备内核。
# 扩展注册的骨架示意:形状推导 + 实现挂接 from openvino import Core, ExtensionAtom # 概念示意,实际接口随版本演进 core = Core() # core.add_extension(...) 将自定义算子定义注入运行时 # 之后 read_model 遇到该算子即可正常解析与编译
写扩展是一把要慎用的刀。它解决了眼前问题,却带来三笔长期成本:算子实现是你自己维护的 C++ 代码;每个目标设备可能各要一份实现;运行时升级后扩展要跟着适配。我们的建议是先问一句「这个算子能否拆解」——十有八九能拆,剩下的一成再谈扩展。第 3 章讲运行时架构时会看到,扩展机制本质上是插件体系向开发者开放的那一部分。
四、出路三:回源改图,结构性不兼容的正解
第三条路最重也最彻底:回到训练框架,改模型结构,重新导出。适合的场景是结构性不兼容——控制流写法让图无法静态化、动态轴散布在编译器无法收敛的位置、或者干脆是导出时的已知缺陷。此时在源头改十行代码,好过在部署侧纠缠两周。
这条路的前提是源码在手、且改动能过算法同事的精度验收。工程协作上值得立一条规矩:模型导出前,部署侧提供一份「部署友好的结构建议清单」——静态形状、受限动态轴、避免冷门算子——让兼容性问题死在设计阶段,而不是联调阶段。这份清单会随着你的部署经验增长,第 7 章的全链路工作流会把它纳入流程模板。
一次算子替换的完整作业单
把出路一的执行细节摊开看。某分割模型用了框架自定义的门控激活算子,转换器在此中断。作业单如下:第一步查版本——当前工具链的算子集里确实没有它,但提供了乘法与 sigmoid 两类原子算子,数学上门控激活可以拆成两步组合。第二步选层——在源框架里把该模块替换为等价组合,改动了三行代码。第三步对拍——2.1 节的脚本全量跑,最大相对偏差在浮点舍入量级,数值等价成立。第四步回归——精度评测持平,性能无损(组合子图被运行时的融合pass合成一个内核,没有拆解开销)。全程半天,零扩展代码。
作业单里最值得强调的是第四步的意外收获:融合机制让「拆开的等价实现」未必更慢。运行时的图优化会主动寻找可融合的模式,替换实现恰好构成标准融合模式时,性能与原算子几乎一致。所以「替换会掉性能」的担忧多数时候不成立,先测再说。
扩展机制的适用边界再收一步
鉴于扩展机制的长期成本,把「什么时候真的该写扩展」再收窄一层。满足以下全部条件才值得动笔:算子数学上不可拆解(或拆解后精度不可接受);业务上必须用这个模型(没有可替换的模型);算子有稳定的设备实现路径(自己有把握写对数值与边界);有人力接下「随运行时升级维护扩展」的长期承诺。四条缺一条,答案都应该是换路——换模型、换运行时、或回到源头改设计。我们见过的扩展代码,一年后仍在被使用的不到三成;多数扩展的真实结局是「当时救火,下个迭代连模型一起被换掉了」。把这份统计放在决策桌上,能拦住不少英雄主义。
最后补一个工具性提示:写扩展前先确认算子缺口没有现成解——社区扩展仓库与官方扩展包覆盖了一部分常见的自定义算子(特殊的池化变体、经典的自定义激活),先找现成轮子,再考虑造轮子。搜索的时间成本几乎为零,值得排在作业单第一步。
三个高频追问
算子话题收尾,回答三个高频追问。追问一:升级工具链后,之前替换过的算子官方支持了,要改回来吗?不必急——等下一个常规迭代窗口,把替换实现换回原生算子,跑对拍与基准后一并发布;原生实现通常有更好的融合与调度适配,值得换,但不值得为它单独冒险发版。追问二:同一模型在不同设备上算子支持不同,要维护多套 IR 吗?优先维护一套 IR 加设备各自的编译配置,只有当某设备的算子缺口必须用不同图结构弥补时才分叉 IR——分叉的维护成本要在立项时就想清楚。追问三:怎么提前知道自己的模型有没有算子风险?转换一次全设备编译一遍,就是最便宜的普查;发布前的设备矩阵编译检查(目标设备列表逐个 compile)值得写进流程,五分钟暴露九成的算子缺口。三个追问的落点一致:算子管理是持续动作,不是一次性的救火。
本节要点回顾
- 算子支持是三维命题:算子集版本、目标设备、精度模式,报错时逐一核对坐标。
- 三条出路排序:替换改写是首选,扩展机制慎用,回源改图处理结构性问题。
- 扩展机制的隐含成本:自维护内核、多设备实现、随版本升级适配,非必要不写。
- 对拍脚本是通用验收:任何等价性声明都要过数字这一关。
到此第 2 章走完「怎么转、转成了什么、转不动怎么办」的完整闭环。第 3 章进入运行时内部:Core、CompiledModel、InferRequest 的对象体系怎么用,内存怎么流转,调度策略怎么配。