6.1 多语言开发框架
6.1 多语言开发框架
本节摘要:OpenVINO 以 C++ 为原生内核、Python 为一等绑定,另有 C、Java 等多语言接口;所有语言共享同一套运行时行为。本节讲清各绑定的成熟度差异与选型方法,给出同一推理逻辑的两种语言对照,并说明混合栈的职责切分。
前五章的示例几乎都是 Python,但真实项目里推理代码往往长在别人的语言里:产线质检是 C++ 的天下,企业后台围着 Java 转,云原生编排偏爱 Go。这一节回答「模型如何进入任何一门语言的技术栈」,以及更重要的——哪些地方语言选择真的要紧,哪些地方无所谓。
一个内核,多副面孔
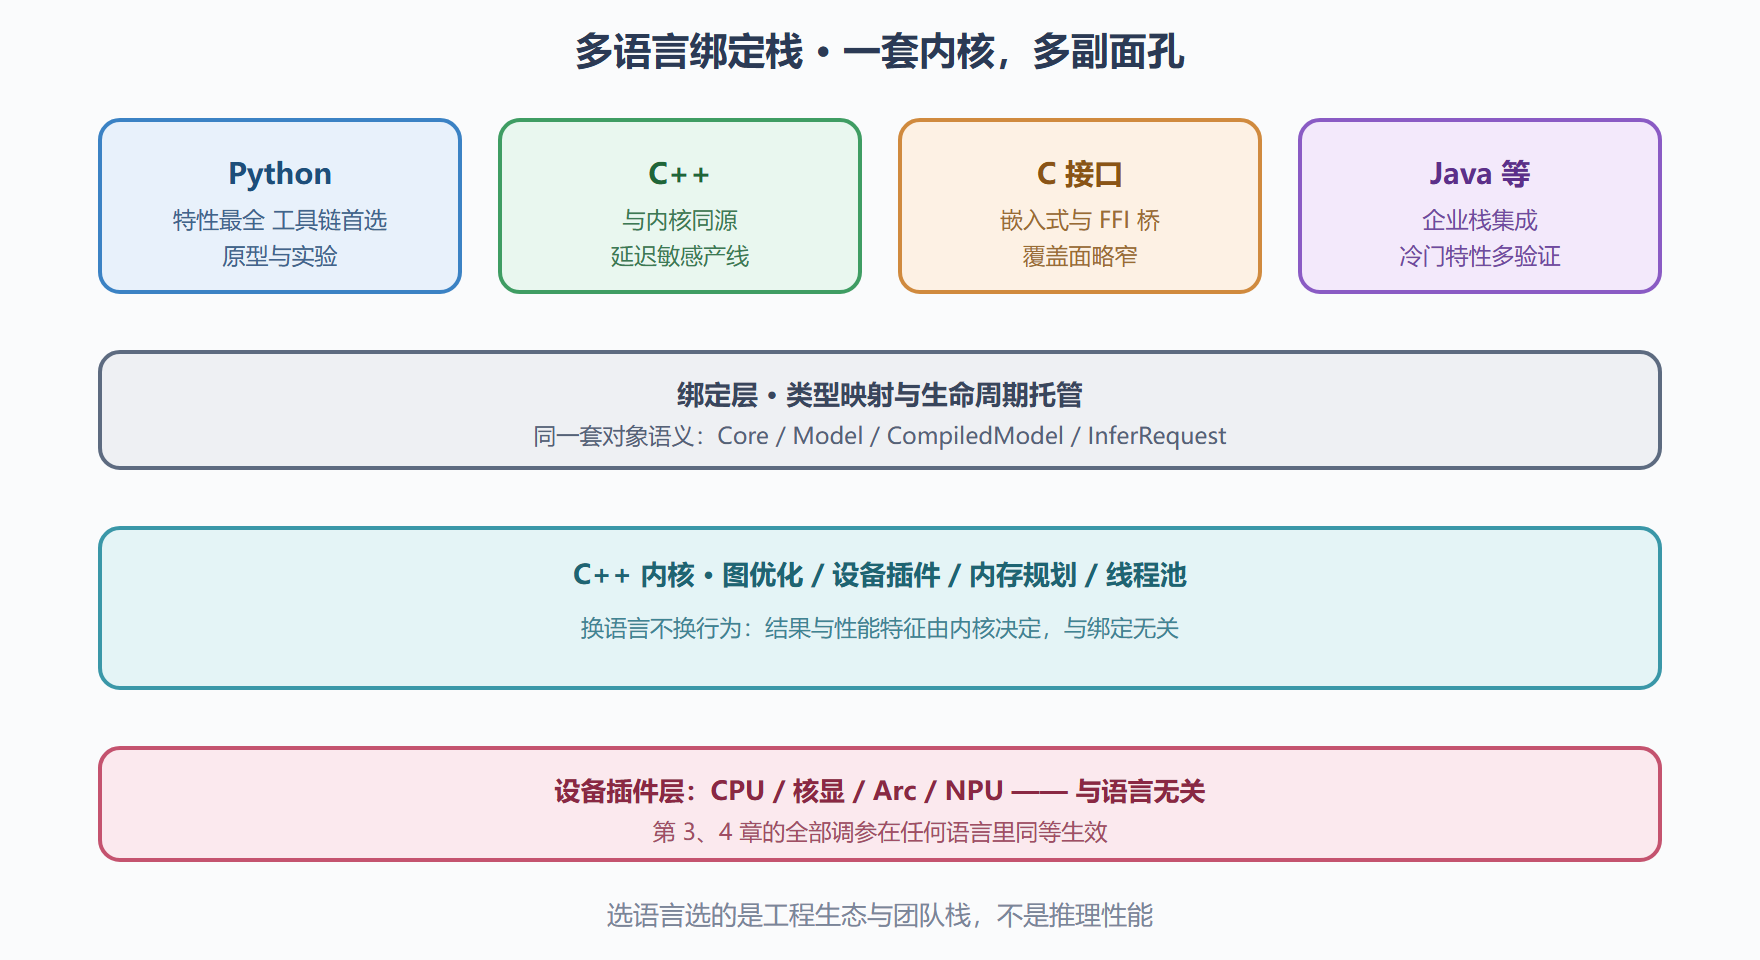
OpenVINO 的多语言策略不是各语言各造一套,而是一套 C 内核加多层薄绑定:图优化、设备调度、内存管理全部住在 C++ 内核里,其他语言通过接口层调用。这个设计有个重要推论——换语言不换行为:同一模型、同一设备、同一参数,Python 与 C++ 的推理结果与性能特征一致,性能差异只可能来自调用侧的写法(比如 Python 里多了一次不必要的内存拷贝)。
各绑定的成熟度并不均等。Python 绑定最完整,全部新特性先落地于此,原型与工具链几乎都是 Python 优先;C++ 绑定与内核同源,零额外抽象,延迟敏感场景的标配;C 接口面向嵌入式与 FFI 场景,覆盖面略窄;其余绑定(如 Java)由社区与官方共同维护,主流功能可用的概率高,冷门属性要多验证。选型时把「要用到的具体接口」列出来逐项核对绑定支持度,别凭「官方说支持」四个字签合同。
图 6-1 多语言绑定栈与职责切分
同一段逻辑的两种写法
用「加载、编译、同步推理」这条最短路径做对照,两个语言的词汇表几乎一一对应:
# Python 版 import numpy as np import openvino as ov core = ov.Core() model = core.read_model("model.xml") compiled = core.compile_model(model, "CPU", num_requests=4) results = compiled([np.zeros((1, 3, 224, 224), dtype=np.float32)])
// C++ 版 #include "openvino/openvino.hpp" ov::Core core; auto model = core.read_model("model.xml"); auto compiled = core.compile_model(model, "CPU", ov::num_requests(4)); ov::Tensor input(ov::element::f32, ov::Shape{1, 3, 224, 224}); auto results = compiled.request(0).infer(input);
对照的价值不在语法,而在排错时可以互相当词典:Python 侧报的属性错误,到 C++ 文档里按同名属性检索即可。真正的语言级差异有两处——C++ 要求显式管理张量生命周期,异步回调里持有的对象要自己保证存活;Python 侧则要留意绑定层的隐式拷贝,大张量反复跨越边界时把拷贝账算清(3.2 节的零拷贝三条件在任何语言同样成立)。
混合栈的职责切分
成熟团队的常见形态不是「选一门语言」,而是按层切语言:算法验证与工具脚本在 Python,因为迭代速度就是产出;产线服务在 C++,因为延迟确定性与部署体积重要;外围系统(调度、监控、业务逻辑)留在团队的主栈语言里,通过服务边界与推理组件通信。语言切换点放在进程边界或服务接口上,而不是在同一进程里来回跨绑定——跨语言的进程内调用链会让内存所有权变得难以推理,排错成本远超收益。
配套一条团队纪律:推理代码封装成与语言无关的内部组件(动态库或服务),对外暴露的契约只有张量规格与配置项。这样语言选择从「架构决定」降级为「组件实现细节」,未来换语言只换一层皮。
绑定层的生命周期细节
「一套内核多副面孔」的架构里,绑定层负责把内核对象的生死翻译成各语言的规则——这里藏着多语言使用最常见的坑。Python 侧的垃圾回收是自动的,但被回收的只有绑定对象;它引用的内核资源由引用计数管理,循环引用或被回调持有的对象可能晚于预期释放。C++ 侧是显式的所有权语义,对象在作用域结束时释放——写异步推理时,回调里捕获的对象必须保证「回调触发时仍活着」,悬垂引用在多线程下表现为偶发崩溃。C 接口干脆把释放责任交给调用方,配对的创建与销毁调用要靠纪律。三种语言三条规则,共同点是:谁持有、谁释放,必须在设计时写清楚。我们的建议是把对象所有权画进组件接口文档——一张谁创建谁销毁的小表,能省掉多语言团队一半的内存相关扯皮。
数组跨越边界的那道门
另一个集中出问题的位置是数据跨越语言边界:numpy 数组、C++ 容器、Java 字节数组之间的转换。每一次跨边界的数组传递都可能是引用也可能是拷贝——取决于绑定与内存布局是否匹配。判断的依据就是 3.2 节的张量四要素:类型、形状、布局、设备上下文全部对得上才可能零拷贝,差任何一项就退化为拷贝。工程上的省心做法是在组件边界统一数据契约:进入推理组件前先转成约定的数组格式,组件内部不再做第二次转换。多一次显式转换看起来「多余」,实际把 N 次隐式拷贝换成了 1 次显式拷贝——大分辨率输入下这笔账是毫秒级的。
混合栈的一单实例
用一个实例把「按层切语言」写实。某三坐标测量机厂商的视觉质检改造,最终栈是三层:算法组用 Python 完成模型验证与量化流程,产出 IR 与预处理配置;设备层用 C++ 写了一个推理动态库,封装加载、请求池与零拷贝采集对接,暴露纯 C 接口;厂里既有的 C 主程序通过这个接口调用推理,业务逻辑一行没动。改造周期六周,其中 C++ 动态库只占一周半——大量时间花在前期的接口契约评审上。团队复盘说:这个项目的架构决策其实只有一条——「推理细节不许泄漏到既有主程序里」,其余都是执行。混合栈的正确心智模型就是如此:不是「我们会三种语言」,而是「边界划得够好,每种语言只做它最擅长的那一层」。
三个高频追问
多语言话题收尾,回答三个高频追问。追问一:Go、Rust 这些新兴语言怎么接入?两条路——走 C 接口的 FFI 绑定(社区已有若干成熟封装),或把推理做成独立服务走网络调用;计算密集的推理本体不因宿主语言而异,选型关键在绑定维护活跃度与团队运维能力。追问二:Python 的性能损失到底有多大?调用开销本身是微秒级,可忽略;真正的损失来自「数据在 Python 侧多绕一手」——不必要的格式转换、逐元素循环、多余的拷贝,把数据路径设计好,Python 与 C++ 的端到端差距通常在一成以内,远小于换模型或换设备的收益。追问三:多语言团队怎么统一调试?日志与指标的口径先统一——所有语言的推理组件输出同一格式的结构化日志(请求标识、耗时分段、配置快照),跨语言问题才有线索可追;语言不同的组件之间,靠日志对时比靠断点联调便宜十倍。三个追问的共同答案:语言是工程组织问题,不是性能问题——把数据路径与日志口径设计好,语言栈随便组合。
本节要点回顾
- 一套内核多副面孔:所有绑定共享同一运行时行为,换语言不换结果与性能特征。
- 成熟度分层:Python 全、C++ 纯、C 嵌入式、其他绑定逐项核验后再依赖。
- 按层切语言:验证在 Python、产线在 C++、外围留主栈,切换点放边界不放进程内。
- 契约无关语言:推理组件对外只暴露张量规格与配置,语言是细节不是架构。
组件有了归宿,接下来是让它变成网络服务:模型怎么被远端调用、版本怎么管、并发怎么扛——6.2 节讲服务化部署。