6.2 服务化部署
6.2 服务化部署
本节摘要:模型从「能跑」到「可用」隔着服务化这道坎:接口契约、模型版本管理、并发与批处理、健康检查。本节对比「自嵌推理的微服务」与「现成模型服务器」两条路线,给出选型判据与一条可落地的服务化清单。
6.1 节解决了「模型进入任意语言」,这一节解决「模型被很多调用方共享」。单机脚本与服务化之间隔着的不是 HTTP 那一层皮,而是一整套工程责任:谁保证并发安全、谁管模型版本、谁扛流量洪峰。把这些责任想清楚,两条部署路线的取舍就自然浮现。
服务化的四项责任
把「写个接口包住推理」升级为「提供服务」,至少要接住四件事。
接口契约:输入输出的结构、取值范围、错误码全部成文且版本化。调用方不需要知道模型内部——归一化方式、布局约定这些 2.1 节反复强调的隐式契约,必须在接口文档里显式落账,否则精度事故只是时间问题。
模型版本管理:灰度发布与回滚的前提是「同一服务能同时挂多个模型版本」。评估新模型时新旧版本并行在线、按流量比例分流,是最小风险的验证方式。
并发与排队:推理是计算密集型资源,来多少请求处理多少请求会把设备压垮。服务层要显式设计并发度——通常等于设备流数或其倍数——超出的请求排队,排队的深度与超时策略决定过载时的行为(缓慢变慢还是快速失败)。
可观测性:延迟分位数、每秒处理量、错误率、设备利用率,四个指标是服务健康的最小集。没有度量的服务上线等于盲飞,第 7 章的工具链在这里直接复用。
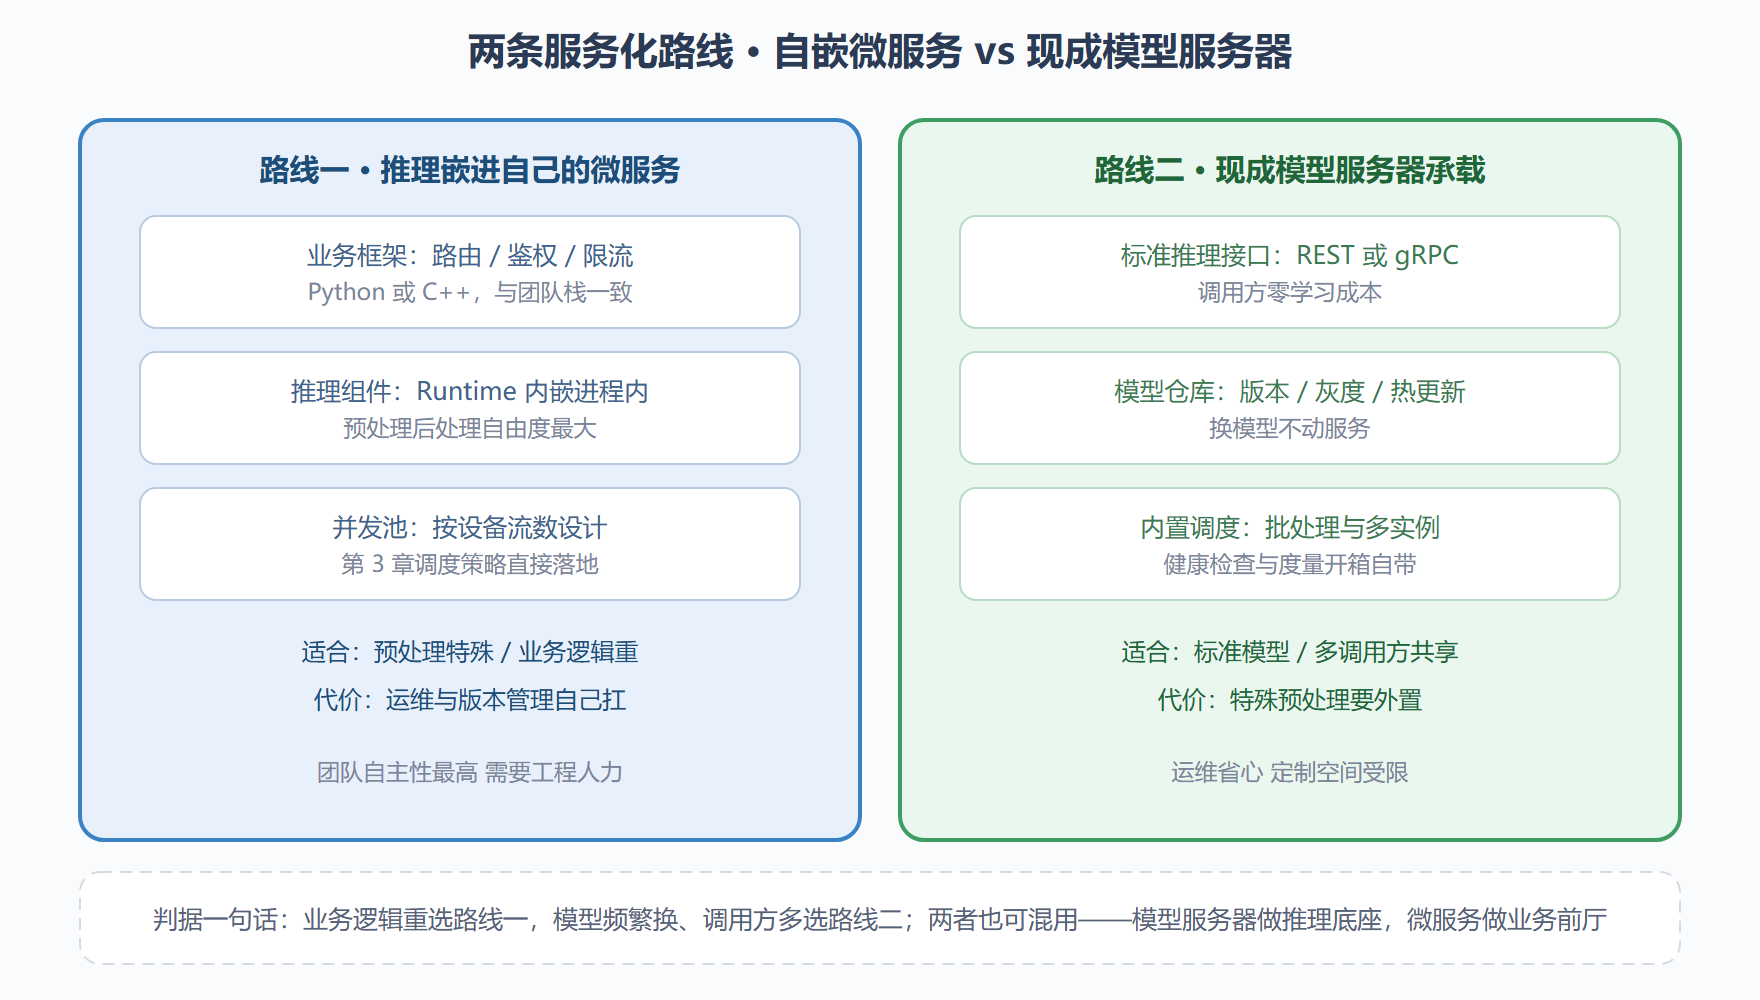
图 6-2 两条服务化路线的结构对比
路线取舍:三个问题定方向
业务逻辑有多重? 预处理涉及多模型级联、结果要和业务数据库强耦合的,逻辑长在自己代码里更顺,选路线一;纯粹的「图进、结果出」标准推理,模型服务器直接覆盖,选路线二。
模型换得多勤? 每周迭代的场景,模型服务器的仓库化管理与热更新价值巨大——换模型不动服务、不重新发版,这正是它设计的主场。模型一年一换的服务,这层管理的边际价值不大。
调用方有多少个? 一个服务只喂自家一个应用,进程内直连最简单;模型被五个以上调用方共享时,独立模型服务器把「每个调用方各自嵌推理」的重复建设合并成一处,版本一致性问题也一并消失。
三个问题答完仍拿不准时,从路线二起步的试错成本更低:标准接口先跑通业务,性能或定制瓶颈出现后再下沉到路线一——反向迁移(从定制服务迁回标准服务器)要痛苦得多。
落地清单:上线前的八项检查
无论哪条路线,上线前把这份清单过一遍:接口契约文档含错误码;并发度与设备流数对齐并有压测数据;排队深度与超时策略明确;模型版本可查可回滚;健康检查端点就绪;延迟分位数有监控告警;日志含请求标识可追踪;灰度方案演练过一次。八项全绿再放流量——这份清单本身没有一项涉及模型精度,全部是工程责任,而这恰恰是服务化事故的高发区。
并发设计的账:一道例题
四项责任里的「并发」最抽象,做一道例题。假设设备在吞吐模式下可承载三路并发推理,单路推理 20 毫秒;业务峰值每秒 300 个请求。设计推算:设备理论上限是三路乘以每秒五十次等于每秒 150 次——峰值超出容量一倍。选项有三:横向加实例(资源翻倍),请求排队(峰值延迟飙升,超时率上升),或者把推理降频优化(量化换容量)。多数团队的实际选择是组合拳:量化把单路推理压到 12 毫秒,理论上限升到每秒 250 次;再设排队上限每秒 280,超出部分快速失败并引导客户端重试——明确的拒绝好过无限的变化慢。这道例题的通用解法:先测单路容量,乘以并发路数得理论上限,对照业务峰值定排队与降级策略。数字推演十分钟,胜过上线后与流量搏斗十夜。
版本管理的最小实现
「模型版本管理」不需要重型系统,最小实现三件套就够。其一,模型目录带版本号:模型仓库里每个版本独立目录,服务配置只引用版本号,回滚等于改一行配置重启。其二,版本元数据落档:每个版本附一份来源档案——源模型版本、转换参数、量化配置、精度评测摘要,让「线上跑的是哪个东西」永远可回答。其三,灰度开关:按流量比例把请求导到新版本,出错先降比例再回退。三件套实现成本低到半天,却是 7.3 节三道闸门的落地前提——闸门拦住坏版本的前提,是你能一键退回好版本。反过来,没有版本管理的服务,任何一次「模型更新」都是赌博:坏了不知道退到哪,好了不知道好在哪。
可观测性:四个指标的采集姿势
四项指标补采集姿势。延迟分位数在服务侧记录每个请求的端到端耗时与纯推理耗时两个数——差值暴露的是服务开销而非模型问题;吞吐按滑动窗口统计并区分空载与满载时段;错误率要分类计数(参数错、超时、设备错各算各的),混在一起的错误率没有诊断价值;资源水位采设备占用与进程内存,采样频率一分钟足够,太密了反而干扰业务。四类指标各配一条告警线,阈值来自压测数据而非拍脑袋。第 7 章的工具链负责「深挖」,这里的四指标负责「站岗」——站岗发现问题,深挖定位原因,两层配合才完整。
三个高频追问
服务化话题收尾,回答三个高频追问。追问一:模型服务器会不会成为性能瓶颈?标准推理接口的序列化与转发开销通常在毫秒级以内,对绝大多数推理负载(十毫秒以上)可忽略;只有亚毫秒级超低延迟场景才需要进程内直连——先用 7.1 章的工具测出推理本体耗时,再判断这层开销是否要紧,别凭感觉否定路线二。追问二:多个模型能共用一个服务实例吗?能且推荐——同一容器编排多个模型是模型服务器的基本能力,共享运行时与设备上下文比每模型一实例更省资源;要管理的是互相干扰:一个模型的流量尖峰挤占另一个的算力,靠实例内配额或拆分实例解决。追问三:服务化后精度出问题怎么定位?按 6.2 节的接口契约倒查——先确认客户端发送的数据符合契约(预处理归谁、取值范围),再对比「契约内数据」的服务端输出与本地直跑输出;契约内一致则问题在客户端,不一致则问题在服务端配置。三个追问的共同提醒:服务化的每个问题都有工程解,前提是契约与度量先行。
从脚本到服务的一次真实跃迁
用一次真实的「脚本转服务」经历把全节串起来。起点是一个验货员自用的检测脚本:单线程、命令行交互、模型路径写死。第一次升级是给同事共用:加了简单的接口——这一步没有增加任何并发设计,上线当天就被三个人的同时使用打崩,两个请求交织在同一个 InferRequest 上输出错乱。第二次升级补齐并发:按 3.1 节的纪律建了请求池,接口层排队;稳定两周后,第三步补版本管理——模型迭代时新旧并行灰度,回滚从「手忙脚乱换文件」变成「改一行配置」。第四次才轮到可观测性:延迟分位数告警上线后,团队第一次在用户抱怨之前发现了性能劣化。四次升级的顺序并非规划,而是被事故推着走完的——本节把四项责任前置成设计输入,就是想让读者不必再被推着走一遍。
本节要点回顾
- 四项责任:契约、版本、并发、可观测,接不住就不算服务,只是带网络的脚本。
- 两条路线:自嵌微服务换自由度,模型服务器换省心,按业务重量、迭代频率、调用方数量定。
- 从标准起步:拿不准先上模型服务器,瓶颈出现再下沉定制,反向迁移更痛。
- 八项清单:服务化事故高发在工程责任区,上线前逐项核对。
服务立起来了,模型住在哪台机器上、数据在哪里被计算——这引出部署拓扑的最后一块拼图:边缘与云端怎么分工。6.3 节展开。