8.2 Embedded Coder优化实战
8.2 Embedded Coder优化实战
本节摘要:8.1 节的代码能跑,但目标芯片的预算是紧的:闪存多大、RAM 多少、中断里允许几微秒。本节按"测量、优化、复测"的节奏过一遍嵌入式优化实战:存储段配置把数据归位、表达式优化压缩体积、定点化替掉浮点依赖。每项优化都给代价说明——优化是资源预算的再分配,不是免费午餐。
从一份资源账单开始
优化的第一步不是开开关,是测量。把 8.1 节的代码编译到目标机,拿到三组数:代码体积(Flash 占用)、数据体积(RAM 占用)、步进函数执行时间(用定时器或仿真器测)。小林的电机控制第一次账单:Flash 12 KB、RAM 2.1 KB、1 毫秒任务里步进函数耗时 38 微秒。预算上限:Flash 16 KB、RAM 4 KB、任务耗时不得超过 100 微秒——三项全部达标,但主频更低的低成本版本芯片(预算 Flash 8 KB)过不了 Flash 一关。优化的目标由此明确:压体积,其他指标留足余量。
这份"先有账单再有动作"的流程值得强调:没有测量的优化是许愿,改完不测的优化是赌博。
存储:让每样数据住对地方
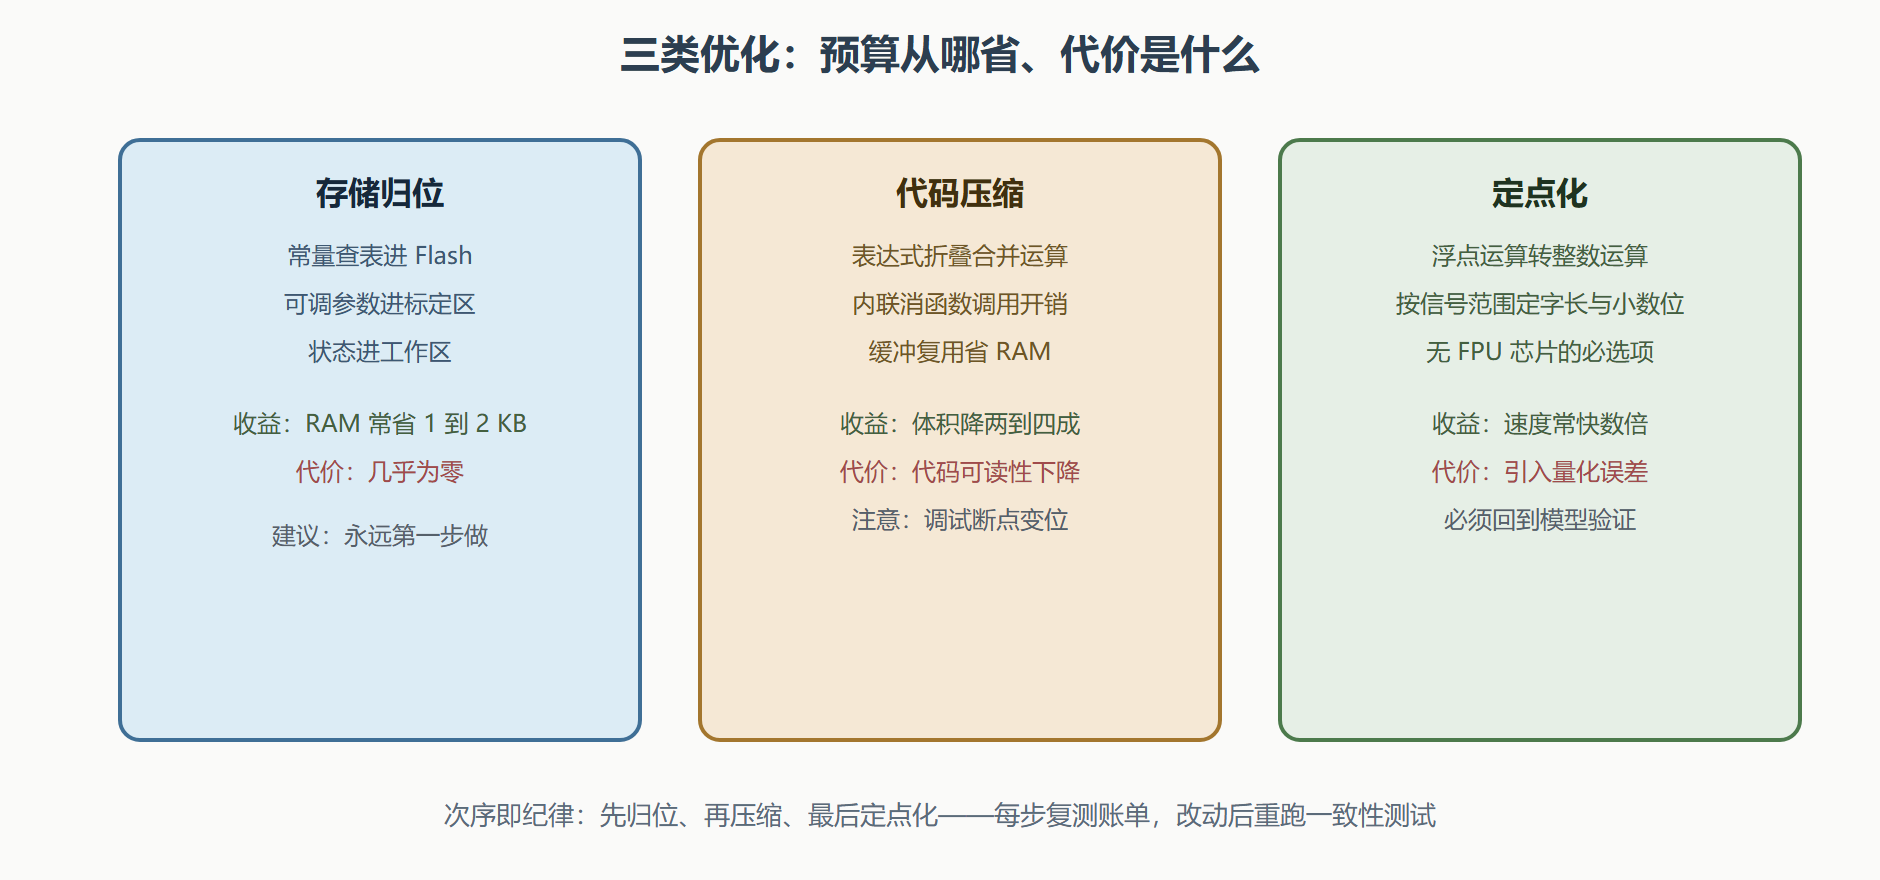
存储优化收益最稳。生成代码的数据分四类去处:常量(查表、固定系数)进 Flash,可调参数进 RAM 的标定区,状态变量进 RAM 的工作区,临时变量由编译器寄存器或栈消化。存储类配置决定去处——8.1 节的规则三在此展开成预算管理。实测中常见的冤枉账:默认配置把一张 512 点的查表参数编进了 RAM,按常量存储类归位到 Flash 后,RAM 直接省下 2 KB;又比如矩阵运算的临时缓冲没被编译器识别出复用机会,手工调整模块配置后栈占用减半。
% 优化前后的配置对比(脚本化,可整体切换实验) % 压体积三件套:表达式折叠、内联层级、复用信号缓冲 set_param('motor_speed_loop', ... 'OptimizationBlockReduction', 'on', ... % 死块与恒等块折叠 'OptimizationExprFold', 'on', ... % 表达式合并 'OptimizationInline', 'on', ... % 子函数内联 'OptimizationBufferReuse', 'on'); % 信号缓冲复用 % 存储段:查表参数标为 Const,进 Flash % (存储类在字典对象上配置,见 6.1 节;此处示意模型级开关)
压体积三件套的效果要按模型"体质"而论:模块数多、表达式碎片化的模型,折叠与内联常有百分之二十到四十的体积收益;本身精炼的模型收益有限——这正常,优化收益的上限由模型结构决定,开关只是兑现它。
图:优化三板斧的收益与代价
定点化:无浮点单元芯片的必修课
目标芯片没有浮点单元(FPU)时,每一句浮点运算都被编译成几十条软件模拟指令,38 微秒的任务耗时轻松翻五倍——定点化从"优化项"升格为"必选项"。定点化的思想是把小数变成"定标整数":比如占空比 0 到 1 的范围用 16 位整数 0 到 65535 表达,小数点位置由约定固定,运算全走整数指令。
Simulink 的做法是在模型层声明定点数据类型(fixdt 类型,带字长与小数位),让"定标决策"成为模型的一部分而不是代码生成后的手补。定标的依据来自信号的动态范围分析(仿真记录的最小最大值留裕量),而定点化引入的量化误差必须回到模型验证:把模型切到定点数据类型,重跑第 7 章的基线比对——控制律的行为劣化超差(积分器死区、极限环振荡是定点化的经典病),就要调整字长或改算法结构(如把积分器迁移到误差更大、字长更长的通路)。
优化收尾的仪式是复测三组数、重跑一致性测试:体积达标、执行时间达标、行为与浮点基准的偏差在容差内,三项齐备才算优化完成。任何一项牺牲了其他两项,回退一步重来——优化上的贪心,在三个月后的现场问题里都会连本带利讨回去。
💡 关键直觉:定点化的误差不是均匀的噪声,它在小信号区最毒。积分器与微分器附近的定点行为要专门用小信号激励验证,别只跑额定工况。
定标实战:一次手算演示
定点化最难的一步是定标(确定字长与小数位),拿本节的占空比信号手算一遍。第一步定范围:占空比物理范围 0 到 1,留两成裕量定成 0 到 1.2。第二步定字长:16 位无符号整数有 65536 级,除以范围 1.2,分辨率约 0.000018——占空比的工程精度需求是千分之一量级,16 位绰绰有余,8 位(256 级,分辨率 0.005)则不够。第三步定小数位:范围 1.2 介于 1 与 2 之间,定成"1 位整数加 15 位小数"的无符号定点(Sfix 16 的无符号变体)。三步走完,在模型里把这个信号的数据类型声明为对应的 fixdt 表达式即可。
手算的价值在于建立"字长换分辨率、范围换小数位"的直觉,实际项目里用定点工具的-range analysis-自动扫一遍全部信号的动态范围,再逐个复核边界信号。复核时优先盯三类信号:接近零的(绝对容差要跟上)、变化跨数量级的(固定小数位容易两头不讨好)、进积分器的(累加误差放大一切)。三类信号定好标,其余大多顺水推舟。
常见问题
问:开了优化之后调试断点对不上代码,怎么兼顾?
这是代码压缩的固有代价:表达式折叠与内联把"一个模块一行代码"的对应关系抹掉了。工程做法是分两个构建目标:调试版关压缩优化(体积换可调试性,只在排障时编译),发布版全开。两个目标共用同一模型与同一套配置脚本,差异只在优化开关——8.1 节"配置层脚本化"在此兑现:一条命令在两个目标间切换,不存在手改漏项。
本节要点回顾
- 先测量后优化:Flash、RAM、执行时间三组账单决定优化目标,无测量不优化;
- 存储归位是第一步:常量进 Flash、可调参进标定区,收益稳定代价近零;
- 压缩三板斧:块折叠、表达式合并、内联加缓冲复用,收益两到四成但伤可读性;
- 定点化是定标决策:fixdt 声明进模型、动态范围分析定字长、量化误差必须回模型验证;
- 小信号区最脆弱:积分微分通路专门用小信号激励做定点验证;
- 收尾仪式:复测三组数加重跑一致性测试,三项齐备才算优化完成。
代码又小又快又经得起比对,还差最后一关:在真实控制器与真实时序里,它还认得回自己的行为吗。下一站硬件在环。