1.1 定义与发展历程
1.1 定义与发展历程
本节摘要:Apache Flink 是一个面向无界与有界数据的分布式流批一体计算引擎,核心设计以事件时间语义与内置状态管理为第一原则。本节从一线工程师的视角给出它的精确定义,并沿演化主线梳理从学术项目 Stratosphere 到流批一体时代的各个关键版本,帮你看懂今天生产环境里那些"历史遗留用法"的来龙去脉。
从一条时间线说起
上一章我们回答了"为什么需要流计算",本节是整册知识体系的起点站:先弄清 Flink 是什么、从哪里来。这件事看起来像背百科,其实直接服务于排错——生产环境里的 Flink 集群往往横跨好几个大版本,老作业里充斥着旧 API 的写法,你只有知道每个能力是哪个版本引入的,才能判断一段历史代码当时为什么那样写、现在还能不能改。
故事从二十一世纪的头一个十年讲起并不为过。彼时 MapReduce 把"批处理"做成了工业标准,但研究者很快发现:很多分析任务的输入根本不是静止的文件,而是源源不断到达的日志与事件。柏林工业大学的一个研究项目 Stratosphere 由此转向,专门研究如何用数据流的方式同时表达批与流的分析任务。这个项目在 donated 给 Apache 基金会后更名为 Flink——德语里"灵巧、快速"的意思。它从诞生起就没打算做一个"批处理的补充",而是直接把世界建模为流:文件只是有限长度的流,日志是无边界增长的流,统一处理。
一句话定义与三层展开
给 Flink 下一个工程师版的定义:它是一个把一切数据都看作流、以事件时间为时间基准、以内置状态管理为底座、同时支持无界流处理与有界批处理的分布式计算引擎。
这个定义里的每个短语都值得展开:
- 一切皆流。有界与无界不是两种任务,而是同一类对象的两种长度。一个 HDFS 上的历史文件,是"有终点的事件流";一个 Kafka 主题,是"没有终点的事件流"。引擎的运行时对两者一视同仁,区别只在数据源声明自己是否会结束。这个设计让"昨天跑历史回溯、今天跑实时增量"可以用同一套代码,这是后来"流批一体"叙事的根基。
- 事件时间为基准。每条数据自带它发生时刻的时间戳,计算按事件发生的时间推进,而不是按数据到达机器的时间。这条原则在乱序场景下是唯一能给出可复现结果的方案,第 3 章会把它拆开细讲。
- 状态是底座。聚合要累计、去重要记忆、风控要维护特征——流计算本质上是"带记忆的计算"。Flink 把状态的存储、快照、恢复做进了引擎,而不是甩给外部的 Redis 或数据库。这是它与早期 Storm 最本质的分野。
用一个最小代码片段感受"一切皆流"的写法。同样是读文件,声明是否有限即可切换语义,处理逻辑完全不变:
// 有界流:读一个目录下的历史文件,跑完即结束 FileSource<String> history = FileSource .forRecordStreamFormat(new TextLineInputFormat(), new Path("data/orders_2023")) .build(); // 无界流:订阅 Kafka 主题,持续运行 KafkaSource<String> realtime = KafkaSource.<String>builder() .setBootstrapServers("broker1:9092") .setTopics("orders") .setGroupId("dashboard") .setValueOnlyDeserializer(new SimpleStringSchema()) .build(); // 同一套下游算子,既能吃历史也能吃实时 DataStream<String> stream = env.fromSource(realtime, WatermarkStrategy.noWatermarks(), "orders");
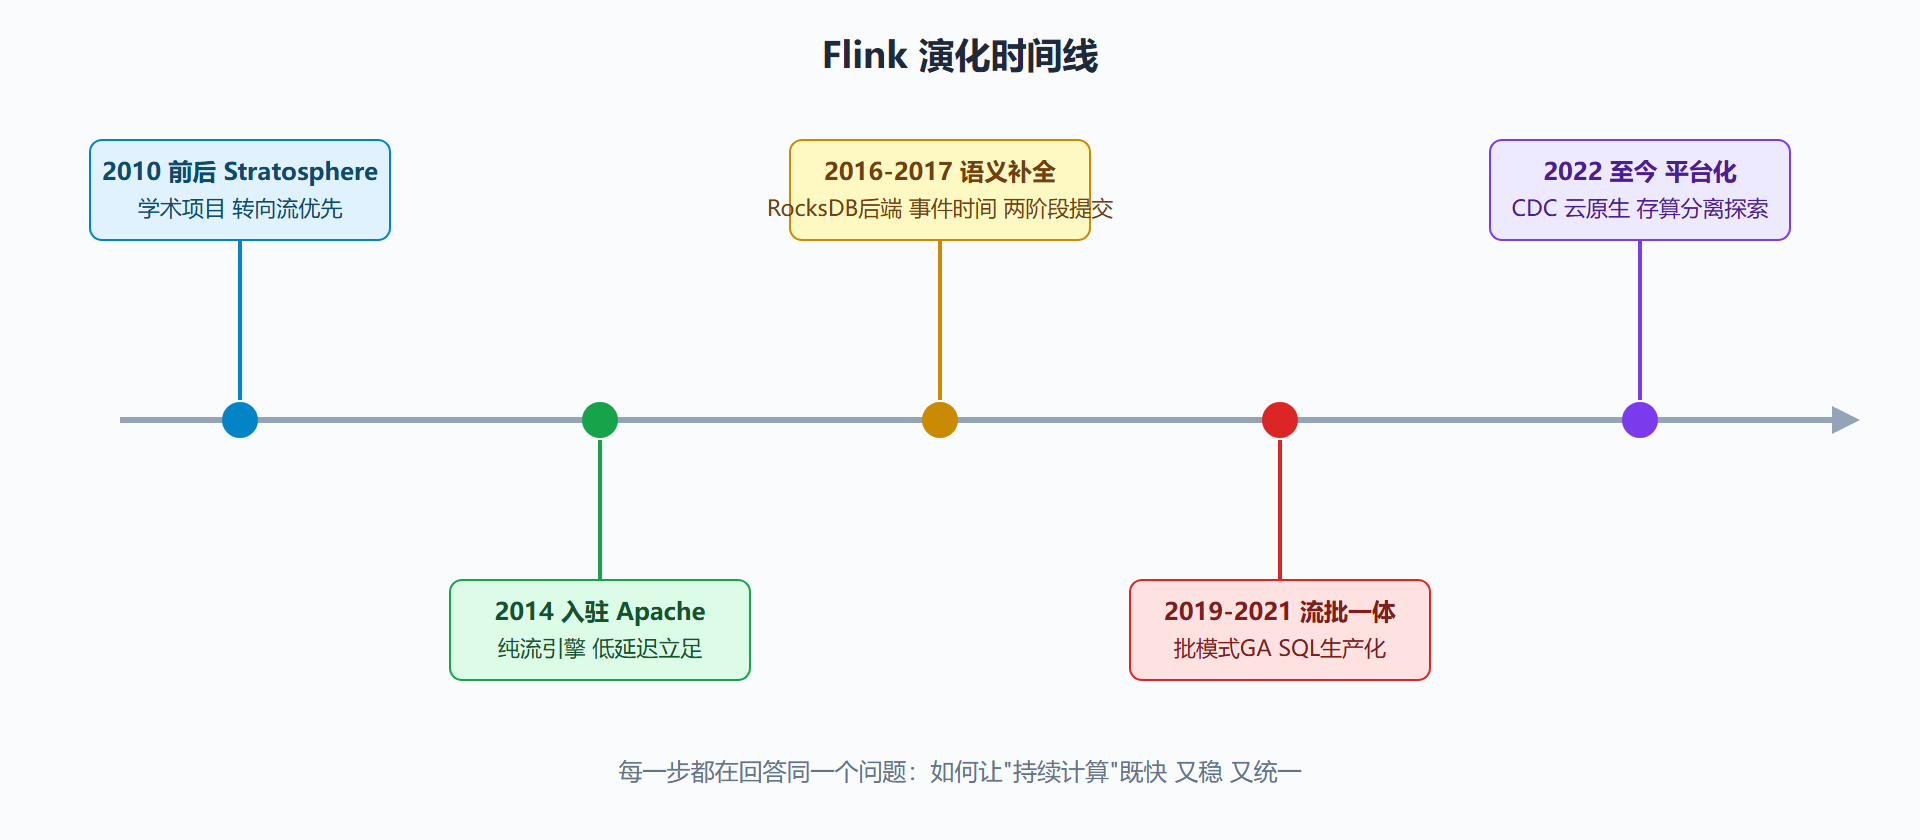
图 1-1 Flink 演化时间线:从学术项目到流批一体
版本演化的三段主叙事
把时间线上的节点归拢起来,Flink 的历史可以压缩成三段叙事,每一段都对应一类你在生产中会遇到的"时代印记"。
第一段:证明纯流可行。当同类项目纷纷选择微批折中时,Flink 坚持纯流执行——数据一条条处理,不攒批。早期它靠低延迟立住脚,但那时的容错开销不小,状态只能放内存,大状态作业动辄内存溢出。今天如果你接手一个老集群,看到作业配置里还有"纯内存状态后端 + 手工定期落库"的写法,那就是那个年代的产物。
第二段:补齐生产语义。RocksDB 状态后端让状态可以落盘、容量摆脱内存上限;事件时间与水位线模型成熟,乱序数据第一次有了系统化的处理框架;两阶段提交 Sink 让"端到端精确一次"从论文术语变成配置项。这三件事是 Flink 从"能跑"到"敢用于关键业务"的分水岭,也是第 3、4 章的主角。
第三段:走向流批一体与平台化。批模式正式可用后,同一套 SQL 既能跑历史数据又能跑实时增量,实时数仓的维护成本骤降;CDC 连接器让数据库变更直接变成流;Kubernetes 运营商让作业部署进入云原生节奏。你今天入职一家公司看到的"实时数仓 + CDC + SQL 化开发"体系,就是这段叙事的产物。
给值班工程师的版本功课
演化史落到自己集群上,就是一道版本管理题。值班视角的三条实务建议值得写在交接文档第一页。其一,摸清家底:集群各组件版本、每个作业提交时用的引擎版本、有没有跨版本混跑——混跑是很多"时好时坏"问题的温床,因为不同小版本的行为差异(比如水位线生成的默认间隔、算子链的合并边界)不会报错,只会让两个看似相同的作业表现不同。其二,升级看迁移日志:每个大版本的升级说明里都列着不兼容项与默认值变化,跳版本升级前把两段之间的迁移说明全部读一遍,比升级失败后回滚便宜十倍。其三,别做第一个吃螃蟹的:新大版本发布后让社区与大厂先趟一个季度的坑,生产集群追次新版本是最稳的节奏。版本策略听起来像管理话题,实际是值班工程师自保的护城河——它决定了你夜里要接的告警里,有多少是"已知问题"。
本节要点
- Flink 的定义核心是三件事:一切皆流、事件时间为基准、状态是内置底座,缺一条都不构成完整的认知。
- 有界与无界是数据的属性而非任务的属性,同一套算子可以同时服务历史回溯与实时增量。
- 演化史的三段叙事——纯流可行、语义补齐、流批一体——分别对应生产环境里三代"时代印记"代码。
- 读老集群时先看版本与状态后端配置,很多"怪写法"是当年能力缺失下的合理妥协。
下一节我们把 Flink 与同场竞技的其他引擎摆上擂台,看看这套设计在横向对比中到底赢在哪、又输在哪。