1.2 核心特性对比:同类引擎擂台赛
1.2 核心特性对比:同类引擎擂台赛
本节摘要:选型不是比谁功能多,而是比计算模型是否贴合业务。本节把 Flink、Spark Structured Streaming、Storm、Kafka Streams 放上同一张擂台,按延迟、语义保证、状态管理、时间语义表达、生态与运维成本五个维度逐一过招,最后给出一张可直接带进评审会的决策清单。
擂台规则:先立三个评判标准
上一节看完了 Flink 自己的演化史,本节要做全册最"横向"的一件事:把它和几位老对手放在一起比。开始前先立规矩,否则对比就会沦为粉丝互喷。一个好的流处理引擎,必须同时回答三个问题:数据晚到了怎么办(时间语义与乱序处理)、机器挂了怎么办(容错与语义保证)、状态变大了怎么办(状态管理能力)。凡是绕开这三问的宣传话术,都可以直接忽略。
参赛选手一共四位。Storm,第一代流处理的代表,条条处理、延迟极低,但生在没有状态与一致性保障的年代。Spark Structured Streaming,批引擎家族的流式延伸,用微批思想兼容了 Spark 生态。Kafka Streams,寄居在 Kafka 客户端里的轻量库,不建集群、随应用部署。Flink,纯流模型的原生代表。还有一个常被点名但本节只放在脚注里的选项——自研,后文会解释为什么大多数团队不该碰它。
五个维度逐一过招
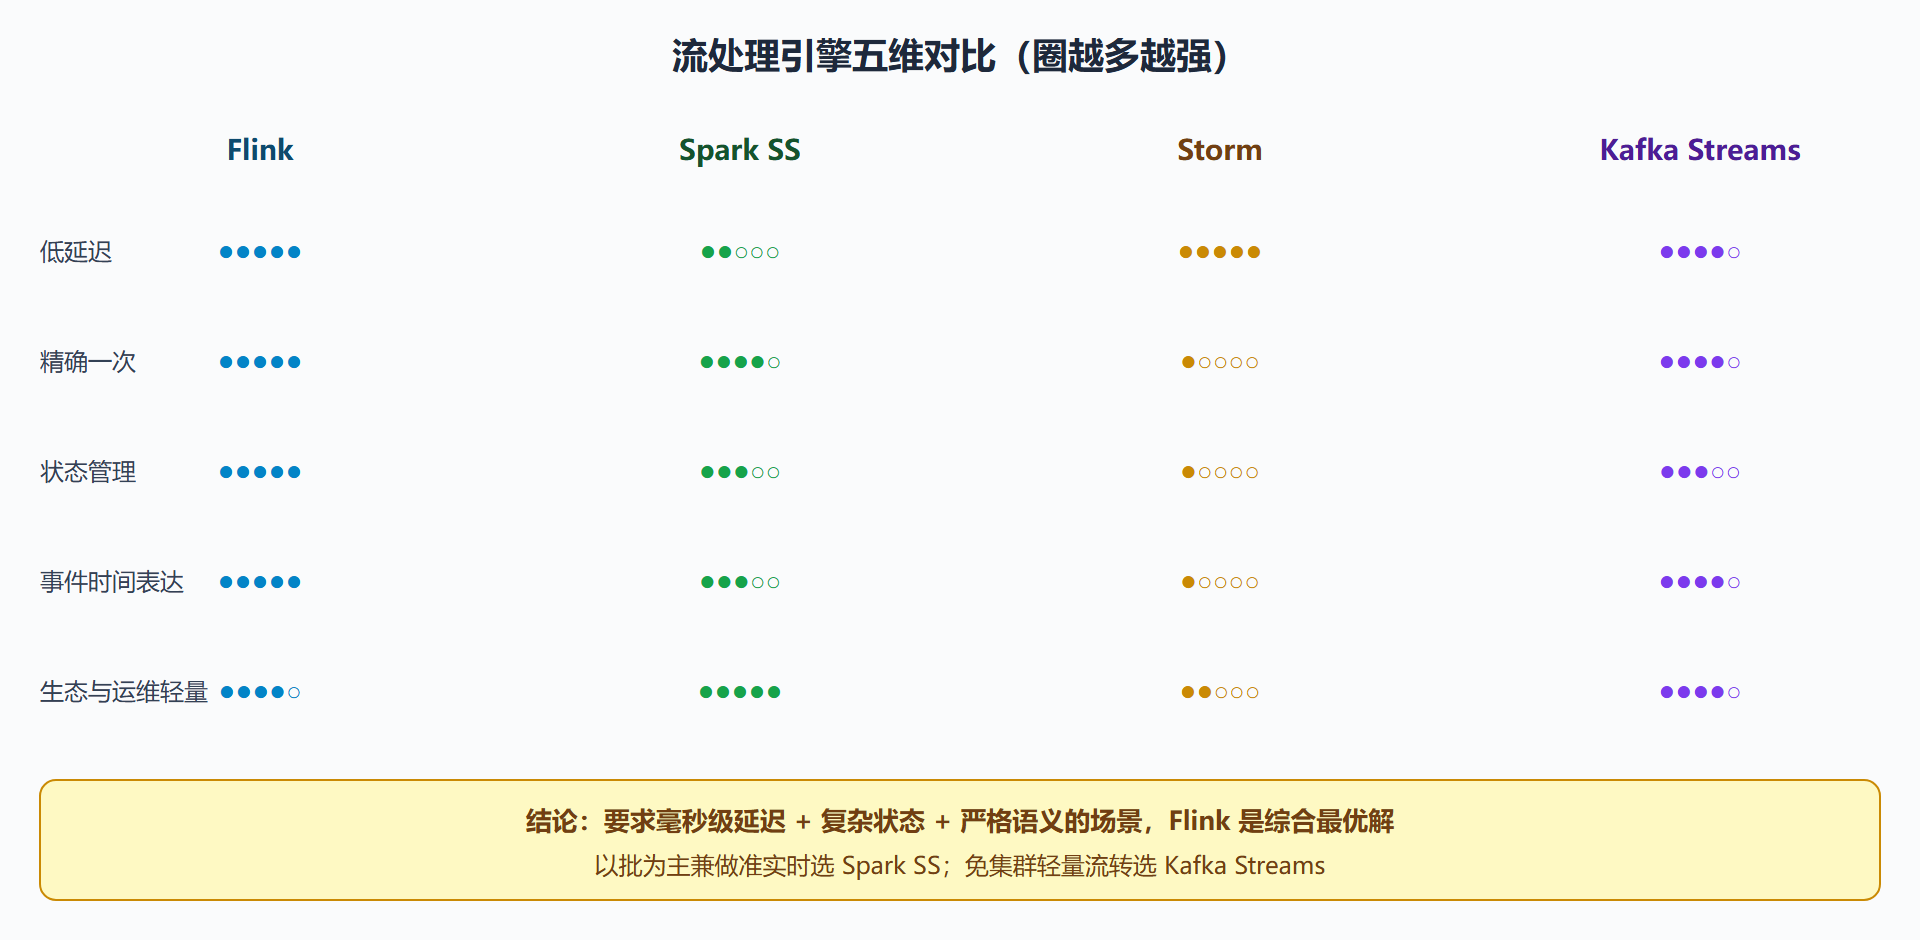
延迟。Storm 与 Flink 都是逐条处理,端到端延迟可以压进几十毫秒;Kafka Streams 取决于消费循环,通常也在毫秒到百毫秒量级;Spark Structured Streaming 的下限被微批间隔卡住,即便触发器调到很短,攒批调度的开销也决定了它更适合秒级场景。大屏、实时风控这类"用户能感知延迟"的业务,这条维度是硬门槛。
语义保证。Storm 原生只保证至少一次,去重要自己做;Spark 与 Flink 都能给出端到端精确一次,但实现路径不同——Spark 靠微批的批间原子性,Flink 靠分布式快照与两阶段提交。语义保证直接决定"故障恢复后报表数字对不对",这是对账时最容易翻车的地方,第 4 章会展开机制细节。
状态管理。Flink 的状态是一等公民:键控状态、算子状态、可增长的状态后端、自动快照恢复一应俱全。Spark 的状态藏在 structured streaming 的聚合算子里,够用但可操控性弱;Storm 几乎没有内置状态,要自己外挂存储;Kafka Streams 把状态做成本地 RocksDB 存储,配合变更日志主题实现容错,思路与 Flink 相近但规模上限受限于单机。
时间语义表达。这是纯流模型与微批模型差距最大的地方。Flink 的事件时间、水位线、窗口是一套原生语法;Spark 的事件时间支持成型较晚,表达跨批次乱序时写法别扭;Storm 在这方面基本空白。业务一旦出现"用户离线补报数据"这类乱序场景,这条维度的差距会立刻显性化。
生态与运维成本。Spark 胜在生态规模与人才储备,批流混部的团队用它最顺;Flink 的连接器与 SQL 生态在实时方向后来居上,但需要维护独立集群;Kafka Streams 免集群运维,但计算逻辑与消费组绑定,扩容和资源隔离都不如独立引擎灵活。
图 1-2 四引擎五维对比矩阵
一张能带进评审会的选型表
图之外,把决策压缩成一张表。评审会上最有说服力的不是"它最强",而是"我们的业务踩中了哪几行":
| 业务诉求 | 首选引擎 | 关键理由 | 典型代价 |
|---|---|---|---|
| 毫秒级延迟 + 严格一致性(风控、大屏) | Flink | 纯流模型 + 分布式快照 + 状态内置 | 需维护独立集群与 checkpoint 体系 |
| 秒级准实时 + 重批处理生态 | Spark Structured Streaming | 与离线数仓共用引擎与人才 | 事件时间表达受限、延迟下限高 |
| 单应用内轻量流转(Etl 入库前的整形) | Kafka Streams | 无独立集群、随应用部署 | 计算能力弱、扩容绑定分区数 |
| 超低延迟但逻辑极简(纯转发、告警过滤) | Storm 或轻量组件 | 部署简单、延迟极低 | 无状态语义保障,功能单薄 |
| 团队只有两三名工程师的自研冲动 | 都不是 | 自研引擎的隐性成本是持续数年的人力 | 语义正确性、容错、生态全部自己扛 |
💡 一个来自值班室的观察:选型失误很少表现为"跑不起来",更多表现为六个月后的维护噩梦——比如用微批引擎扛了毫秒级风控,团队从此在调触发间隔与去重补丁上消磨耐心。
一次真实的选型评审复盘
把擂台知识放到一场真实评审里演练。某公司的选型会背景:团队需要给风控体系补一条实时链路,要求拦截延迟在秒级以内、规则带状态、故障后口径可对账,团队五人,两位熟悉 Spark,一位懂 Kafka。会上出现三个提案,正好对应三种典型思路。提案甲:用现有 Spark 集群加 Structured Streaming,理由是团队熟、不新增运维。提案乙:在 Kafka 之上用 Kafka Streams 嵌进风控服务,理由是不引入新组件。提案丙:新建 Flink 集群,理由是延迟与语义匹配度最高。
用五维擂台逐条过:甲的微批模型在"秒级以内"的延迟要求上压线,事件时间表达在乱序补单场景写起来吃力,但生态与团队分高;乙的轻量路线在状态规模上吃亏——风控要维护千万级卡的特征状态,本地 RocksDB 的规模上限与扩容灵活性都存疑;丙在延迟、语义、状态三维全胜,代价是新增一套集群运维。最终评审的结论是丙,但保留了一条甲方意见:离线侧继续用 Spark,两套体系以数据湖为界互不侵入。这场复盘想说明的是——选型结论不是"谁最强",而是"哪些维度是硬约束、哪些代价付得起";把硬约束先钉死,剩下的比价就只是算术。
本节要点
- 对比引擎先立三问:数据晚到怎么办、机器挂了怎么办、状态变大怎么办,绕开三问的宣传不可信。
- 五维擂台上 Flink 的综合优势集中在延迟、精确一次、状态管理、事件时间表达;Spark 强在生态,Kafka Streams 强在免集群。
- 选型表比排名榜有用:把业务诉求映射到"首选 + 理由 + 代价",评审会才有的放矢。
- 自研流引擎对绝大多数团队是负资产,语义正确性与容错的隐性成本远超想象。
下一节把镜头从擂台转向业务本身:Flink 的场景版图上到底有哪些格子,你的业务又站在哪个格子里。