1.3 应用场景分类:Flink 的能力版图
1.3 应用场景分类:Flink 的能力版图
本节摘要:本节把"流处理"落成五类具体业务——实时数仓与大屏、实时风控、实时特征、CDC 同步、事件驱动应用,逐类分析它们对时间语义、状态规模、一致性的隐性要求,并给出每类场景的关键验收指标。读完你应能把自己的业务放进版图,并知道它会向引擎索要什么。
凌晨告警响起之前
设想这样一个夜晚:大屏上的 GMV 指标停更了,风控同学说交易拦截延迟涨了十倍,数仓那边抱怨实时表和离线表对不上账。三起故障,三条业务线,追到根上全是同一个引擎——Flink 集群里跑着的三个作业。这一幕想说的是:场景决定要求,要求决定架构。不了解自己业务属于哪一类场景,后续所有的架构决策、参数调优都是无的放矢。本节按值班室最常见的五类场景,把版图摊开讲清楚。
五类场景逐一认领
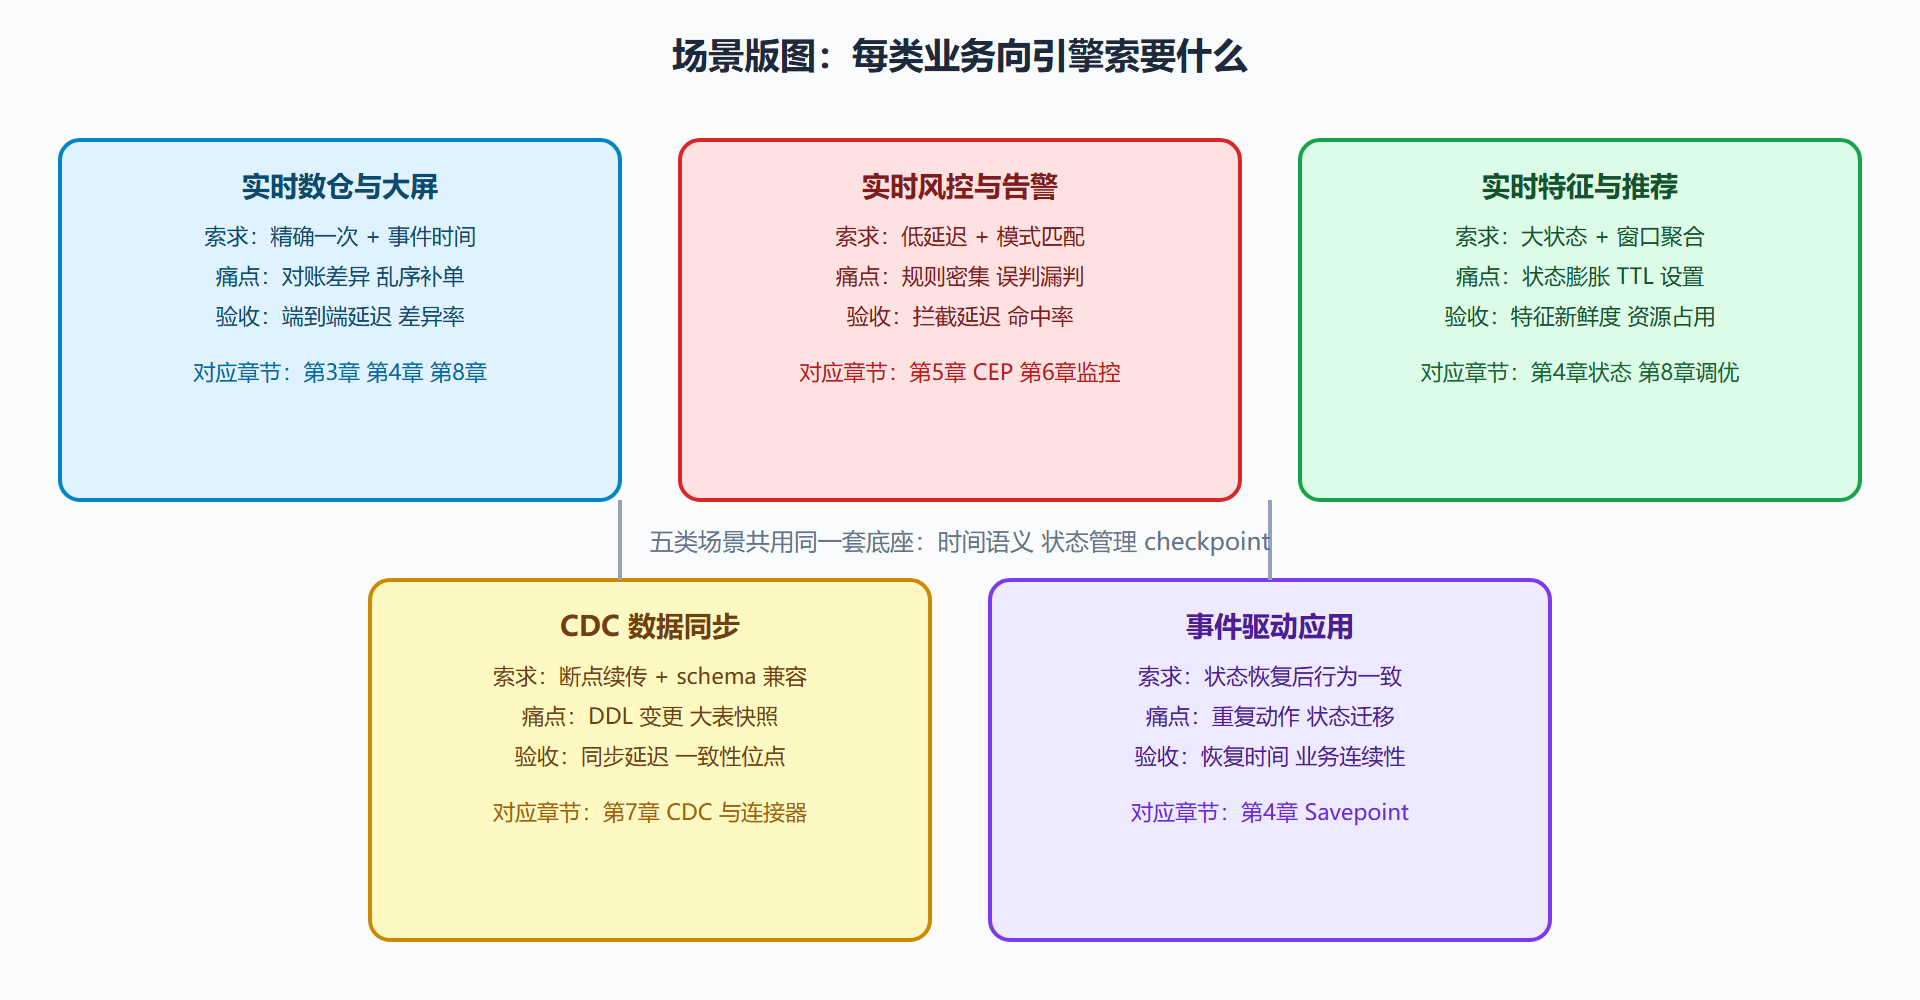
实时数仓与大屏。这是最经典的一类:业务数据经流式加工后写入 OLAP 引擎或 KV 存储,支撑管理驾驶舱、活动大屏、实时报表。它的隐性要求是"数字必须可对账"——大屏上的成交额要能与离线核算对上,差一分钱都会被追问。因此这类场景对精确一次语义、乱序处理(补单、退款晚到)极其敏感,事件时间语义是刚需。验收指标通常是指标端到端延迟与对账差异率。
实时风控与告警。交易反欺诈、登录异常检测、营销反作弊。它的特点是策略规则密集、响应窗口以秒计、漏判误判都直接产生资金损失。这类场景重度依赖有状态的规则计算——把用户最近的交易序列放在状态里做模式匹配(第 5 章 CEP 的主场),同时要求毫秒到百毫秒级的延迟。状态规模与命中率是它的核心观测项。
实时特征与推荐。推荐系统需要"用户此刻的兴趣",特征工程因此从离线搬到在线:滑动窗口统计点击、按会话聚合行为、多流 join 补全画像。它的难点在状态规模(千万级用户 × 特征维度)与状态更新频率,通常必须上 RocksDB 后端并精细调优 TTL——这正是第 4 章与第 8 章要解决的问题。
CDC 数据同步。把 MySQL 等数据库的变更日志实时抽取出来,同步到数仓、缓存或搜索索引。它对引擎的要求其实很苛刻:schema 演进要兼容、断点续传要精确、下游写入要幂等。Flink CDC 把"读变更日志"做成了数据源连接器,一条 SQL 就能建同步管道,近年来已成为数据集成的默认方案,第 7 章有专门一节。
事件驱动应用。不止于"算数",而是直接驱动业务动作:订单状态机流转、IoT 设备联动、消息的路由与分发。这类应用把 Flink 当作带状态的事件处理服务器来用,对 checkpoint 恢复后的行为一致性要求最高——状态恢复后业务必须能从断点继续,而不是重放出一堆重复动作。
图 1-3 Flink 场景版图:五类业务与它们的索求
场景版图的三条使用心得
第一,场景可以叠加。一个"实时数仓 + 风控特征"的复合作业并不少见,此时要按要求最严格的那个场景来定架构底线——数仓的对账要求和风控的延迟要求同时成立,成本会显著上浮,评审时要提前讲清。
第二,验收指标先于架构。先和业务方敲定"延迟多少算达标、对账差异容忍多少、状态涨到多大要告警",再倒推技术选型。顺序反过来,就会出现"架构很先进、业务不买账"的尴尬。把验收指标写成文字,是值班工程师保护自己的第一道防线。
第三,版图会漂移。业务从大屏长出风控、从风控长出特征,是很自然的演化。选型时留余量(比如状态后端从一开始就选 RocksDB 而非纯内存),漂移来临时就不用推倒重来。
两个格子里的真实项目
版图讲完,用两个真实感强的项目把"场景定架构"演成剧本。项目一:双十一直播大屏。业务形态是数仓格子的极端版——峰值流量是日常几十倍,指标要在大屏上以秒级刷新,全国高管盯着看。它的架构画像:上游 Kafka 多分区扛峰值,作业按事件时间开分钟级滚动窗口,容忍参数在活动前按彩排队列的延迟分布重新校准;OLAP 端选主键模型接幂等写入;部署上单作业型独立成集群,大促前副本翻倍演练过反压与扩容。它最怕的两件事——大屏停更与数字跳变——分别由运维四件套与迟到修正口径提前兜住。项目二:银行卡盗刷拦截。风控格子的代表:规则密集(上百条策略)、延迟预算五百毫秒、误判直接影响客诉。它的架构画像:CEP 表达"连续失败加异地登录"类序列规则,进程函数承载带外部特征查询的复杂规则(同步调用全部异步化加缓存);状态按卡号分桶,TTL 设三十天与卡的生命周期对齐;所有外部依赖带降级开关,特征服务抖动时自动退回静态规则。它最怕的不是宕机而是慢——所以监控里水位线延迟的告警阈值压得比大屏项目紧一倍。
两个项目对照着看,"场景决定架构"就不再是抽象原则:大屏项目把资源花在峰值吞吐与可观测上,风控项目把功夫花在延迟预算与降级链路上,同一个引擎,两种活法。评估新需求时,先问自己它在版图的哪个格子、那个格子的前辈项目把钱花在了哪,架构的眉目就出来了。
还有一类正在兴起的格子值得留个心眼:流式机器学习与在线学习。特征实时加工是它的前半场(特征格子的延伸),模型在线更新与实时推理链路是后半场,Flink 在其中的角色正从"特征引擎"向"训练数据流引擎"扩展。新业务落进这个格子时,先按特征格子的要求打底,再评估流式训练的额外需求——版图在长,但长出来的部分都踩在旧格子的地基上。
本节的落点收成一句话:格子是地图,验收指标是指南针。地图帮你认路,指南针帮你确认每一步没走偏——两者齐备,场景分类才从知识变成生产力。
把五类格子的入口指标也一并收进口袋:数仓类先谈对账差异率,风控类先谈延迟预算与误报成本,特征类先谈键规模与新鲜度,CDC 类先谈主键与 binlog 保留期,事件驱动类先谈恢复后的业务连续性。每类格子的第一句对话,就是它最重要的验收指标——开场谈对了,后面整个项目的技术翻译都不会跑偏。
本节要点
- 五类核心场景各有各的索求:数仓要对账、风控要低延迟、特征要大状态、CDC 要断点续传、事件驱动要恢复一致。
- 复合场景按最严格要求定底线,成本评审提前做。
- 验收指标先于架构决策,写进文档是值班工程师的自保手段。
- 版图会漂移,选型要给业务演化留余量。
第 1 章到此收束。下一章我们走进引擎内部,看看一段代码是如何变成分布式集群上真实运行的作业的——那是一切排错能力的地基。