2.1 集群架构组件
2.1 集群架构组件
本节摘要:Flink 集群由资源层、JobManager、TaskManager 三层构成:JobManager 负责调度与协调,TaskManager 负责执行与数据交换,Slot 是两者之间的资源契约。本节逐个拆解这些组件的职责与协作关系,并澄清并行度、槽位、任务之间最常被混淆的概念。
为什么先认零件再看运转?
一个作业提交上去就"自己跑起来了",可它到底跑在谁身上?为什么有时资源明明够、作业却申请不到槽位?要回答这些值班室高频问题,得先把集群当机器拆开看零件。本节是第 2 章的地基站:认识三位主角——管事的 JobManager、干活的 TaskManager、以及给它们提供落脚点的资源层。第 1 章我们只从远处看过引擎的轮廓,现在走进机房。
先抛一个问题:一个作业包含两百个并行子任务,集群只有五十个槽位,作业能启动吗?很多人凭直觉答"不能"。带着这个疑问往下读,读完你应该能自己推翻它——这正是理解 Slot 语义的价值所在。
JobManager:集群的大脑
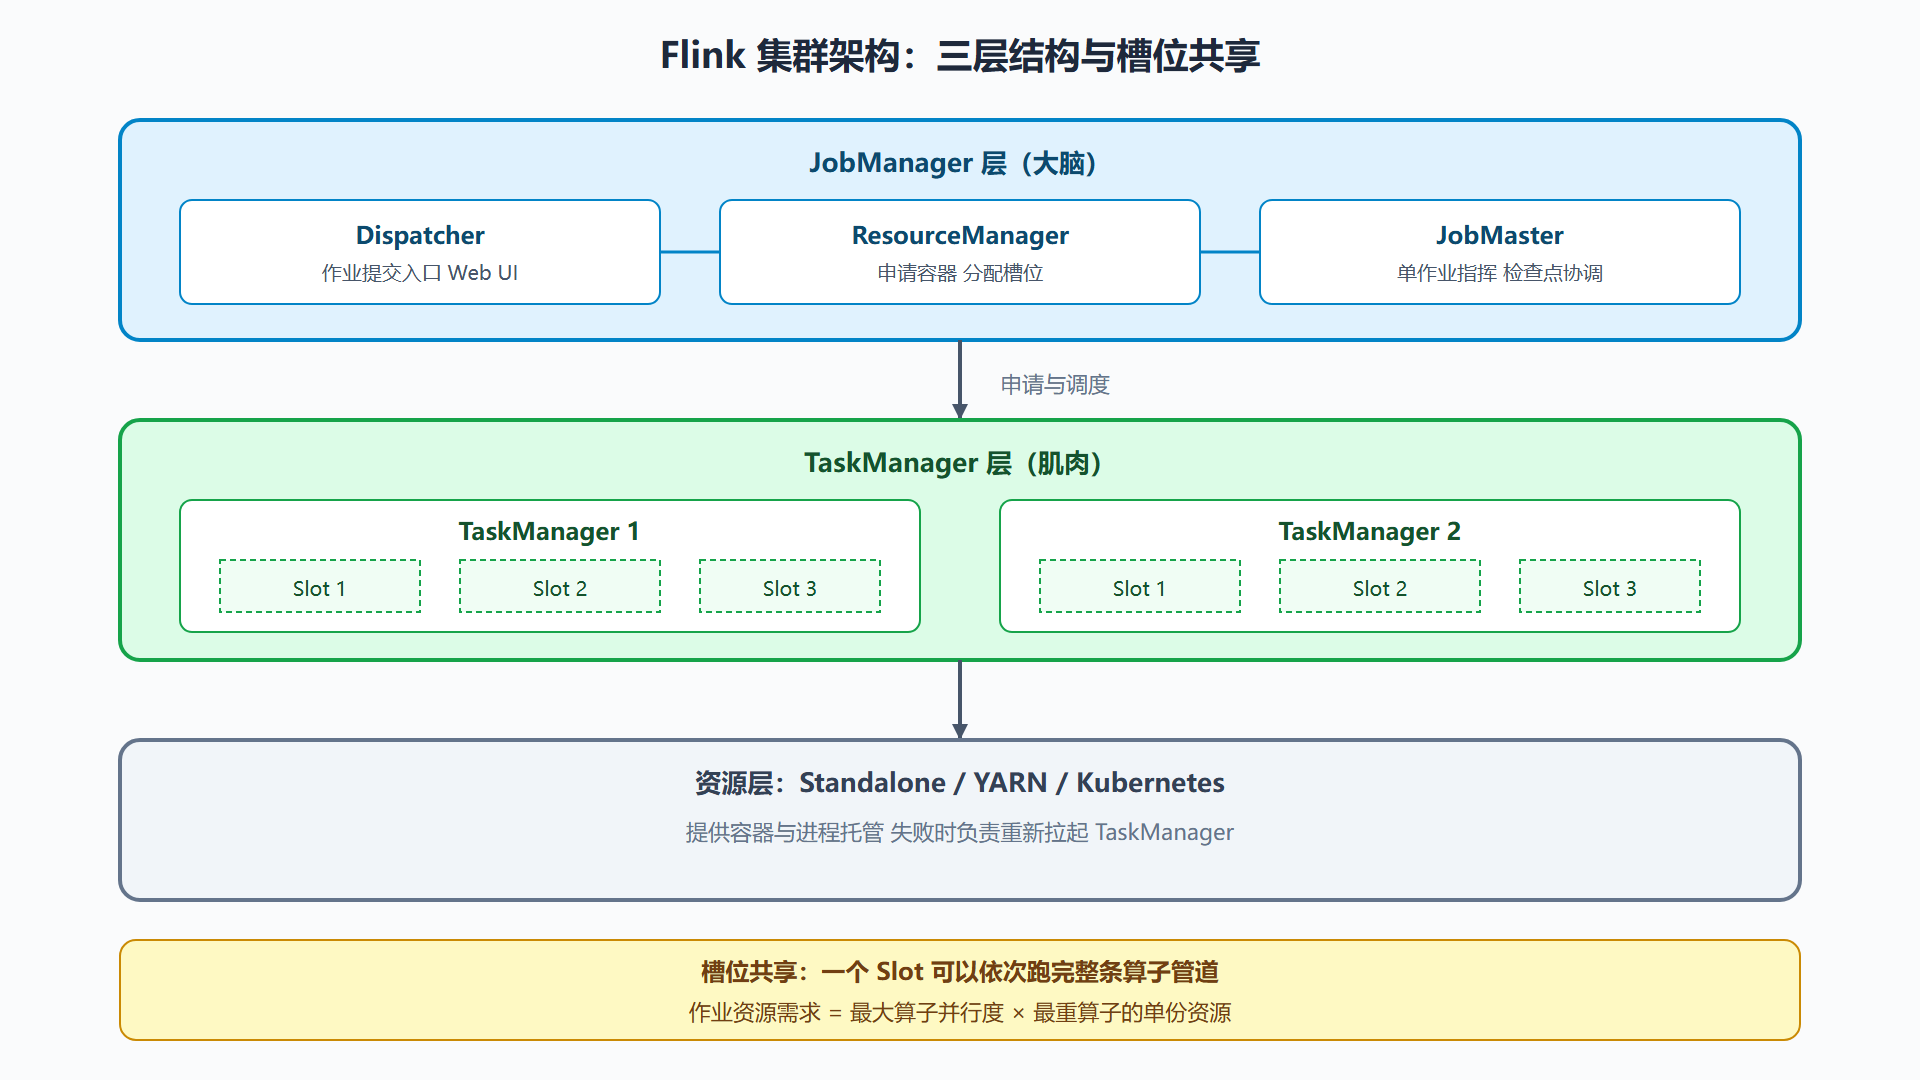
JobManager 不是单一进程,而是一组协作角色。在不同部署模式下它们的合并方式不同,但职责可以拆成三块:
- Dispatcher:集群的门户。提交作业先到它手里,它负责启动新作业的执行环境,并提供 Web UI 与 REST 接口。值班时看作业状态、拉日志,走的就是它。
- ResourceManager:管资源账本。它负责向资源层(Standalone、YARN 或 Kubernetes)申请 TaskManager 容器,并把空闲槽位分配给作业。槽位不够时,扩容请求也是它发出的——作业卡在"等待资源"状态,八成要查它的日志。
- JobMaster:单个作业的直属指挥。每个作业对应一个 JobMaster,它把作业图转成执行图、协调检查点、跟踪每个子任务的状态。作业级别的一切故障(任务失败重启、检查点失败)第一现场都在它这里。
三个角色的分工可以用一句值班黑话记牢:Dispatcher 管迎宾,ResourceManager 管分房,JobMaster 管施工。生产集群为高可用会部署多个 JobManager 实例,主备之间靠选举协作,这块留到第 6 章细讲。
TaskManager 与 Slot:集群的肌肉
TaskManager 是真正执行代码的 JVM 进程。它启动时向 ResourceManager 注册自己带来的槽数——每个槽位是一份固定的计算资源配额(主要指受管理的内存切片)。任务线程跑在槽位里,数据交换走 TaskManager 之间的网络栈。
这里必须澄清全册最容易混的三个概念:
- 并行度是一个算子切成多少份并行执行的数量,属于逻辑概念;
- Slot 是 TaskManager 内部的资源分区,属于物理概念;
- 任务是算子在每个并行度上的一个实例,是真正被调度执行的单元。
关键规则是:默认策略下,同一作业的不同算子可以共享一个槽位。于是"两百个并行子任务、五十个槽位"完全可行——只要作业的算子链组织得当,五十个槽位每个跑一段"管道",整条数据流照样通畅。槽位共享的价值正在于此:资源需求取决于全作业最重的算子,而不是所有算子的总和。
# 每个 TaskManager 的槽位数:多槽位能提高资源利用率,但加剧进程内资源竞争 taskmanager.numberOfTaskSlots: 4 # 受管理内存按槽位均分:调槽位数前先算清每槽能分到多少 taskmanager.memory.managed.fraction: 0.4
图 2-1 集群架构总览:三层结构与槽位共享
资源层:集群住在哪
第三层是资源层,决定 TaskManager 进程"住在哪、谁拉起"。三种典型形态各有值班要点:Standalone 模式自带常驻进程,简单直接,但故障恢复要靠 Flink 自身;YARN 模式把资源管理交给 Hadoop 体系,容器化分配,适合与老大数据平台混部;Kubernetes 模式是当前新建集群的主流,弹性伸缩与故障重拉由控制器完成,第 6 章讲部署模式时会对比三者的取舍。理解这一层的意义在于:当作业反复重启时,你要能分清是 Flink 在重启任务,还是资源层在重启容器——两者的日志位置和处置方式完全不同。
值值班手册里的三个架构问答
把组件知识浓缩成三个值班手册风格的问答,遇到对应告警时可以直接翻牌。问答一:告警"槽位申请不到",先看什么? 先看 ResourceManager 日志确认是"没有空闲槽位"还是"申请容器失败":前者查现有作业的槽位占用(谁家作业把槽位占满还没释放),后者查资源层配额与镜像。两种病因一个症状,先分岔再动手能省一半时间。问答二:TaskManager 数量明明够,作业还是反复重启? 查重启的真正原因——任务失败重拉与容器被资源层回收是两条路径;如果是后者,多半是进程内存超限被系统杀掉(内存分区配比问题,第 8 章的账本),Flink 侧的重启日志只会告诉你"容器异常退出",要往下追一层。问答三:Web UI 上作业是绿的,业务方却说没数据? 绿灯只代表任务线程活着,不代表数据在流——查源的流入指标与水印推进;流入为零查上游与连接器,流入正常而下游空白查算子逻辑(比如过滤条件把数据全滤没了)。三个问答共享一个方法论:告警文本只是入口,组件职责链才是路标。
顺手补一条冷知识收尾:JobManager 与 TaskManager 可以跑在同一台物理机上(小集群常见),但生产环境强烈建议分离部署——大脑与肌肉共患难的结果,往往是一台机器故障让"指挥与执行"同时失联,故障半径从"损失一批任务"放大到"整作业失联"。架构分层不仅写在代码里,也写在机柜规划里。
本节要点
- JobManager 是三角色协作:Dispatcher 管入口,ResourceManager 管资源账本,JobMaster 管单个作业的执行与检查点。
- TaskManager 是执行进程,Slot 是其内部资源分区;并行度是逻辑切分,任务是被调度的单元。
- 默认槽位共享策略下,作业所需槽位数取决于最大算子并行度,而非所有子任务之和。
- 资源层决定进程托管方式,Standalone、YARN、Kubernetes 的故障恢复路径各不相同,排错前先确认自己身处哪种形态。
认识了零件,下一节看它们如何协作运转:一段数据从进入作业到流出结果,在算子与槽位之间经历了什么。