2.2 任务执行流程:算子、并行度与算子链
2.2 任务执行流程:算子、并行度与算子链
本节摘要:本节跟踪数据在作业内部的流动路径:用户代码如何编译成作业图,算子如何被并行切分,哪些相邻算子会合并成算子链,以及数据在键控 shuffle 前后如何分发。读完你应能对着 Web UI 的执行图讲出每个方框对应的物理实体,并判断一次并行度调整会实际改变什么。
数据走一趟才算真懂
上一节我们认了零件,本节通电试机:让一条数据从源算子流到汇算子,全程追踪它的遭遇。这一站解决的是全章最核心的问题——作业图上的抽象方框,与集群里的线程、缓冲区如何对应。理解了这层映射,你在 Web UI 里看到的就不再是天书,而是一份可以逐格检查的施工图。
先立一个贯穿全节的视角:数据流编程模型里,程序是"图的描述",运行时是"图的执行"。用户写的每一行转换,都是在往一张有向图上加节点与边;提交后引擎做三步变换——逻辑图转作业图、作业图转执行图、执行图部署到物理槽位。三步变换各自动了什么手脚,就是本节的三个知识点。
第一步:从代码到逻辑图与作业图
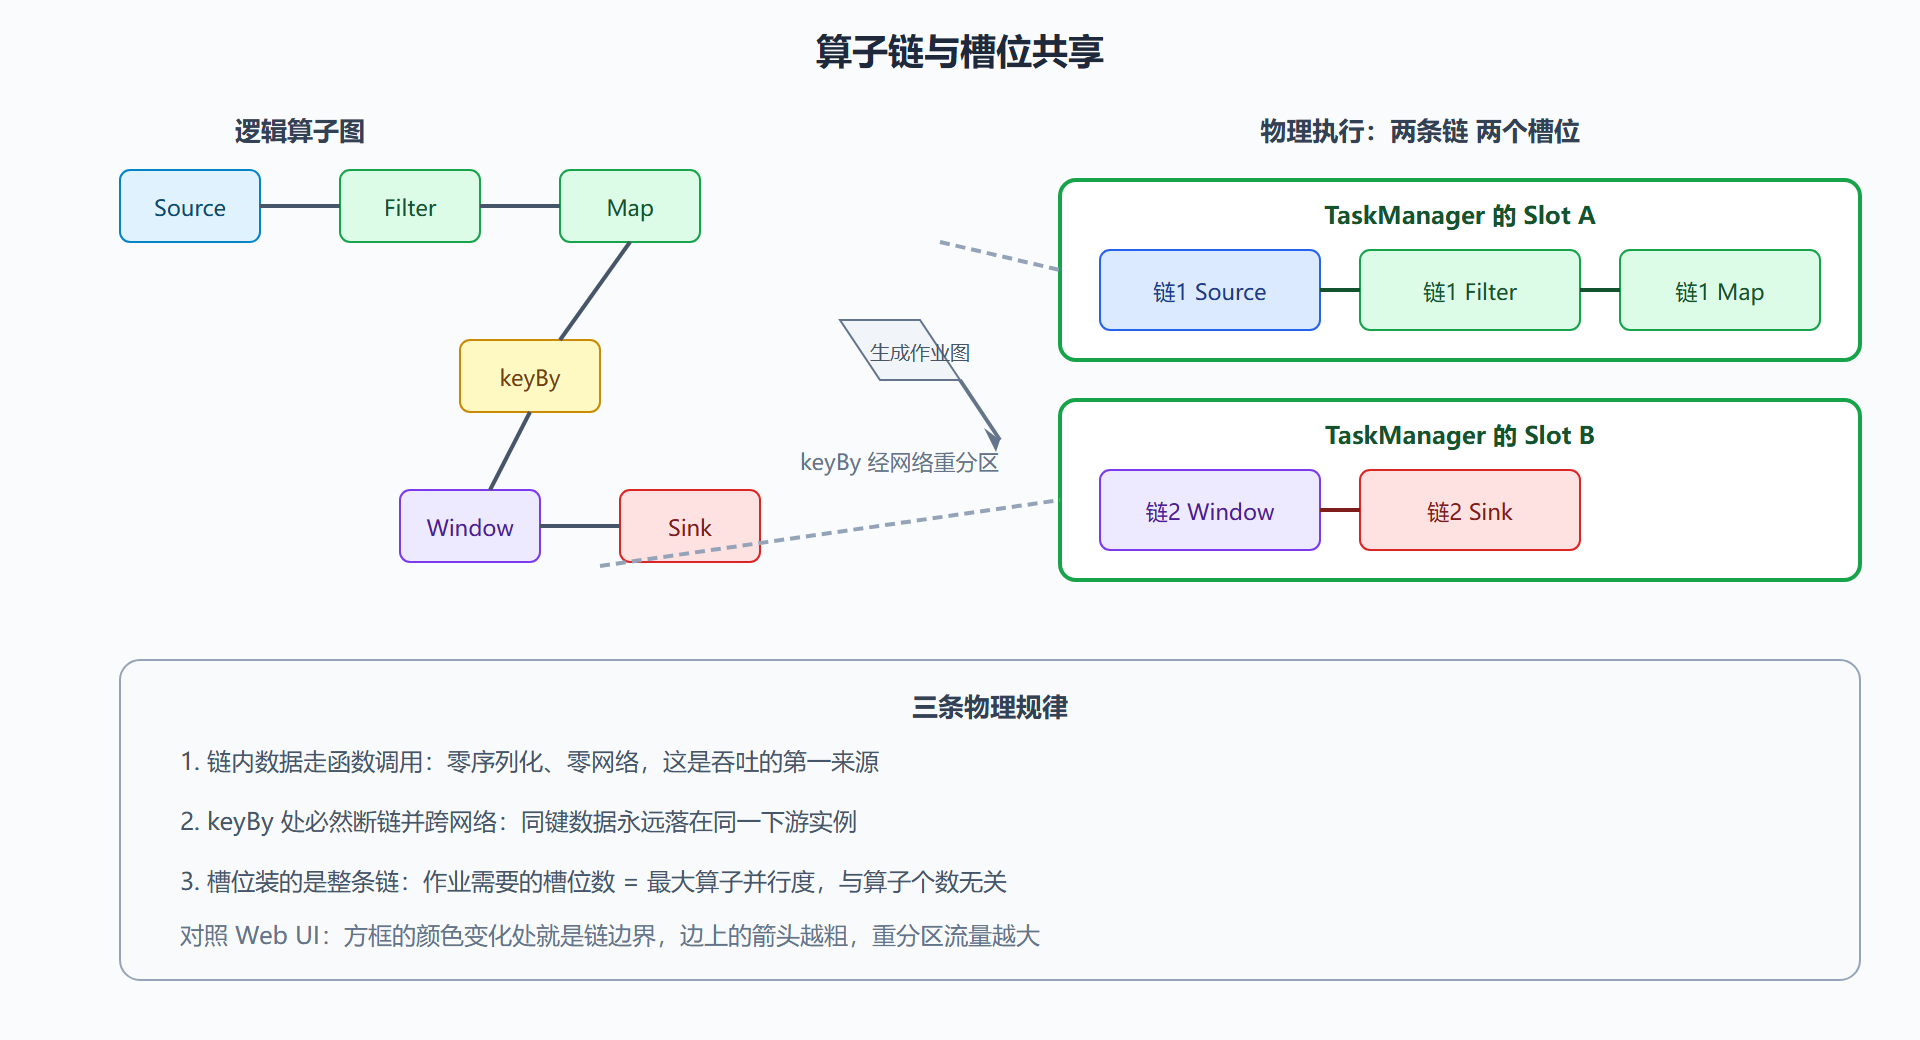
DataStream API 的每次 map、filter、keyBy,都会在客户端生成一个算子节点。引擎先把它们串成逻辑数据流图,再做一轮优化:把可以合并且不重分流的相邻算子打包成算子链(Operator Chain)。链内的算子在同一个线程里依次执行,数据在函数调用间传递,没有序列化与网络开销——这是 Flink 吞吐性能的第一根支柱。
控制链合并的三个条件值得背下来:算子并行度相同、数据是前向传递(没有 keyBy 或广播引起的数据重分布)、链未被显式关闭。于是调优手册里常见的两个动作就有了原理支撑:
DataStream<Order> orders = env.addSource(kafkaSource).name("kafka-src"); // map/filter 与 source 并行度一致且前向传递,会被链进同一个线程 DataStream<Order> cleaned = orders.filter(this::isValid).map(this::enrich); // keyBy 引起重分区:在此处断链,数据经网络 shuffle 到下游各并行实例 DataStream<Stat> stats = cleaned .keyBy(Order::getUserId) .window(SlidingWindows.of(Time.minutes(5)).every(Time.minutes(1))) .aggregate(new StatAgg()); // 个别算子若重(如调外部服务),可显式断链或调整槽位共享组,避免拖累整链 cleaned.startNewChain().map(this::callRiskService).name("risk-call");
为什么这段知识值得写进值班手册?因为算子链是排查反压的第一张地图:链内一个算子变慢,整条链的吞吐一起下降;Web UI 上看到某条链任务忙到爆,要先拆解链里有哪些算子,才能定位真凶。
第二步:并行度与数据交换
每个算子有自己的并行度,来源优先级是:算子上单独指定 > 执行环境默认值 > 集群配置。并行度切分后,一个算子变成若干并行子任务;子任务之间的数据分发方式分两大类:
- 前向传递:上游子任务直通下游同编号子任务,一对一,无网络(若在链内则连序列化都省了);
- 重分区:keyBy 按键的哈希把数据发给特定下游实例,broadcast 复制给所有实例,rebalance 轮流均分。重分区必然经过网络栈,这是 2.3 节的主角。
keyBy 的分区规则值得多说一句:键的哈希值决定数据归属哪个并行实例,所以同一个键的所有数据必然落在同一个子任务里——这是键控状态(第 4 章)与窗口聚合(第 3 章)能本地化的前提。也是数据倾斜问题的根源:热门键会把某个子任务喂成瓶颈,第 8 章的倾斜治理全靠这个原理推导。
图 2-2 算子链与槽位共享:从作业图到物理执行
第三步:部署到槽位并开始呼吸
执行图生成后,JobMaster 把每个子任务派发给分配到的槽位,TaskManager 为每个任务起独立线程。任务间状态从"已部署"走到"运行中",作业开始呼吸。此时值得养成一个值班习惯:打开 Web UI 的作业视图,横着看链(确认合并符合预期),竖着看并行度(确认没有算子被环境默认值坑了),再看每条边的流量与背压标记——多数性能问题在部署完成的那一刻就已经在图上留下了线索。
⚠️ 常见坑:在代码里对个别算子单独设置了并行度,却按"总并行度之和"去申请槽位,结果资源翻倍浪费。记住槽位装的是链不是算子,所需槽位数只看最大算子并行度。
从一张执行图开始的实战推演
知识合不合手,推演一道真实工单就见分晓。工单背景:某作业在 Web UI 上显示两个子任务"繁忙",其余健康,业务反馈吞吐不足。按本节的知识推演:第一步看图定位繁忙方——是窗口聚合的某几个并行实例(竖着看的收获);第二步查这两实例的键分布——头部商户流量百倍,倾斜脸型(横向看链与并行度的收获);第三步因此把处置方向定为"改结构"(加盐打散)而非"加资源"。整条推演没有一步靠猜,每一步都有本节的原理背书:链结构告诉你在哪一层看、并行度分布告诉你忙的是谁、keyBy 哈希告诉你为什么偏偏是它。
再推演一道反向工单:想给作业加一个字段加工逻辑,改完后吞吐腰斩。查图发现新算子把原本连贯的链从中间截断了——因为它的并行度被无意设成了与上下游不同的值,链合并条件破坏,原本零开销的函数调用变成了完整的序列化加网络传输。处置:对齐并行度让链恢复合并,吞吐复原。两道工单合起来,本节知识的使用说明书就写成了:性能异常先看图,链边界是第一嫌疑人。
本节要点
- 用户代码经历三步变换:逻辑图 → 作业图(打包算子链)→ 执行图(落到物理槽位)。
- 算子链合并三条件:并行度相同、前向传递、未被显式断开;链内传递零序列化零网络。
- keyBy 等重分区必然断链跨网络,且同键数据必落同一实例——键控状态本地化的前提,也是倾斜的根源。
- 作业所需槽位数等于最大算子并行度;按"并行度之和"申请资源是常见浪费。
数据流动的下一层是网络本身:缓冲区怎么攒批、下游来不及消费时压力如何回传。这就要进入 2.3 节的网络通信模型。