4.1 状态后端:状态住在哪
4.1 状态后端:状态住在哪
本节摘要:状态后端决定流作业的"记忆"放在哪里、能长多大、快照多快。本节先分清键控状态与算子状态两大类,再对比堆内存与 RocksDB 两种后端的取舍,最后给出状态规模的心算方法与托管内存的记账规则。它是第 4 章的地基:不知道状态住在哪,容错与调优都无从谈起。
一次内存溢出引发的追查
凌晨的告警不是 checkpoint 失败,而是一个更原始的症状:TaskManager 接连内存溢出重启,作业反复爬起又反复倒下。日志里找不到业务异常,堆栈最深处在序列化工具里。追到根上,是一个去重作业把三个月的全部用户 ID 存进了堆内存——状态后端还停留在默认的堆模式,状态随流量自然生长,长到把堆撑爆。要处理这类故障,得先建立本章第一个坐标系:状态有哪些类、住在哪、账怎么记。
先分清两大类状态
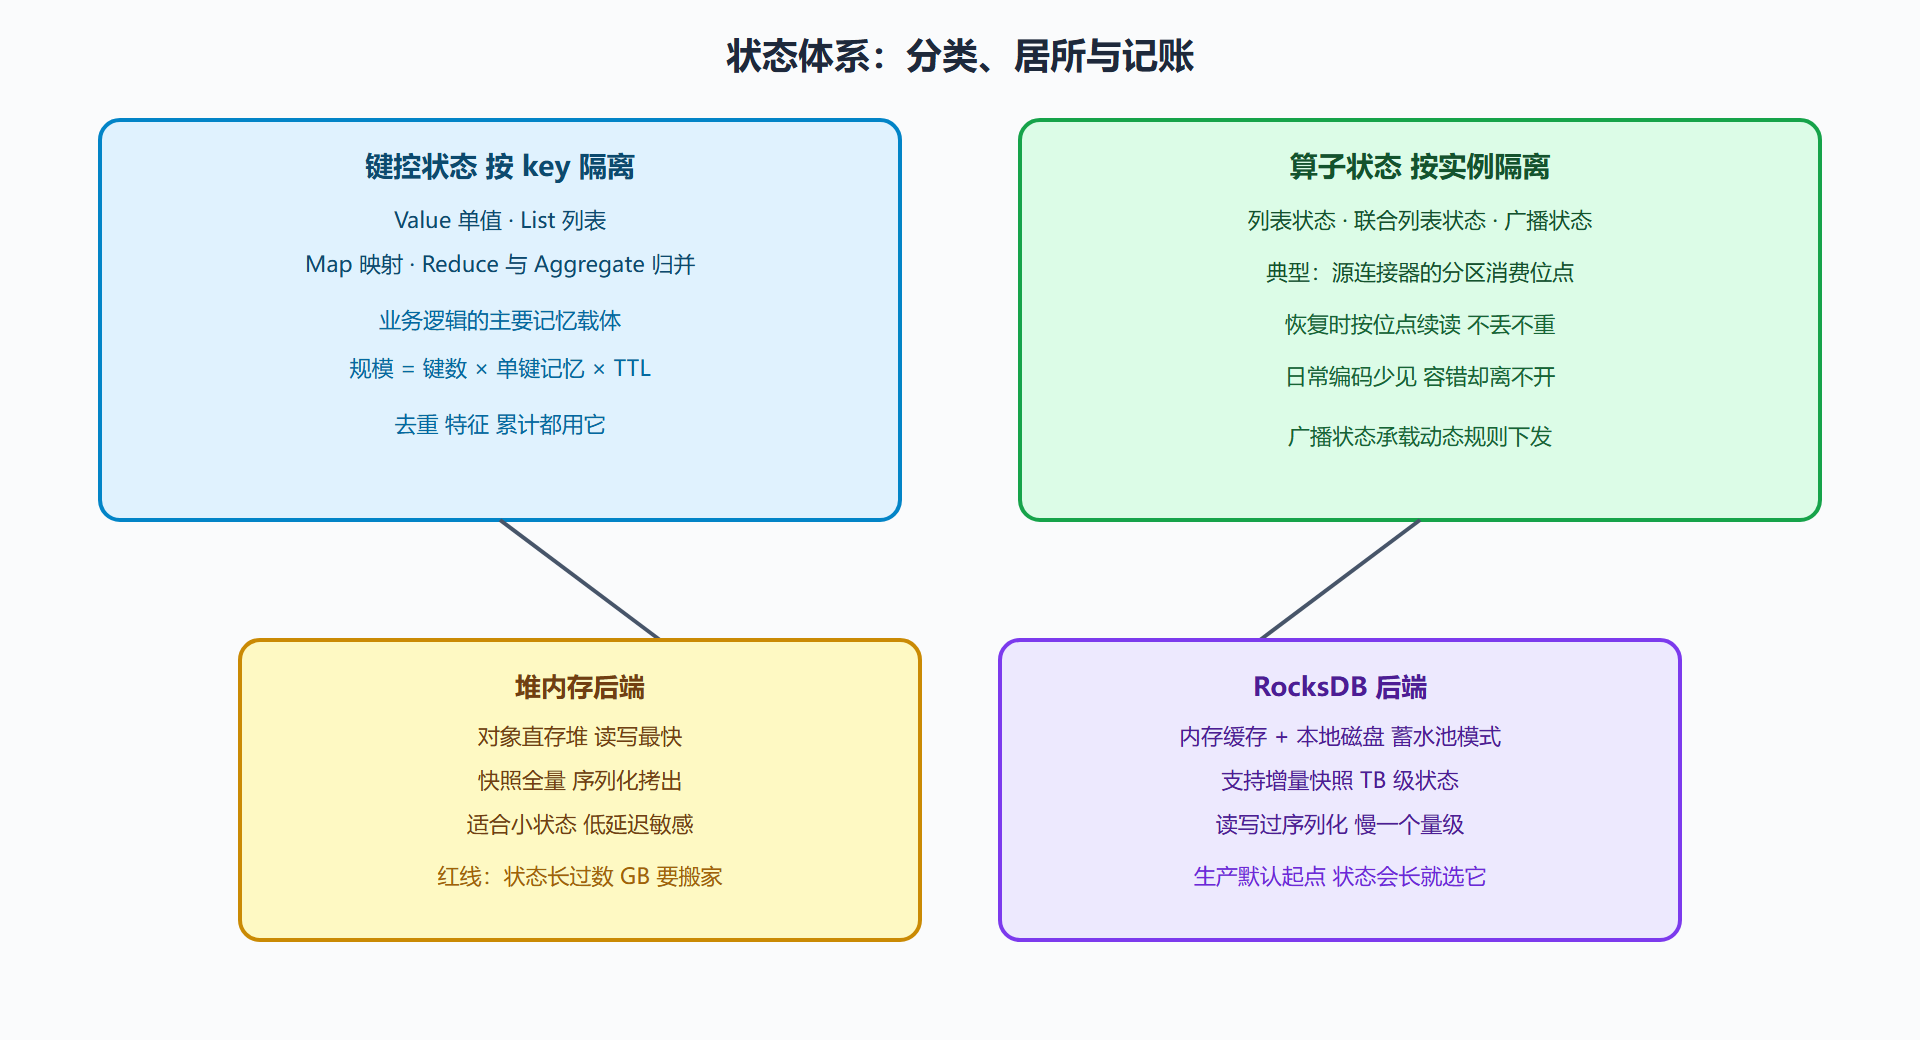
键控状态(Keyed State)是应用最广的一类。它按 key 隔离:keyBy 之后,同一个键的所有数据路由到同一个并行实例,状态也按键分桶存放。你并不直接操作"状态表",而是声明需要什么形态的记忆,引擎负责按键读写:
- ValueState:单值记忆,比如"该用户今天已下单金额";
- ListState:列表记忆,比如"该用户最近十次操作的记录";
- MapState:映射记忆,比如"该用户各商品的浏览次数";
- ReducingState 与 AggregatingState:自带归并语义的记忆,写入即聚合,适合只关心累计值的场景。
public class DedupFunction extends KeyedProcessFunction<String, Event, Event> { private ValueState<Boolean> seen; @Override public void open(Configuration cfg) { // 状态描述符声明"键 + 形态 + 序列化器",TTL 与压缩都在这里挂 ValueStateDescriptor<Boolean> desc = new ValueStateDescriptor<>("seen", Types.BOOLEAN); seen = getRuntimeContext().getState(desc); } @Override public void processElement(Event e, Context ctx, Collector<Event> out) throws Exception { if (seen.value() == null) { // 没见过:登记并放行 seen.update(true); out.collect(e); } // 见过:静默丢弃 } }
算子状态(Operator State)按并行实例隔离,与键无关。最常见于 Source 与 Sink:Kafka 源用算子状态记录每个分区的消费位点,恢复时按位点续读。它日常编码出现率低,但检查点恢复的正确性依赖它,知道即可。
两种后端的分野
状态总要有地方放,这个"地方"就是状态后端。现代 Flink 把状态的实际存储收敛到两种:
堆内存后端(HashMapStateBackend):状态就是 Java 对象,直接住堆里。读写快——一次哈希查找的事;上限低——状态总量受堆大小约束,且快照要把对象序列化后拷出,大状态时快照耗时长、GC 压力大。适合状态可控的小作业:几 GB 以内、访问频繁、生命周期短。
RocksDB 后端(EmbeddedRocksDBStateBackend):状态住进 TaskManager 本地磁盘上的内嵌 RocksDB,内存只做读写缓存。上限高——状态可做到 TB 级,只受磁盘约束;代价是读写要过序列化与压缩,单次访问慢一个量级。它还支持增量快照:每次 checkpoint 只上传相对上次变化的部分,大状态作业的快照体积与耗时断崖式下降。生产上"状态会长的作业",无脑从它开始。
| 判定项 | 堆内存后端 | RocksDB 后端 |
|---|---|---|
| 状态规模上限 | 受堆约束,建议个位数 GB | TB 级,受磁盘约束 |
| 读写延迟 | 纳秒到微秒 | 十微秒到毫秒级 |
| 快照方式 | 全量序列化 | 支持增量 |
| GC 压力 | 大状态时显著 | 几乎无感 |
| 典型场景 | 小状态、低延迟极敏感 | 去重、大窗口、长周期特征 |
图 4-1 状态体系全景:两大类状态与两种居所
托管内存的记账规则
选了 RocksDB,就要懂它的钱袋子:RocksDB 的内存由 Flink 的托管内存池统一划拨,写缓冲、块缓存、索引都从这一个池子按比例分。这意味着两件事:其一,RocksDB 后端作业的内存瓶颈常表现为托管内存不足(写缓冲被挤、频繁刷盘),而不是堆溢出;其二,作业里其他托管内存消费者(第 5 章的批处理排序、第 8 章的窗口聚合缓存)会跟 RocksDB 分同一个池,一边涨另一边就得让。心算公式:每实例托管内存 ≈ TaskManager 托管内存总量 ÷ 槽位数,再乘以 RocksDB 的配比参数。这条账在 8.2 节调优时还要细算,这里先建立"状态花钱、账在托管池"的直觉。
💡 关键直觉:状态后端没有全能冠军。判断题只有一道——状态会不会持续生长。会长的作业,RocksDB 的"慢一点"换来的是活下来的资格;不长的小作业,堆后端的快换来极致延迟。
后端迁移:一次"搬家工程"的步骤清单
选型判断错了怎么办?后端迁移是本节知识的终极应用,步骤清单可以直接抄走。第一步:评估规模与访问模式,确认迁移动机成立(状态量、快照耗时、内存水位三证据齐备,而不是"听说 RocksDB 更好")。第二步:切换配置并做状态重建评估——两种后端的状态格式不同,切换意味着作业从 savepoint 恢复时旧状态不可直接翻译;务实做法是选一个业务低谷,从源头重建状态(对去重类:重建期间接受少量重复放行;对聚合类:从历史数据重放累计)。第三步:压测校准内存,RocksDB 后端生效后托管池的记账接管了原先的堆开销,8.1 节的分区账要重新算一遍,写缓冲与块缓存按实际读写模式校准。第四步:观察一个完整的业务周期,快照耗时、恢复演练、误删信号三项全绿才算迁移完成。整个工程最贵的不是配置,是"状态重建"的决策——它逼着团队第一次认真回答"我的状态从头重建要多久、业务能否承受",而这个问题迟早要面对,迁移只是把它提前了。
本节要点
- 键控状态按 key 隔离,Value、List、Map、Reduce 四种形态覆盖绝大多数业务记忆;算子状态按实例隔离,多见于源位点与广播规则。
- 堆后端快而小,RocksDB 后端慢而大且支持增量快照;判定口诀是"状态会长就上 RocksDB"。
- 状态规模心算:键数 × 单键记忆 × 生命周期(TTL),这个数决定后端选型与第 8 章的调优起点。
- RocksDB 的内存走托管池统一记账,内存瓶颈常表现为写缓冲被挤而非堆溢出。
状态住下来了,下一个问题是:这些记忆如何在机器挂掉时完好无损?答案就是流计算最精巧的发明——检查点,下一节拆开它的机芯。