4.2 容错与 Checkpoint:精确一次的机芯
4.2 容错与 Checkpoint:精确一次的机芯
本节摘要:Checkpoint 是流作业的心跳:周期性地把全作业在同一逻辑时刻的状态打成一份一致快照。本节拆解屏障对齐的快照算法、恢复流程的三步动作,以及"快照 + 可重放源 + 幂等或事务写入"三件套如何合成端到端精确一次。读完你应能回答业务方最爱问的问题:故障后你们的数字凭什么还是对的。
游戏存档的严谨版
checkpoint 的本质是游戏存档:周期性保存进度,死亡后读档重来。但分布式流处理的"存档"难在一个常被忽略的约束上——存档必须是同一时刻的全球合影。作业由几十个并行任务组成,各自的状态在持续变化;如果先拍 A 任务、再拍 B 任务,两份状态之间隔着几百万条数据,恢复后账就对了不。checkpoint 的全部机芯,就是解决"如何让分散在集群各处的任务,各自在同一个逻辑时刻拍快照"这个问题。
机芯核心:屏障与对齐
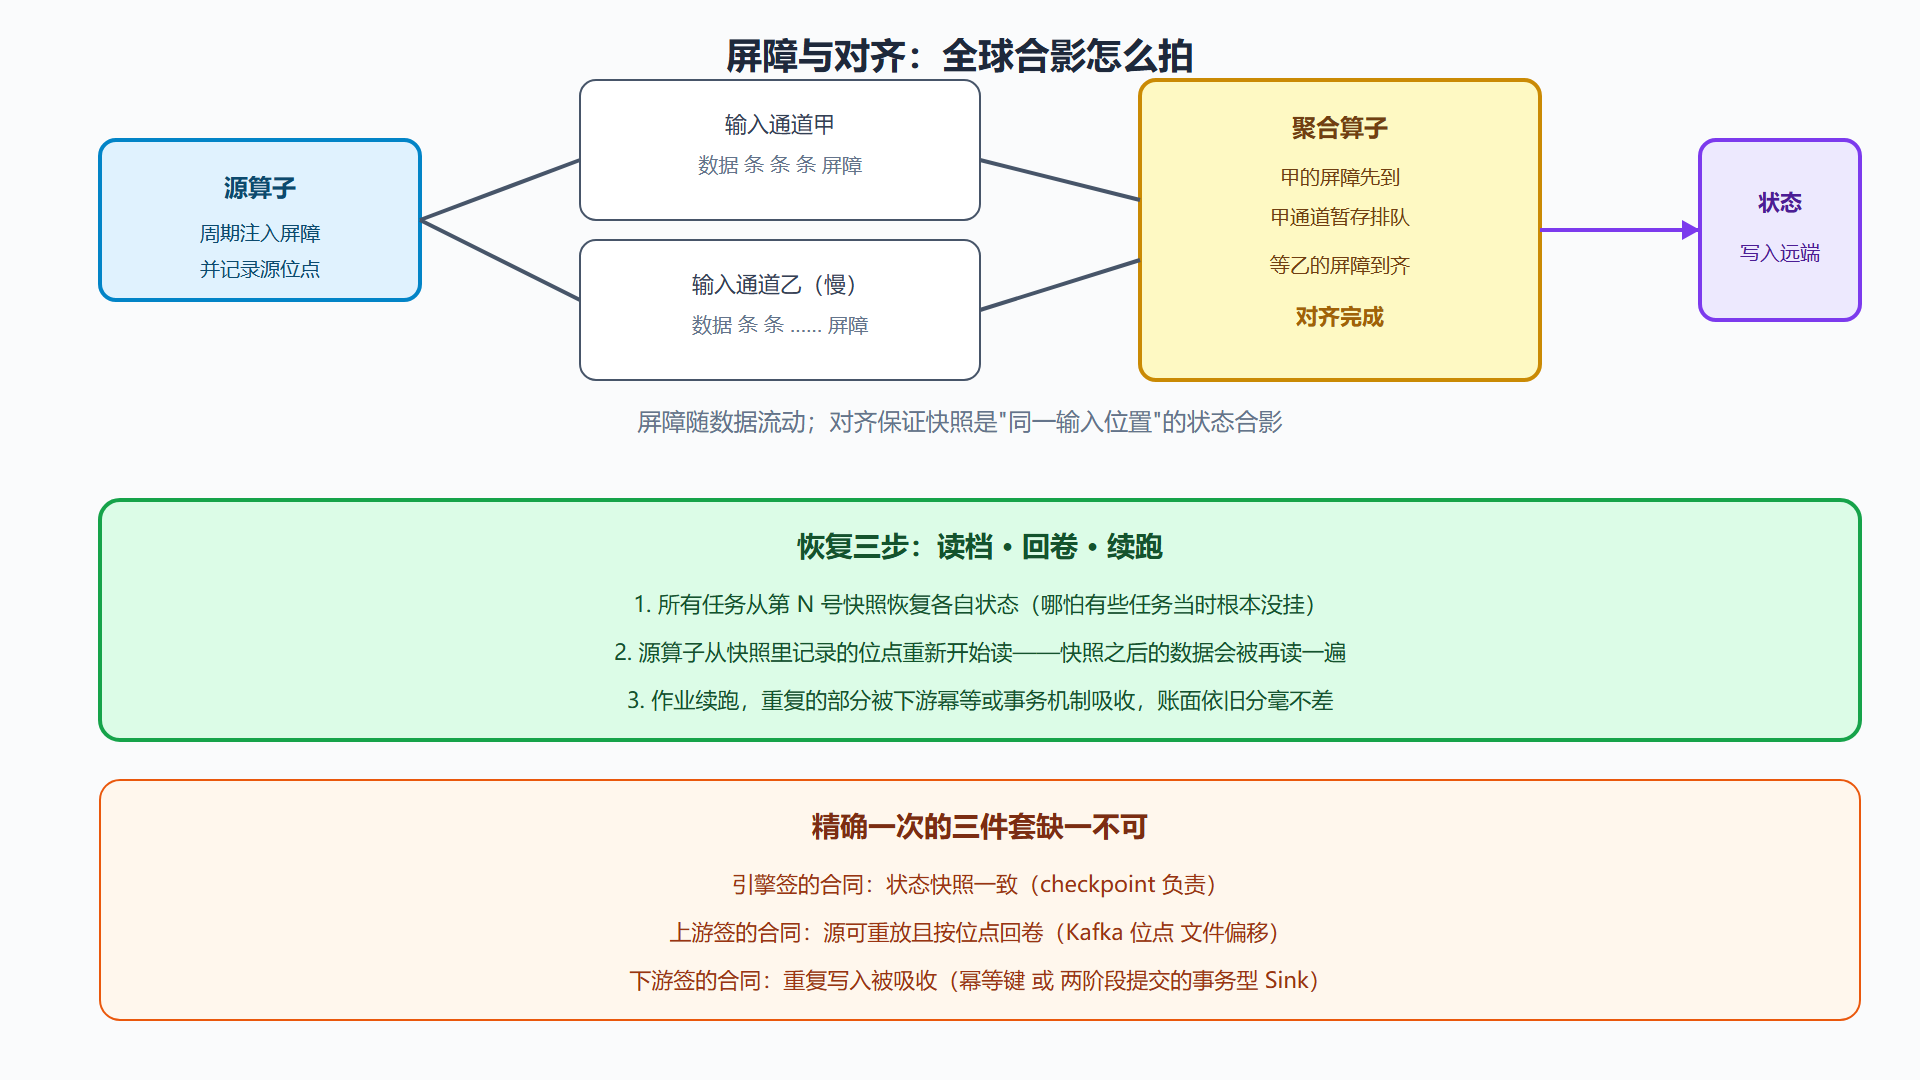
引擎往数据流里注入一种特殊记录,叫屏障(barrier)。屏障由源算子周期性发出,随数据一起流向下游。它的语义是分界线:屏障之前的数据属于第 N 号快照,之后的数据属于第 N 加一号。
快照的协议由此展开。一个算子收到所有输入通道的第 N 号屏障后:先把"早到的屏障"对应通道的数据暂存起来(这一步叫屏障对齐),等其他通道把第 N 号之前的慢数据送完;对齐完成后,算子把自己的当前状态整体写入远端存储(状态后端的快照),随后向下游发出第 N 号屏障。当所有任务都完成第 N 号快照,这次 checkpoint 正式成立,元数据记下各任务快照的位置。
对齐是"全球合影"的关键:它保证快照里的每个状态,都是"输入到同一位置时"的状态——没有这条,恢复后就有数据既算过又没算过的糊涂账。对齐的代价也在这里:早到通道的数据要排队等慢通道,排队期间上游被反压,作业吞吐抖动。后来出现的非对齐 checkpoint 换了个思路:屏障不等了,直接把"排队的缓冲区数据"本身一起拍进快照,快照变大但对齐的停顿消失。它是"对齐超时"场景的救急方案,不是日常首选——快照体积上涨与恢复变慢是它的账单。
图 4-2 屏障流动与快照成立的全过程
恢复流程:读档、回卷、续跑
机器挂了之后,集群把失败任务的子任务重新调度到健康槽位,然后执行三步。第一步读档:所有任务从最近一次成功的 checkpoint 恢复状态——注意是所有任务,包括没挂的,因为"合影"必须整卷生效,部分恢复会造成状态间的逻辑裂缝。第二步回卷:源算子按快照里存的位点把输入拨回去,快照之后的区间会被重新读取。第三步续跑:重新读到快照点之后的数据,聚合逻辑会重算一遍——这些重复正是靠下游合同(幂等或事务)吸收掉的。
端到端精确一次的完整画面就此合龙:引擎保证状态一致,上游保证能重放,下游保证重复无害。三份合同里少一份,语义就降级——比如下游是无幂等的普通数据库写入,实际效果就是"状态精确一次、输出至少一次",对账时会多出重复行。
心跳的参数与体检指标
# 心跳节奏:间隔与超时。间隔越短恢复损失越小,但快照开销越频繁 execution.checkpointing.interval: 60s execution.checkpointing.timeout: 10min execution.checkpointing.min-pause: 30s # 对齐卡死时的救急开关:超过阈值转非对齐快照 execution.checkpointing.aligned-checkpoint-timeout: 60s # 快照的远端居所:生产必配 HDFS 或对象存储,本地目录只是玩具 execution.checkpointing.storage: filesystem
值班盯四项体检指标:间隔内的完成率(连续失败即告警)、快照耗时(贴近间隔说明心脏负荷过重)、快照大小(环比陡增通常意味着状态泄漏或流量突增)、对齐耗时(占比高说明各分区消费不均,往数据倾斜方向查)。这四项在 6.3 节监控体系与 4.4 节排错实录里都会再出现,是状态健康度仪表盘的常驻嘉宾。
⚠️ 常见坑:把 checkpoint 间隔调到秒级"求安心",结果快照开销吃掉吞吐,反而诱发反压。间隔的合理量级是"快照耗时的十倍以上",宁可恢复多算一分钟,也别让心跳挤占呼吸。
一次恢复演练的完整记录
机制学完,最该立刻做的是组织一次恢复演练——它同时验证三份合同是否真的签了。演练脚本可以直接抄:准备:选一个低峰期,记录当前作业的流出累计数与下游表行数。制造故障:kill 一个承载了任务的 TaskManager 进程(不是重启作业——那测的是提交,不是容错)。计时:从进程死亡到作业回到 RUNNING 的总时长,与 6.2 节的五段账对照。验证:恢复后对比下游写入速率是否先冲高(回卷重放的特征)再回落,检查点是否恢复跳动。对账:业务库与下游表核对——若配的是幂等下游,行数应完全一致;若有重复行,说明下游合同没签(幂等或事务缺失)。记录:演练时长、损失区间、发现的链路弱点(比如某外部依赖在重放洪峰时的表现)写进预案。
很多团队跑完演练会惊讶于两个发现:其一,"精确一次"的配置项都开着,但下游写入根本没配幂等——第二份合同一直在裸奔;其二,恢复造成的重放洪峰把某个外部服务打出了抖动,平时相安无事的依赖在恢复窗口最脆弱。这两个坑,演练之外无处可现形。
最后补一个多作业集群的特别提醒:同一集群上的作业共享 TaskManager 资源,A 作业的快照高峰会挤压 B 作业的处理线程。给各作业错开 checkpoint 的触发周期(间隔加相位偏移),是共享集群里成本低、收益高的协调技巧。
本节要点
- 屏障随数据流动,对齐保证快照是同一输入位置的状态合影;非对齐快照用体积换停顿,是救急手段。
- 恢复三步:全体任务读档、源位点回卷、续跑重算,重复由下游幂等或事务吸收。
- 端到端精确一次是三份合同:引擎的状态一致性、上游可重放、下游幂等或事务,缺一降级。
- 心跳体检四指标:完成率、耗时、大小、对齐时长;间隔以快照耗时的十倍以上为量级基准。
自动快照解决"挂了怎么办",还没解决"改了代码怎么把状态带过去"——那是 savepoint 与版本管理的地盘,下一节继续。