7.1 数据源与Sink:连接器的语义分级
7.1 数据源与Sink:连接器的语义分级
本节摘要:连接器是作业与外界之间的血管,评估它的第一问永远是语义:能否重放、是否会重写。本节建立连接器的分类学,把容错语义分成三级并对号入座,给出选型的四问清单与主流组件的适配判断。读完你应能为关键链路配出真正端到端精确一次的进出组合。
血管的语义学
第 4 章讲精确一次时留过一个伏笔:引擎只签三份合同中的一份,上游可重放与下游幂等两份都签在连接器身上。本节就来把这两份合同讲透。一个基本认知先行:连接器的价值排序里,语义正确性高于功能丰富度。一个支持二十种花哨配置但故障恢复会重写的 Sink,进不了任何对账严格的生产链路。
Source:能不能重放是分水岭
Source 连接器的语义核心是"检查点恢复后,数据能不能按位点重来"。按此分水岭可分三类:
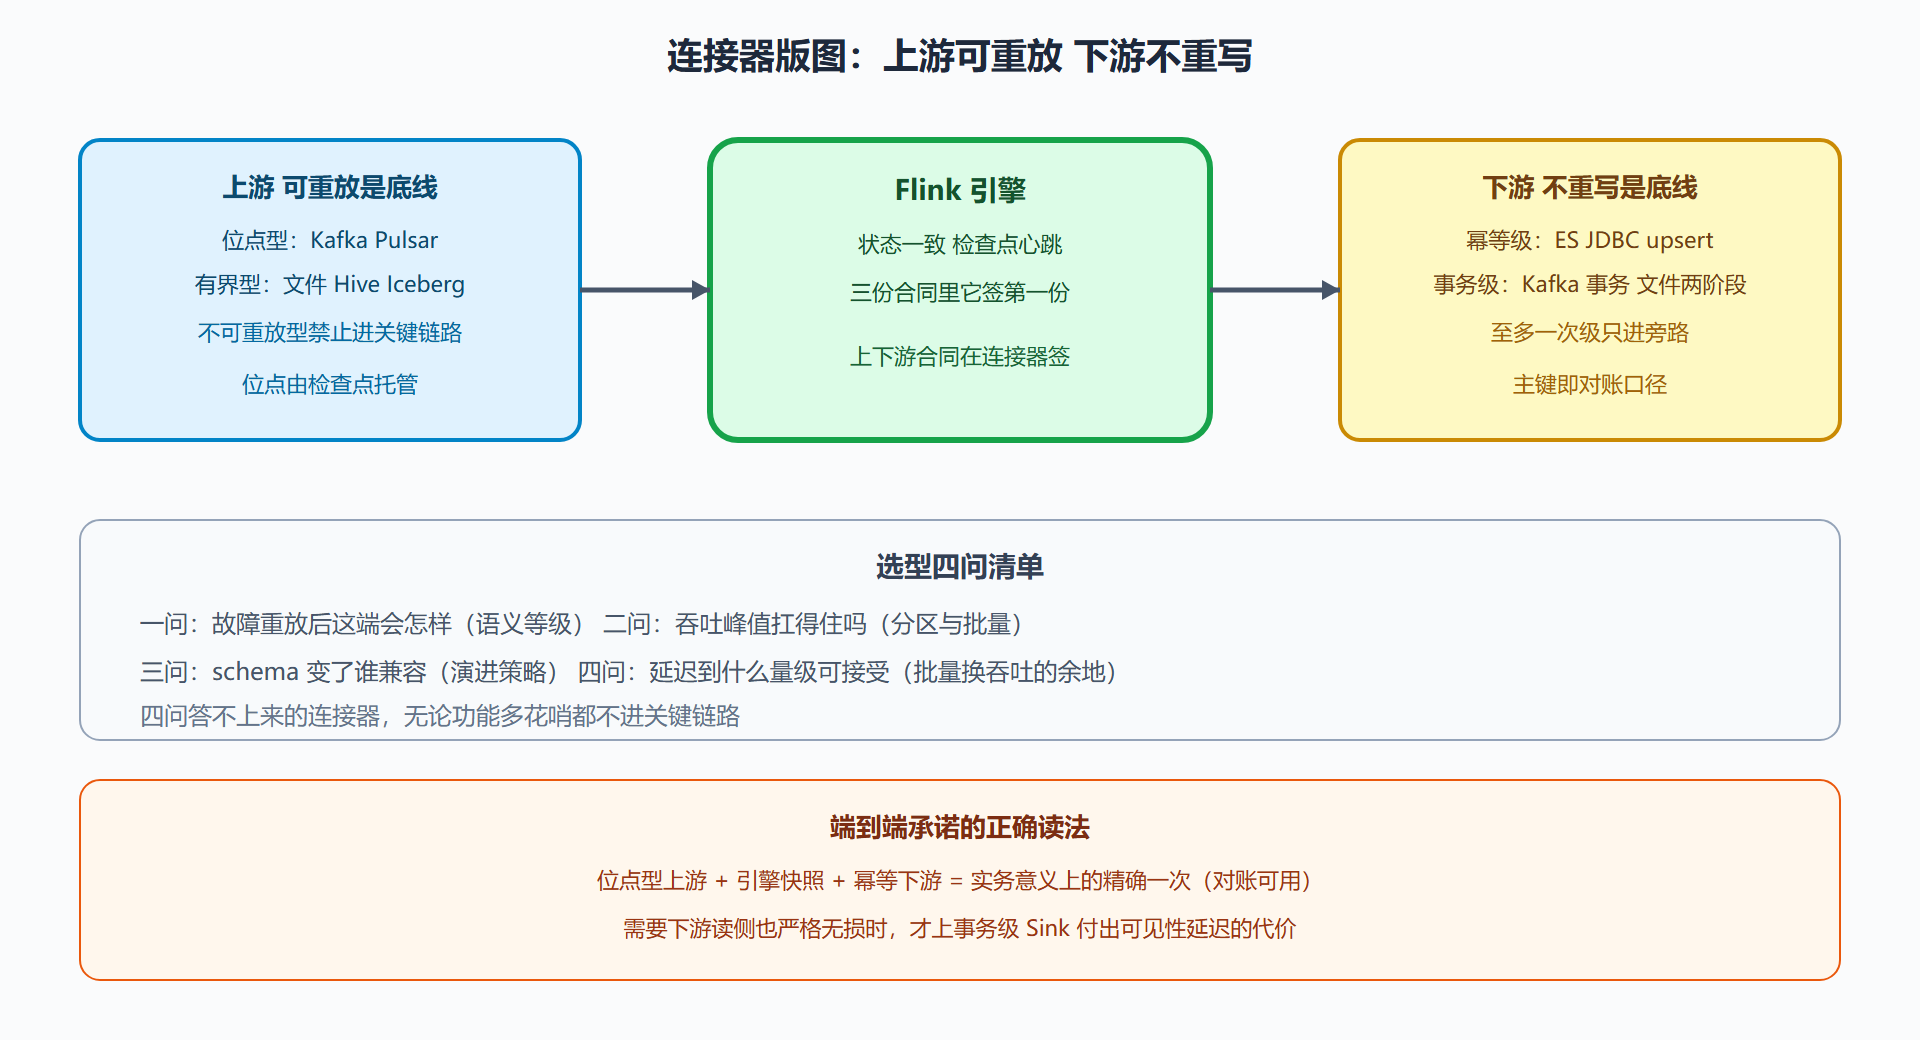
位点型 Source:消费进度被记录进检查点,恢复时按位点回卷重读——Kafka、Pulsar 是代表。它们是精确一次的上游基石:快照里存着每个分区的位点,恢复后从位点续读,配合下游幂等即可闭环。
有界型 Source:文件、Hive 表这类"读完即止"的数据集。它们天然可重放(文件就在那),批式回溯与流式接入的语义都好办,关键是把有界性声明清楚(第 1 章讲过:有界是数据的属性)。
不可重放型 Source:某些 socket 流、部分第三方推送接口,数据读出即消费,断了就真丢了。它们只能承诺至多一次,永远不该出现在关键链路的起点。
// 位点型 Source 的标准姿势:位点交给检查点托管,消费组只做监控用途 KafkaSource<Order> source = KafkaSource.<Order>builder() .setBootstrapServers("broker1:9092,broker2:9092") .setTopics("orders") .setGroupId("dashboard-monitor") // 组ID仅用于运维观测,提交位点不作为恢复依据 .setStartingOffsets(OffsetsInitializer.committedOffsets(OffsetResetStrategy.LATEST)) .setValueOnlyDeserializer(new JsonDeserializationSchema<>(Order.class)) .build();
Sink:三级语义对号入座
Sink 的语义看"故障重放后,同一条数据写两次会怎样"。三级分级:
至多一次级:写入即忘,不参与两阶段提交、无幂等键。重放后结果缺失或重复无保障,仅用于可容忍丢失的旁路(监控打点之类)。
幂等级( effectively exactly-once):写入带唯一键,重放时新值覆盖旧值——Elasticsearch 的文档 ID、按主键 upsert 的 JDBC、按主键写的 OLAP 引擎。重复写不产生重复行,账面对得上。大多数业务场景的最优解在这里:实现简单、语义够用、无需协调事务。
事务级:写入走两阶段提交——预写入在检查点完成时提交、失败即回滚,Kafka 的事务生产者、带提交协议的文件 Sink 是代表。它是唯一的"真"精确一次:下游读到的结果要么全有要么全无。代价是可见性延迟(结果要等检查点完成才对外可见)与事务协调开销。
| 需求形态 | 推荐 Sink 形态 | 语义承诺 | 注意事项 |
|---|---|---|---|
| 实时大屏、报表 | OLAP 引擎按主键写 | 幂等 | 主键设计即对账口径 |
| 检索、画像 | Elasticsearch 文档 ID | 幂等 | ID 稳定性是生命线 |
| 下游继续流式消费 | Kafka 事务写 | 真精确一次 | 可见性延迟 = 检查点间隔 |
| 告警推送、Webhook | 普通写入 | 至多或至少一次 | 由接收端去重兜底 |
图 7-1 连接器生态版图与语义分级
选型四问的实战用法
把四问清单用在两个典型评审场景。场景一:大屏链路评审,上游 Kafka 位点型(一问答:重放位点回卷),下游 OLAP 主键模型(一问答:重放覆盖),吞吐按峰值三倍压测(二问),schema 由 Flink SQL 的类型声明约束(三问),延迟要求秒级(四问留出批量余地)——四问过关,方案定稿。场景二:财务对账链路,下游不能容忍中间可见的半成品状态,评审升格为事务级文件 Sink,接受检查点间隔的可见性延迟——四问之外多了一问"下游读方能否接受延迟可见",这正是事务级的入场券。
⚠️ 常见坑:把 Kafka 消费组位点当恢复依据。位点型 Source 的恢复真相应来自检查点里的内部位点,消费组提交的 offset 只作运维观测;两者混为一谈的团队,在"手动改了消费组位点"时制造出过不少对不上账的悬案。
幂等的细节:主键设计决定成败
"配个幂等 Sink"听起来一行配置的事,真正的功夫在主键设计上——幂等的语义承诺,全部压在主键的稳定性与唯一性上。三个来自生产的设计要点。要点一:主键必须对应业务身份,而不是随意的技术列。大屏案例里用"窗口起点加商户"做主键,退款与补单改写的是同一行,修正语义天然成立;若错用流水号做主键,修正会变成新增行,对账时翻倍。要点二:主键要防抖动——窗口起点这类由时间切出来的字段,必须保证同一窗口的同一键在重放时算出完全相同的值;用处理时间切窗再写下游,重放时窗口起点漂移,幂等就失效了。这也是事件时间在 Sink 层的又一层意义。要点三:主键粒度对齐读取口径,下游按什么粒度查,主键就按什么粒度收——粒度过细产生冗余行、过粗则修正时覆盖范围过大,两端都要掂量。
主键之外还有一条运维要点:幂等写入的吞吐上限受下游主键写入能力约束,热点键的连续更新会在下游形成行级竞争。设计评审时让 DBA 一起看主键,是连接器选型环节里性价比最高的一次协作。
本节要点
- Source 的分水岭是可重放性:位点型、有界型可进关键链路,不可重放型只配旁路。
- Sink 三级语义:至多一次进旁路,幂等级是多数业务的最优解,事务级留给读侧严格无损的场景。
- 端到端精确一次的实务配方:位点型上游 + 引擎快照 + 幂等下游;事务级是少数场景的加购项。
- 选型四问:语义、吞吐、schema 演进、延迟预算;每问都要有书面答案。
上游合同签好了。下一站走进改变游戏规则的 CDC:数据库的变更日志如何直接变成流。