7.2 Flink CDC:把变更日志变成流
7.2 Flink CDC:把变更日志变成流
本节摘要:CDC(变更数据捕获)把数据库的 binlog 直接变成 Flink 的数据流,让"数据同步"从定时搬运变成实时订阅。本节讲清 CDC 相对旧式同步的根本差异、Flink CDC 无锁快照加增量续读的机制、整库同步与 schema 演进的实务要点。读完你应能判断哪些表适合 CDC、如何安全地跑通第一条整库管道。
早期数据同步的搬运工时代
早期做数据同步,思路是当搬运工:定时任务每隔几分钟扫一遍源表,按更新时间戳或全量比对找出差异,批量搬到目标端。这个模式有三宗原罪——延迟以分钟到小时计、比对过程压垮源库、删除与更新混在一起时对账永远差一口气。数据库明明自己记着每一笔变更(binlog),同步却要"考古式"地猜,这本身就是个设计错误。CDC 把范式掰了过来:订阅变更日志本身。数据库的每一次 INSERT、UPDATE、DELETE 都是一条自带前因后果的事件流,搬运工下岗,订阅制上岗。
Flink CDC 的机制:快照加增量
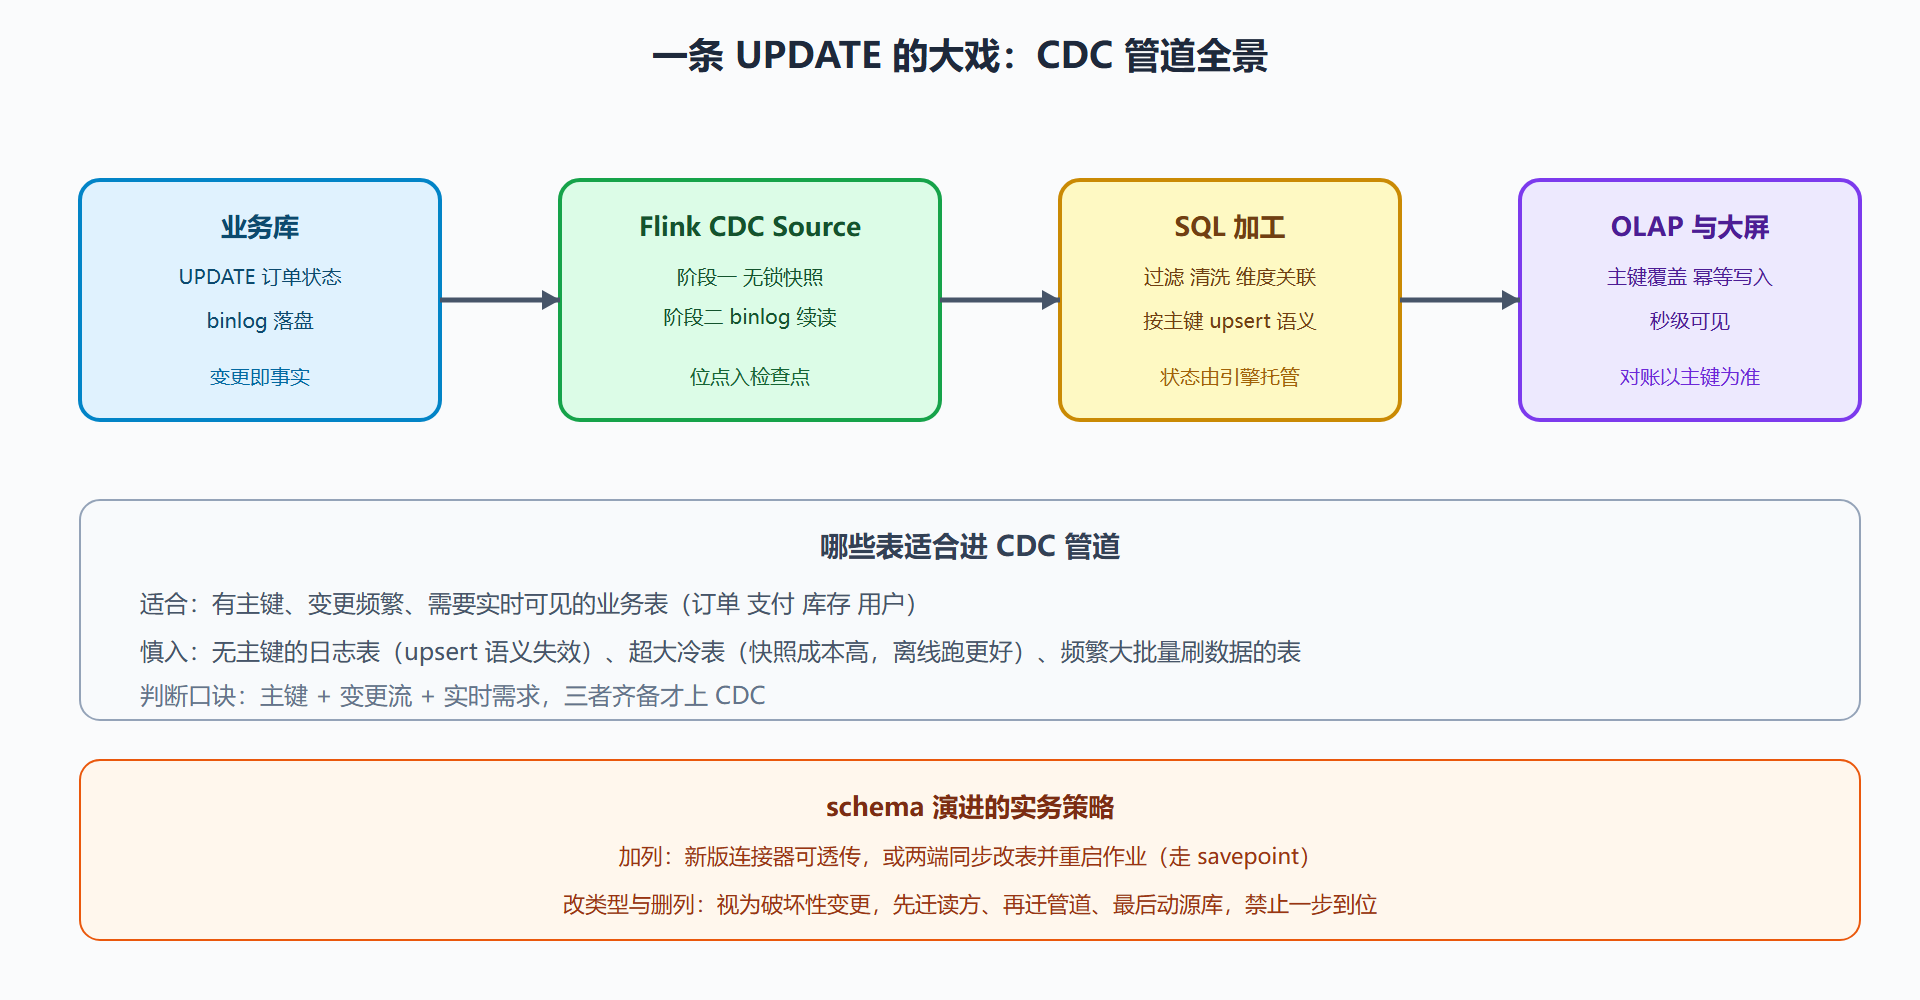
Flink CDC 连接器把"订阅"做成了 Source,工作分两个阶段。阶段一:一致性快照。作业启动时,连接器按主键把源表切块,多并行度地扫描存量数据,同时记录此刻的 binlog 位点——这个"边拍全家福边记时钟"的设计,保证存量与增量的接缝处不重不漏。较新的实现用无锁算法完成这一步:靠 binlog 回放修正快照期间的变更,全程不给源表加全局锁,对业务库的冲击降到可以忽略。阶段二:增量续读。快照完成后,连接器化身为 binlog 订阅者,从记录的位点持续读取变更,转成 changelog 流交给下游。改动一行,下游立刻知道改了什么、旧值是什么。
用 SQL 跑通一条同步管道的全部代码如下——没有搬运脚本,没有比对逻辑,一条声明:
-- 定义 CDC 源表:订单库的全部变更订阅在这里 CREATE TABLE orders_source ( id BIGINT, user_id BIGINT, amount DECIMAL(10, 2), status STRING, pay_time TIMESTAMP_LTZ(3), PRIMARY KEY (id) NOT ENFORCED -- 主键声明:upsert 语义的锚点 ) WITH ( 'connector' = 'mysql-cdc', 'hostname' = 'db-host', 'database-name' = 'shop', 'table-name' = 'orders', 'username' = 'cdc-reader', 'scan.incremental-snapshot.enabled' = 'true' -- 无锁增量快照 ); -- 写入端:按主键 upsert 到 OLAP 引擎,与上游变更一一对应 INSERT INTO olap_orders SELECT * FROM orders_source;
主键声明值得单独强调:它让 CDC 表成为 upsert 流——每条变更带着主键与新旧值,下游按主键覆盖,天然幂等。第 7.1 节的语义分级在这里闭环:CDC 源(可重放:binlog 位点在检查点里)加 upsert Sink(幂等),一条端到端精确一次的同步管道就此成型。
图 7-2 CDC 管道全景:从 binlog 到大屏
整库同步与 schema 演进
Flink CDC 的"整库同步"模式把批量建管道的成本也省了:一条配置订阅整个库的 table-list,引擎按表自动分流到下游对应的目标表。整库同步适合中小的业务库整体入湖入仓;大库则建议按业务域拆分管道,故障半径与升级节奏都更可控。
schema 演进是 CDC 运维的头号坑。务实策略是分级处理:加列是最常见的演进,新版连接器支持把新列透传到下游(或显式升级两端后走 savepoint 重启);改类型与删列一律按破坏性变更走三步迁移——先让读方兼容新旧两态,再升级管道,最后动源库。把这套流程写进 DDL 规范,比事后救火便宜一百倍。
💡 关键直觉:CDC 的本质是承认"数据库已经是流的源头"。当同步从搬运变成订阅,延迟从小时掉到秒,对账从考古变成对日志——很多"数据质量问题"在架构换轨的那一刻就消失了。
大表快照的实操手册
CDC 落地时最先撞上的现实问题是大表快照:一张十亿行的历史表,快照要扫多久、对业务库压多大、中断了怎么续。实操手册五条。第一条:切分粒度预演。连接器按主键把表切成块并行扫描,块大小决定并行度与断点粒度;超宽表先在测试环境预演切分数量,块太大会拉长单块扫描、太小则元数据开销上升。第二条:错峰启动。快照的读压力是真刀真枪的全表扫描,尽管无锁实现已经温和,仍建议在业务低谷启动作业,让最重的扫描阶段避开交易高峰。第三条:断点续扫是常态不是意外。快照中途作业失败,重启后从已完成的块继续,不必推倒重来——理解这一点能避免"快照失败就慌着回滚"的过度反应。第四条:快照与增量的接缝验证。快照完成进入增量阶段的时刻,用一行测试数据跨接缝写入,确认既没丢也没重——这一条验证的是连接器位点管理的正确性,上线前的必做动作。第五条:给业务库留水位。快照期间源库的读 IO 与 binlog 拉取都有增量,DBA 侧提前知情、留出余量,是数据团队与业务团队的君子协定。五条合起来的心法只有一句:把大表快照当成一个需要项目管理的技术动作,而不是一条配置。
最后补一条监控要点:CDC 作业要单独盯着两个指标——快照阶段的扫描速率(块切分是否均匀、有无卡住的单块)与增量阶段的 binlog 拉取延迟(当前位点落后源库写位点的距离)。后者一旦持续增长,意味着消费追不上产生,先查下游反压再查源库 binlog 保留策略——binlog 被源库按保留期清掉而作业还没读到,是 CDC 运维里最被动的事故,监控到位就永远不会发生。
本节要点
- CDC 把同步从"定时比对搬运"升级为"订阅变更日志",延迟、一致性、源库压力三项全面占优。
- Flink CDC 两阶段机制:无锁一致性快照 + binlog 增量续读,接缝不重不漏,位点托管在检查点。
- 主键声明让 CDC 表具备 upsert 语义,配合幂等 Sink 构成端到端精确一次的同步管道。
- 表的准入口诀:主键、变更流、实时需求三者齐备;无主键表与超大冷表绕行。
- schema 演进分级处理:加列可透传,改类型删列走三步迁移,写进规范防救火。
管道两端的接口都通了,还差最后一块拼图:表与库的"户籍"谁来管。下一节进入 Catalog 与元数据。