5.3 边缘智能与 TinyML
5.3 边缘智能与 TinyML
本节摘要:TinyML 让微控制器在本地跑起神经网络推理:不用联网、毫瓦级功耗、毫秒级响应。本节先划清"什么问题适合端上跑模型、什么问题不适合"的边界,再走一遍从采集标注、训练、量化到部署的完整流程,并用一个电机异响检测项目演示全链路——同时算清内存与延迟两笔账。
前两节的数据链路终点是"数值":一个滤波后的角度、一个可信的估计值。这一节把终点再推一步——直接输出"判断":这是不是异常音?这串振动像不像轴承磨损?它站在第 5 章的收尾位置,因为 TinyML 吃的正是前两节产出的干净数据;垃圾特征训练出的模型,只是把垃圾记住了。
模型跑上单片机,图的是什么
云端模型很强,但把数据送上去有三个绕不开的代价:隐私(音频、影像出设备即敏感)、延迟(联网往返几十到几百毫秒)、功耗(无线发射是深眠的千倍)。TinyML 的存在理由就是这三个"不划算":判断要在本地做、立刻做、省电地做。
但它不是万能锤子。适合端上模型的问题长这样:输入是时序或频谱模式(音频关键词、振动波形、电流纹波),类别数不多(两到十类),误报的代价可控,且样本能现场采集。不适合的长这样:需要复杂推理与世界知识(那是大模型的活)、类别几百种、或者一个 if 加阈值就能解决——能用阈值解决的不要上模型,模型是最后一张牌,不是第一张。
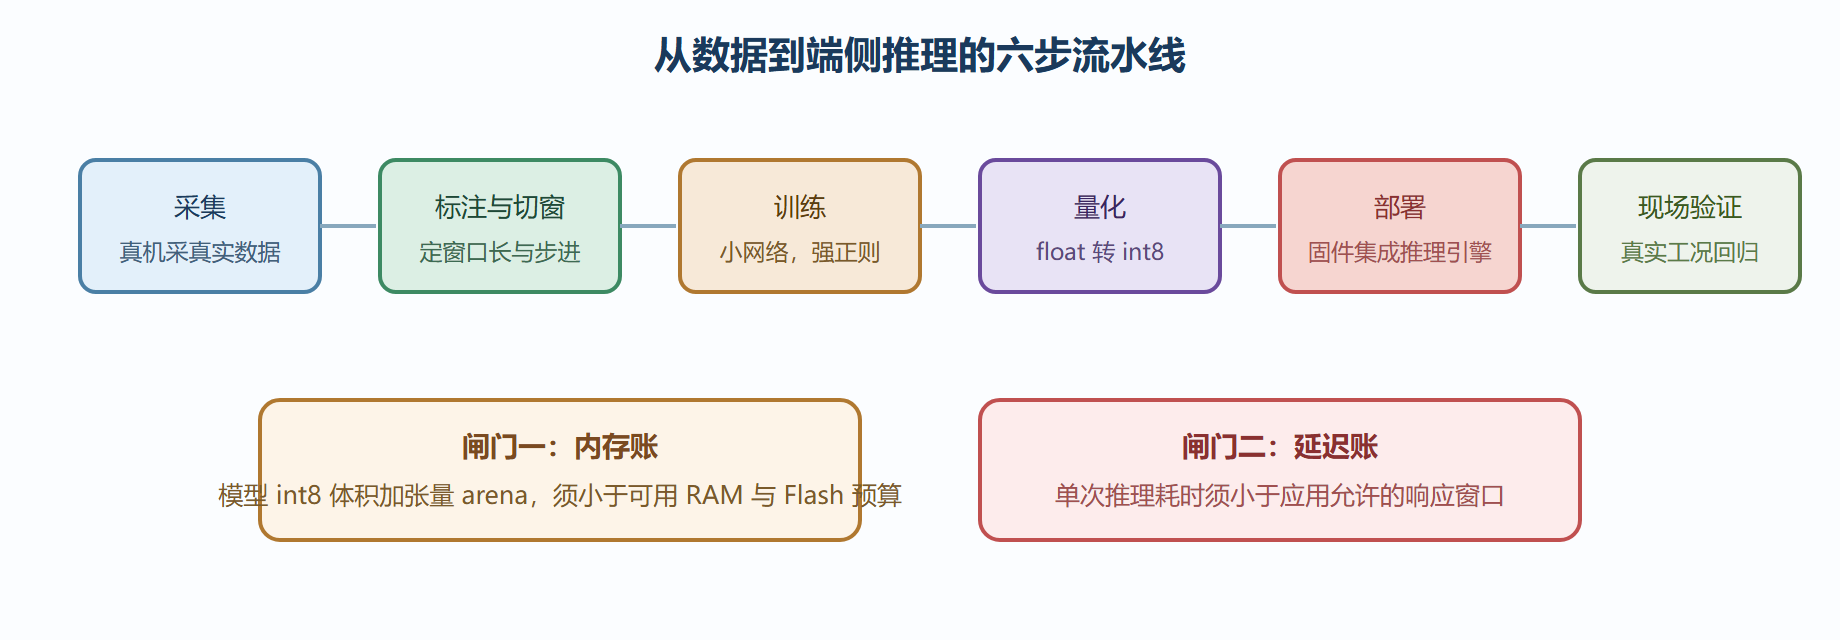
图:TinyML 项目的完整流程与两道闸门
量化:int8 是微控制器的通行证
训练出来的模型默认是 float32,在无浮点单元的微控制器上既慢又占地方。量化把权重与激活压到 int8:体积缩到四分之一,多数 MCU 推理提速数倍,精度损失通常在百分之一量级——这笔交换在端侧几乎是白捡。部署侧的主流方案(TensorFlow Lite for Microcontrollers 及各类工具链)都把 int8 当一等公民,量化后的模型连同推理引擎一起编进固件。
内存要按三笔算:模型本体(int8 后几十到几百 KB,放 Flash)、张量 arena(推理的中间结果区,必须放 RAM,通常是最大一层激活的尺寸)、输入缓冲(特征窗口)。ESP32 有几百 KB RAM 相对宽裕;AVR 那 2KB 就基本告别神经网络了——这不是伤感,是选型现实,第 1 章的选型表在此兑现。
案例:电机异响检测的完整落地
背景:产线传送带电机需要"听音辨障":轴承磨损的早期异响人耳难辨,希望设备在本地实时判断,异常时立刻停机并上报,不允许依赖网络。
操作:第一步采集——振动传感器贴在电机外壳,分别录制正常、轴承磨损、联轴器松动三种状态各半小时,覆盖空载与负载。第二步切窗标注——按 0.5 秒窗口切分,每个窗口提取 FFT 频谱特征(能量集中在哪个频段,正是 5.1 节采样定理的用武之地,采样率取 2kHz)。第三步训练——两层一维卷积加全联接,参数量压在 3 万以内,正常样本占七成以贴合实际比例。第四步量化部署——int8 量化后模型本体 34KB,张量 arena 22KB,放进 ESP32 绰绰有余;单次推理实测 6 毫秒。第五步现场验证——重点测误报:把传送带启停的冲击、旁边电机的串扰都喂给模型,前两周按"连续三个窗口异常才报警"的策略抑制误触发。
结果:现场运行六周,三次轴承早期磨损全部在人工听出之前报警,误报每千小时不到一次,停机判断全程离线。
解读:这个项目的成败手不在模型——网络本身平平无奇——而在数据与策略:采集覆盖了真实工况的全部状态(而不是实验室干净数据),FFT 特征把 5.1 的采样知识与领域知识(轴承故障有特征频率)编码进输入,报警策略用时间维度换单窗精度。TinyML 项目里,模型只占三成工作量,剩下七成是第 5 章前两节的老手艺。
变式:若问题再简单些(比如只需判断"振动是否超常"),连模型都不必上:把频段能量阈值化就是完整的异常检测。反之若要做语音命令词识别这类序列问题,特征与网络结构换掉,本节的流程骨架原样适用——流程的通用性正是 TinyML 工程方法的含金量。
// TFLite Micro 推理循环骨架(ESP32,特征已按窗口备好) #include "model.h" // 量化后的模型数组 #include <TensorFlowLite.h> #include "tensorflow/lite/micro/micro_interpreter.h" #include "tensorflow/lite/schema/schema_generated.h" constexpr int kArenaSize = 22 * 1024; static uint8_t tensorArena[kArenaSize]; tflite::MicroInterpreter* interpreter; void setupInference() { const tflite::Model* model = tflite::GetModel(model_data); static tflite::MicroOpResolver resolver; // 注册模型所需算子 static tflite::MicroErrorReporter reporter; interpreter = new tflite::MicroInterpreter( model, resolver, tensorArena, kArenaSize, &reporter); interpreter->AllocateTensors(); // 关键一步:arena 布局 } void loop() { if (windowFilled()) { // 0.5 秒特征窗就绪 float* input = interpreter->input(0)->data.f; fillFeatures(input); // 特征写入输入张量 uint32_t t0 = micros(); interpreter->Invoke(); // 单次推理 float score = interpreter->output(0)->data.f[1]; reportScore(score, micros() - t0); // 分数与耗时一并上报 } }
骨架的三处要害:AllocateTensors 是 arena 的分配时刻,内存不足在这一步报错;Invoke 前后计时让延迟账有实数可查;输出分数连同耗时一起上报,现场调阈值时才有依据。
⚠️ 常见坑:训练数据的采集环境与部署环境不一致,是端侧模型翻车第一名。实验室安静桌面采的音频,到了有风扇噪声的机柜里判若两物——采集就在部署现场做,或至少覆盖部署环境的干扰底噪。
💡 关键直觉:TinyML 的本质是"把一个领域专家的判断模式压缩进几十 KB"。专家见过的工况你都要采到,模型才有他那样的直觉。
本节要点回顾
- 端上跑模型图三样:隐私、延迟、功耗;阈值能解决的绝不劳驾模型;
- 六步流水线两道闸门:内存账(模型加 arena)与延迟账,动笔前先算;
- int8 量化是通行证:体积四分之一、速度数倍、精度损失百分之一量级;
- 数据七成模型三成:覆盖真实工况的采集与时间维度的报警策略决定成败;
- 推理分数连同耗时上报,阈值调整才有据可依。