7.1 系统调试与诊断
7.1 系统调试与诊断
本节摘要:设备交付之后,你和它之间隔着一座城市。这一节把"调试"从开发期的串口打印,升级为交付期的三层可观测体系:本地日志管开发期,黑匣子管崩溃后,远程诊断管现场期。讲清每层记什么、不记什么、怎么控制开销,并用一次现场故障的远程归因全程演示体系的价值——目标是让每个故障都能在不开机箱的情况下定位到模块。
全书六章把功能立起来了,交付阶段的第一课却是承认反面:功能一定会出问题,问题只是出在哪、能不能查清。7.1 放在章首,因为可观测性是后续功耗、性能、可靠性工作的地基——测功耗要有日志配合打标,烤机归因要靠黑匣子,没有它,7.4 的测试只能数"坏了几台",说不出为什么坏。
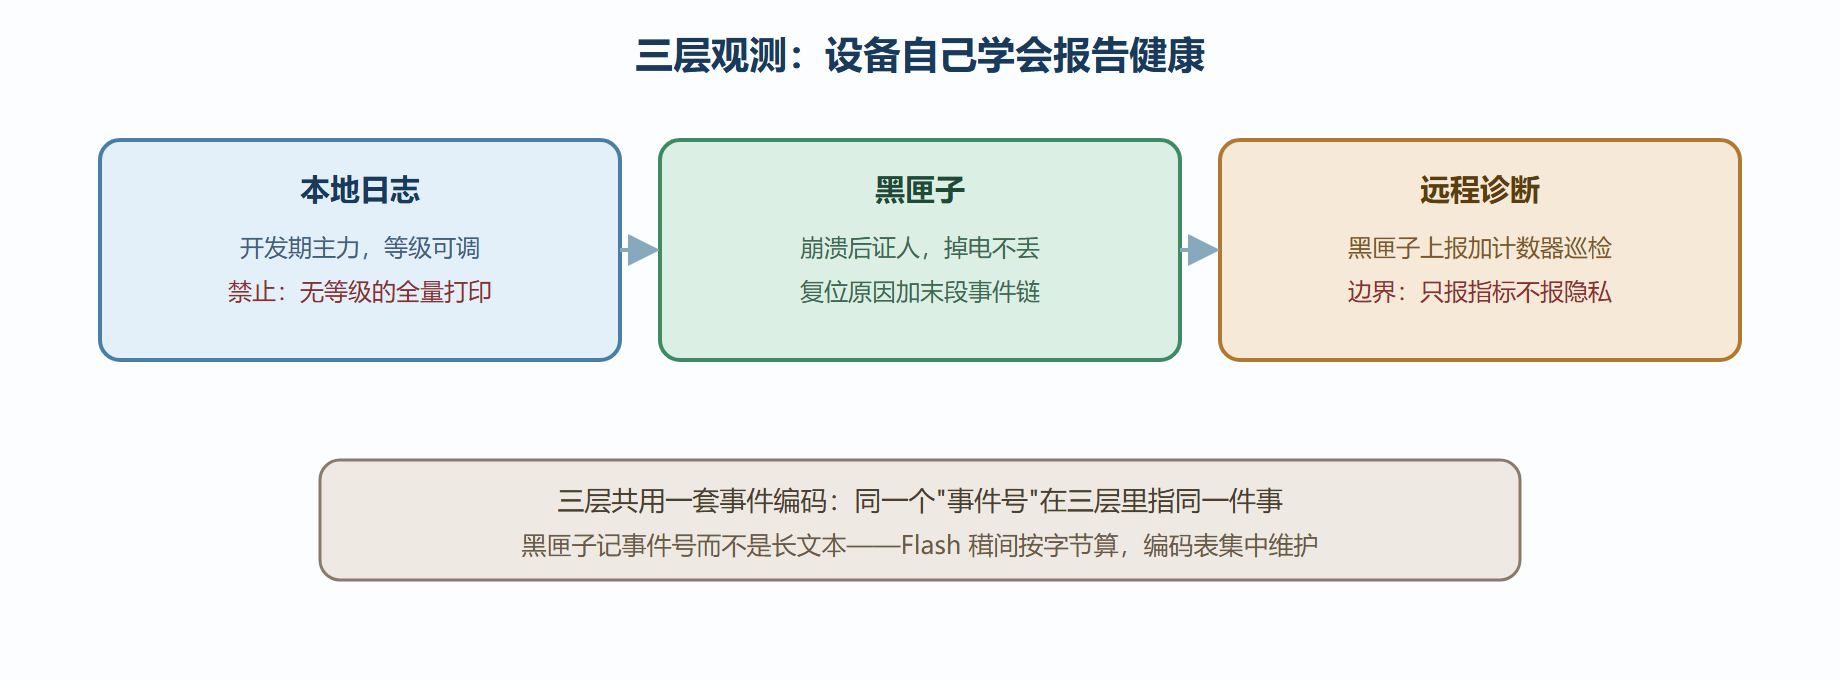
从打印到体系:三层观测各司其职
第一层,本地日志:开发期的主力,串口输出加上等级控制(错误、警告、信息、调试四档)。它的纪律是等级要能动态调整——现场保留错误与警告,排查时临时开调试级,而不是把四级全量打印塞进每一版固件。
第二层,黑匣子:崩溃后的证人。把复位原因、最近 N 条关键事件、崩溃时的任务状态写进 Flash 保留区或 EEPROM,重启后可读出。1.3 节读复位原因的代码就是黑匣子的第一行;完整的黑匣子再加上"崩溃前的最后几步",把"随机重启"升级为"可复现的线索链"。
第三层,远程诊断:现场的眼睛。黑匣子内容随遥测上报、关键计数器(重启次数、看门狗触发数、缓冲区丢弃数)周期上报、支持远程拉取日志。它的边界是隐私与流量:只报指标与事件,不报原始数据——除非明确获准。
图:三层观测体系的分工与数据流
黑匣子的存储纪律
黑匣子写进 Flash 有一个绕不开的物理约束:擦写寿命。 NOR Flash 一个扇区约十万次擦写,黑匣子若每次事件都原地覆盖,几个月就能写穿。工程解法是环形写入:把一块扇区当环形带用,写满从头覆盖,写放大摊到全扇区,寿命延长两个数量级。另一个纪律是记编号不记长文:"事件 0x21:队列满丢弃"在代码里是一张编码表,Flash 里只有一个字节——存储空间按字节计价,长文本是奢侈品。
// 极简黑匣子:环形写入,记录事件号与毫秒时间戳 #define BLACKBOX_SLOTS 64 struct BbEntry { uint32_t ms; uint8_t code; }; static BbEntry bb[BLACKBOX_SLOTS]; // 实际项目映射到 Flash 保留区 static uint8_t bbIdx = 0; void bbLog(uint8_t code) { // 中断外调用:写一条事件 bb[bbIdx].ms = millis(); bb[bbIdx].code = code; bbIdx = (bbIdx + 1) % BLACKBOX_SLOTS; // 环形推进,写满自动覆盖最旧 } void bbDump() { // 重启后调用:倒序回放最近事件 Serial.println("---- 黑匣子回放 ----"); for (int i = 1; i <= BLACKBOX_SLOTS; i++) { uint8_t idx = (bbIdx + BLACKBOX_SLOTS - i) % BLACKBOX_SLOTS; if (bb[idx].code == 0) break; // 空槽即到底 Serial.printf("%lus 事件 0x%02X\n", bb[idx].ms / 1000, bb[idx].code); } }
写入是常数时间、无动态分配、可重入性靠调用约定保证(中断里不调用)。这套 sixty 行的黑匣子够多数项目用;更完整的版本加上写入 Flash 的批量落盘与掉电保护,再往 6.4 节的断电纪律上靠。
案例:一次现场故障的远程归因
背景:交付三个月后,某站点设备每周重启一到两次,现场无人在,售后只会说"断电重启就好了"。
操作:第一步,云端拉取设备的诊断包:黑匣子回放显示每次重启前都有"事件 0x35:I2C 总线超时"连续出现;重启原因寄存器显示看门狗复位。第二步,对照编码表定位事件源:传感器采集任务在等 I2C 应答时用的是无限等待标志位——总线被干扰卡住后,任务永久阻塞,看门狗收不到喂狗被迫复位(第 2 章的 I2C 知识与第 4 章的看门狗知识在此会合)。第三步,远程推送带修复的固件(6.4 节的 OTA):等待改为带 3 次重试与超时退出,超时后把总线复位逻辑跑一遍。
结果:固件更新后该站点与另外三个同型号站点,八周零重启。诊断包被纳入交付标配。
解读:复盘这起故障的时间线:故障发生在现场,归因发生在办公室,修复发生在云端——全程没有拆机、没有回寄、没有工程师出差。三层观测体系的价值不是"多了些日志",而是把故障处理的成本从现场移到了服务端,规模化交付后这笔账是数量级的差别。
变式:诊断体系自身的故障也要设防:黑匣子写坏、日志撑爆存储、上报把带宽吃光——给每层观测都加预算上限与自检,是体系化最后的一步,也是多数项目漏掉的一步。
⚠️ 常见坑:日志与业务共抢串口缓冲。高频日志会把业务串口(比如与模组的通信)挤丢——诊断通道与业务通道物理分开,或在固件里给日志限速。
💡 关键直觉:可观测性不是"多打日志",而是"故障发生时,设备已经替你问好了那几个为什么"。设计日志时的标准姿势:想象半年后的某个凌晨它坏了,你需要哪几条信息才能不开机箱定位——现在就把这几条埋进去。
诊断包的标准构成
远程归因要快,诊断包的内容就得标准化。一台设备的完整诊断包包括五块:身份块(设备型号、固件版本、硬件版本、序列号)、当前态(运行时长、任务水位、空闲堆、最近复位原因)、黑匣子(最近数十条事件与对应时间戳)、计数器组(重启次数、看门狗触发数、缓冲丢弃数、总线错误数、升级次数)、配置摘要(关键配置项与校验和)。五块合计控制在几 KB 内,一条遥测就能带走。
这套清单的价值在于"可比":现场出问题时,把故障设备的诊断包与正常设备的放在一起逐项对——差异处往往就是答案。诊断包的格式要版本化(第一字段是格式版本号),因为固件会迭代、云端解析不能断。把诊断包当成产品的一部分来设计与评审,而不是排查时的临时拼凑,远程归因的效率差出一个数量级。
本节要点回顾
- 三层观测各管一段:本地日志管开发、黑匣子管崩溃后、远程诊断管现场期;
- 黑匣子记事件号不记长文,环形写入摊平擦写寿命;
- 复位原因、末段事件链、关键计数器是诊断包的三件套;
- 看门狗复位是阻塞的最后证人:它触发时,先查谁的等待没有超时;
- 观测体系自身也要预算与自检,别让体检项目自己生病。