7.3 性能优化策略
7.3 性能优化策略
本节摘要:优化是把资源用在刀刃上的手艺,而手艺的第一戒律是先测量后动手。本节给出微控制器上时间与内存两类热点的定位方法,拆解算法级、数据结构级、平台级三层优化手段的差异,并用一次"采集频率上不去"的优化全程演示方法论——最后谈谈优化的伦理:够用即停,过度优化是另一种浪费。
7.2 节把电源预算定型了;这一节处理剩下的两类资源预算:时间与内存。它排在功耗之后、可靠性之前,因为性能定型是测试的前提——7.4 节的烤机必须跑在定型的性能参数上,否则测的是一团会变的影子。
先测量后动手,以及测量什么
优化的第一戒律人人会背,执行起来却常常走样——"我感觉这里慢"是最常见的开局。微控制器上的测量工具朴素得很:微秒级的 micros 打点量时间,堆栈水位与全局数组清单量内存,7.2 节的电流剖面量功耗。测量的产出物是热点排行:把一段典型工作周期的耗时按函数拆开排序,通常你会看到前两名吃掉八成时间——优化它们的收益,是优化第十名的一百倍。
两个测量陷阱提前排掉。其一,别在调试版固件上测:调试编译关掉了优化,性能可能与发布版差出数倍;测量要用发布编译参数。其二,别测单次:单次耗时抖动大,取一段工作周期内多次的分布(最小、平均、最大),最大值才是实时系统的命门——平均 2 毫秒最大 40 毫秒的函数,比平均 5 毫秒最大 6 毫秒的更危险。
图:三类热点与各自的药方
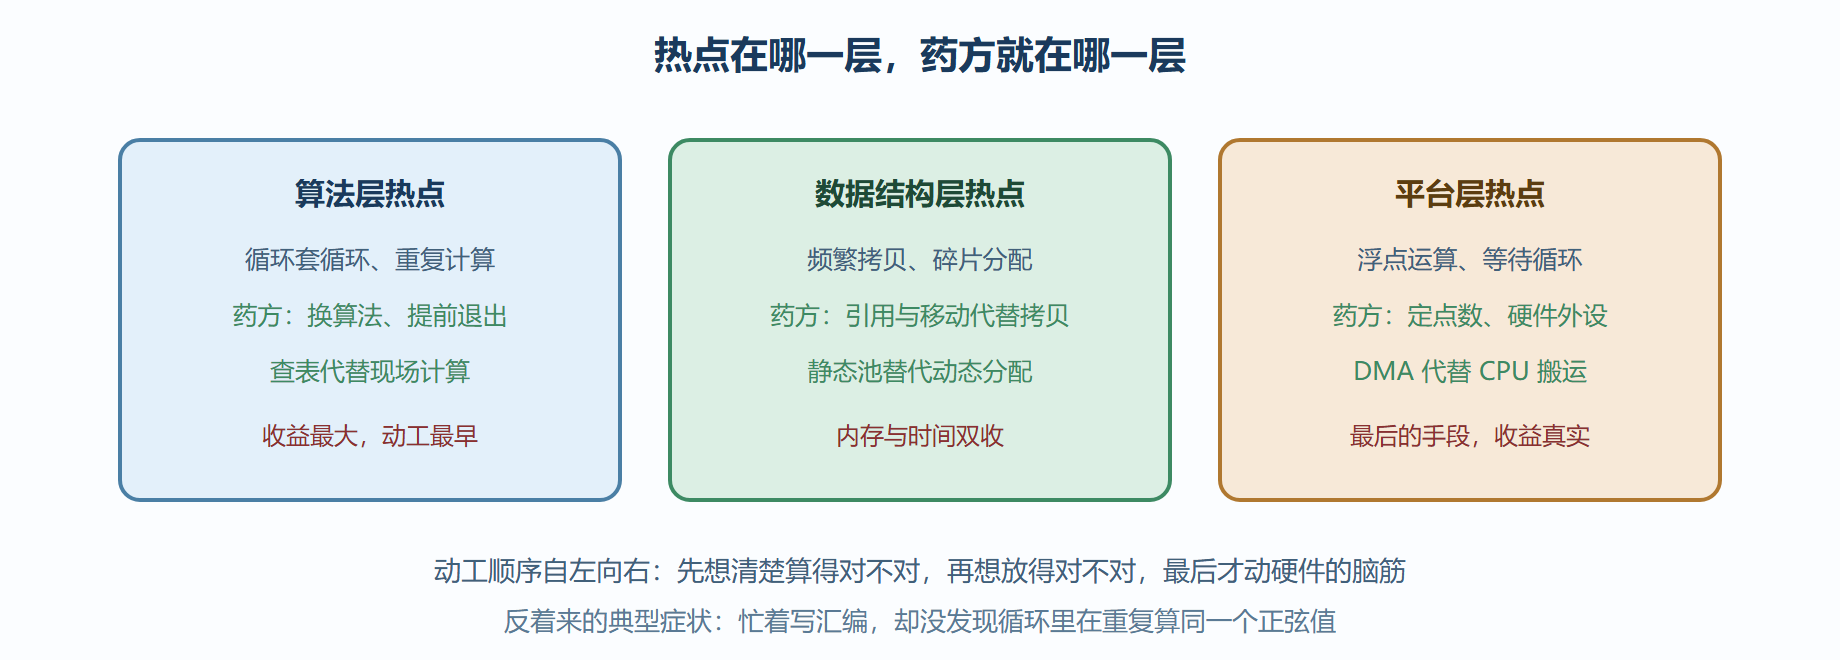
三层药方各自的用法
算法层的收益最大也最便宜:把 O(n²) 的重复比较换成一次哈希或排序,快于任何编译器把戏。嵌入式特色技巧是查表——正弦、CRC、伽马校正这类计算密集函数,预生成表放进 Flash,一次查表代替几十次浮点运算;表项精度不够就分段插值,用少量计算换大幅缩表。
数据结构层在微控制器上有一道铁律:静态优先。动态分配(malloc)的碎片会让本就小的堆走向慢性死亡,4.1 节的静态任务创建是同一哲学。拷贝也要精打细算:结构体按值传递的隐式拷贝、字符串的反复拼接,改成传指针或原地构造,时间内存双收。
平台层是最后的杠杆:AVR 上把 float 换成定点数(Q16.16 格式)能把乘法提速一个量级;能在硬件外设跑的绝不过 CPU 的手——2.2 节的硬件 PWM、第 3 章的 DMA 思路都是这个原则的兑现。
案例:采集频率上不去的优化全程
背景:一台振动监测器目标采样率 2kHz,实测主循环最高只能跑到 800Hz,且读数偶发跳变。
操作:第一步打点测量。一个工作周期的耗时分布:传感器读取 1.1 毫秒(占 88%)、滤波 0.08 毫秒、显示刷新 0.05 毫秒、其他 0.02 毫秒——热点一目了然,全在传感器读取上。第二步归因:读取走的是软件轮询加阻塞式 I2C,每次读取含总线等待 0.9 毫秒——慢的不是计算,是等待。第三步选药方:这属于平台层热点(等待循环),换硬件思路——传感器支持数据就绪中断脚,改为就绪中断加缓冲队列(第 2 章的中断缓冲),CPU 从"问十遍有没有好"变成"好了叫我"。第四步顺手治理跳变:排查发现轮询期间偶发的总线时钟拉伸被误读,中断化后自然消失。
结果:采样率稳定跑到 2kHz,单周期 CPU 占用从 88% 降到 9%,剩余算力还够跑 5.3 节的异常检测。
解读:这次优化的每一步都在验证方法论:打点测量让热点现形(猜的话多半会去优化滤波);归因发现是等待而非计算,药方就完全不同——优化等待的正确姿势是换同步方式,不是压缩计算。跳变问题作为搭车收获消失,也提示了一个规律:性能问题与正确性问题常常同源,轮询与阻塞就是它们共同的温床。
变式:若热点真的是计算(比如浮点矩阵乘),平台层的药方也换:选带 FPU 与 DSP 指令的芯片(第 1 章选型表里 ESP32-S3 的向量指令在此兑现),或者干脆把这段计算交给 5.3 节的量化模型换算成 int8。优化的尽头常常是选型——在错误的平台上优化,是在错误的路上狂奔。
⚠️ 常见坑:优化后不做回归测试。查表法的表生成错了、定点换算丢了精度,性能翻倍而结果全错——优化的每一步都要配等价性验证:同一输入,新旧实现输出必须一致。
💡 关键直觉:优化的第一问不是"怎么让它快",而是"能不能让它不用做"。砍掉一个不必要的功能,胜过把十个函数优化到极致。
一份优化记录该长什么样
优化最容易烂尾在"改了什么没人记得"。每个优化动作留一条结构化记录:动机(哪个指标不达标、实测数字)、假设(怀疑哪个热点、依据什么测量)、改动(换了什么方案、代码位置)、验证(优化前后指标对比加等价性回归结果)、结论(保留、回滚还是部分采纳)。五行记录,写下来不到两分钟,半年后复盘时价值千金。
团队层面再加一条纪律:优化要设验收线——开工前写明"采样率到 2kHz、CPU 占用低于 15% 即收工",到达即停。没有验收线的优化会自动滑向炫技:快了三毫秒还嫌不够,省了两百字节还想再省,而真正的交付日期在原地不动。性能优化是工程不是竞技,验收线就是工程与竞技的分界线——到了线就收工,把精力还给还没人管的可靠性测试。
内存优化的三个专项
时间之外,内存优化有几条微控制器专属的专项手艺。Flash 换 RAM:常量字符串、查找表、字体点阵放进 Flash(用相应存储修饰符),RAM 只留运行时数据——AVR 上这一招常能省下三成 RAM。缓冲区重审:每个缓冲区的深度都问一句"最坏要存几条"——串口缓冲 256 字节是抄来的习惯还是算出来的?按最坏一波数据量重算,超配的减半。栈与堆的配比:任务堆栈按水位实测收敛,协议栈与库的堆用量用运行时统计摸底,两者之外才是业务可用的余量——这笔账不清,后面的优化都是盲调。
专项优化之后要补一步整体验证:跑完整业务组合(联网加采集加显示同时工作)测最坏内存水位,因为单项优化都通过不代表组合峰值不超标。内存优化的验收标准只有一条:最坏组合下水位仍有两成余量。达不到就回去继续找,达到了就冻结——和性能优化一样,验收线就是收工线。
本节要点回顾
- 先测量后动手:发布编译参数、取多次分布、盯最大值,热点排行自己会说话;
- 药方分三层:算法层收益最大、数据结构层管内存、平台层是最后杠杆;
- 慢常常是等待不是计算:轮询阻塞的解法是换同步方式(中断加缓冲),不是压缩代码;
- 静态分配是微控制器的铁律,动态分配的碎片是慢性毒药;
- 优化后必须回归验证等价性,快而错不如慢而对。