第四章 自动化与扫描:Intruder 与 Scanner
第 4 章 · 自动化与扫描:Intruder 与 Scanner
本章要回答的三个问题:手工验证有效之后,怎么把手法交给机器批量执行,速率与范围由谁管?扫描器的"漏洞"结论是怎么得出的,误报从哪来、怎么压?团队的检测经验能不能沉淀成自定义规则,让扫描器按你的口径干活?
为什么会有这一章
第三章的判定纪律确立了一个标准:每个结论都要有单点变量的证据链。问题随即出现——靶场之外的真实评估里,参数成百上千,手工逐个重放的时间成本迅速失控。自动化模块的存在意义由此成立:把已经被人验证有效的手法,交给机器按相同标准批量执行。注意这句话的主谓关系——手法先被人确立,机器只负责执行,这是自动化与"一键黑盒扫全场"两种工作哲学的分水岭。
扫描器则站在另一个位置上。它不是你手法的放大器,而是行业知识的搬运工:内置的检测逻辑来自多年积累的漏洞模式,能在你尚未察觉的角落补上覆盖度。它的代价是误报与漏报的固有权衡——机器对"看起来像漏洞"的模式敏感,对"需要业务上下文才能判断"的问题迟钝。本章会带你在靶场上亲眼看清一次误报的诞生,此后你对扫描结果的态度会从"照单全收"或"全盘怀疑"变成"分级处置"。
读完能解决什么
- 为一次批量验证选对攻击位型,配置合理的并发与节奏,并把范围约束在作用域之内;
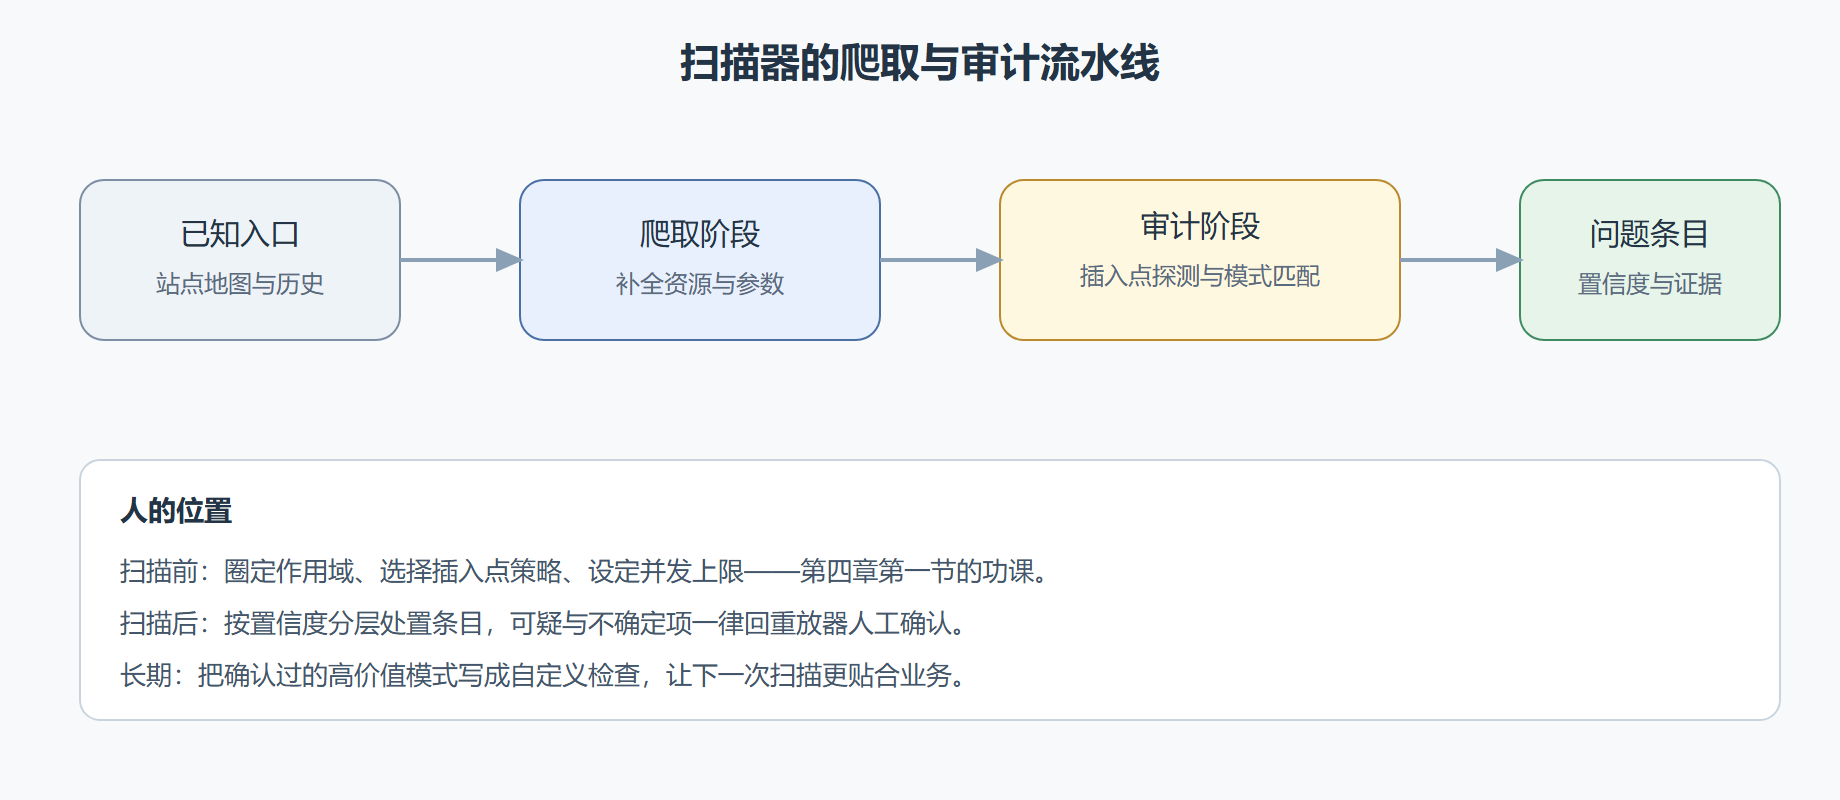
- 解读扫描结果的问题条目:置信度、证据、复现信息各指什么;
- 说清误报的三类来源,对扫描结果执行"机器候选、人工确认"的处置流程;
- 读懂 BChecks 的结构,把一条团队检测经验写成可运行的自定义检查。
本章知识点清单
- 攻击位型:单点、多点、集束各自的适用场景与配置方法;
- 载荷来源:简单列表、字典、递归替换,以及速率与并发控制;
- 扫描器构成:主动检查与被动检查、爬取与审计两个阶段、插入点选择;
- 结果分级:置信度体系、误报来源(时序型、上下文型、防御干扰型);
- BChecks 语法骨架:条件结构、检测逻辑、与内置检查的关系。
各节怎么分工
| 节 | 回答的问题 | 关键产出 |
|---|---|---|
| 4.1 Intruder 位型与速率 | 批量怎么跑、边界在哪 | 一次受控的批量验证 |
| 4.2 扫描引擎与漏洞识别 | 结论怎么来、误报怎么防 | 误报处置流程 |
| 4.3 BChecks 自定义检测 | 经验怎么沉淀成规则 | 一条可运行的自定义检查 |
图:从手工判定到批量执行再到覆盖补充
图:扫描流水线的两个阶段
高频疑问先行回答
问:扫描器能替代手工测试吗,或者替代到什么程度?
答:替代不了,能替代的部分是覆盖度的下限保障。扫描器擅长已知模式的广度覆盖,不擅长需要业务语境的判断——权限边界对不对、这个角色该不该看到这条数据,机器没有答案。成熟的分工是:扫描负责"别漏了常见问题",手工负责"回答机器回答不了的"。
问:批量测试和扫描器功能重叠吗,什么时候用哪个?
答:重叠在"自动化"这三个字上,分野在"谁设计探测"。批量模块执行你设计的探测,适合验证一个具体假设的多种变体;扫描器执行行业知识库的探测集,适合铺覆盖面。先手工确立判定标准,再用批量量化影响,用扫描补盲——这个次序别颠倒。
问:扫描会不会把靶场或目标搞挂?
答:有可能。扫描的本质是向目标发送大量构造请求,其中部分探测对脆弱实现有实际影响。所以第四章反复强调配置并发上限、扫描强度与范围,把扫描的"力道"当成和授权范围同级的严肃参数对待。靶场环境可以放开,任何真实环境都要先约定。
问:误报多是不是说明工具不行?
答:不是,误报是探测类工具的固有属性,源于机器缺乏业务上下文。工具差异体现在误报的结构化程度——置信度标签、证据展示是否让人复核起来省力。使用者的成熟度体现在处置流程:分级复核、批量降噪、经验沉淀成规则,这套流程第四章给了完整做法。
先决条件
- 第三章的两板斧已上手,至少完整走过一次重放判定;
- 专业版授权(扫描器与完整批量能力为付费功能,社区版可用手工方式跟进本章的判定逻辑);
- 靶场安全等级设为低中档,便于观察机器判定与人判定的差异。
往下走到哪
批量结果与扫描条目经人工确认后,就成了报告的原材料。第五章先讨论工具能力的最后一块拼图——扩展与自动化的边界,随后第六章把所有原材料加工成一份能推动修复的报告。