4.1 Intruder攻击类型与速率边界
4.1 Intruder攻击类型与速率边界
本节摘要:Intruder 把重放器的"单点修改"升级为"按位置批量替换":请求里标记占位,机器按攻击位型组合载荷逐个替换发送。本节讲清四种位型的选择逻辑、速率配置的责任边界,并用靶场上的单号枚举案例展示批量结果怎么读、怎么复核。
自动化的边界从速率开始
上一节的枚举变式留了个口子:连续单号手工验证太慢。批量模块接手前,先立两条规矩。范围规矩:批量目标必须在作用域内——扫描与枚举类流量的规模效应会放大任何范围失误,3.1 节圈定的作用域在这里是硬约束。速率规矩:并发与节奏由你设定,默认值不是安全值——对内网靶机可以放开跑,对委托方的生产系统则要在授权沟通时明确速率上限并写进配置。速率不是技术参数,是合同条款的执行细节。
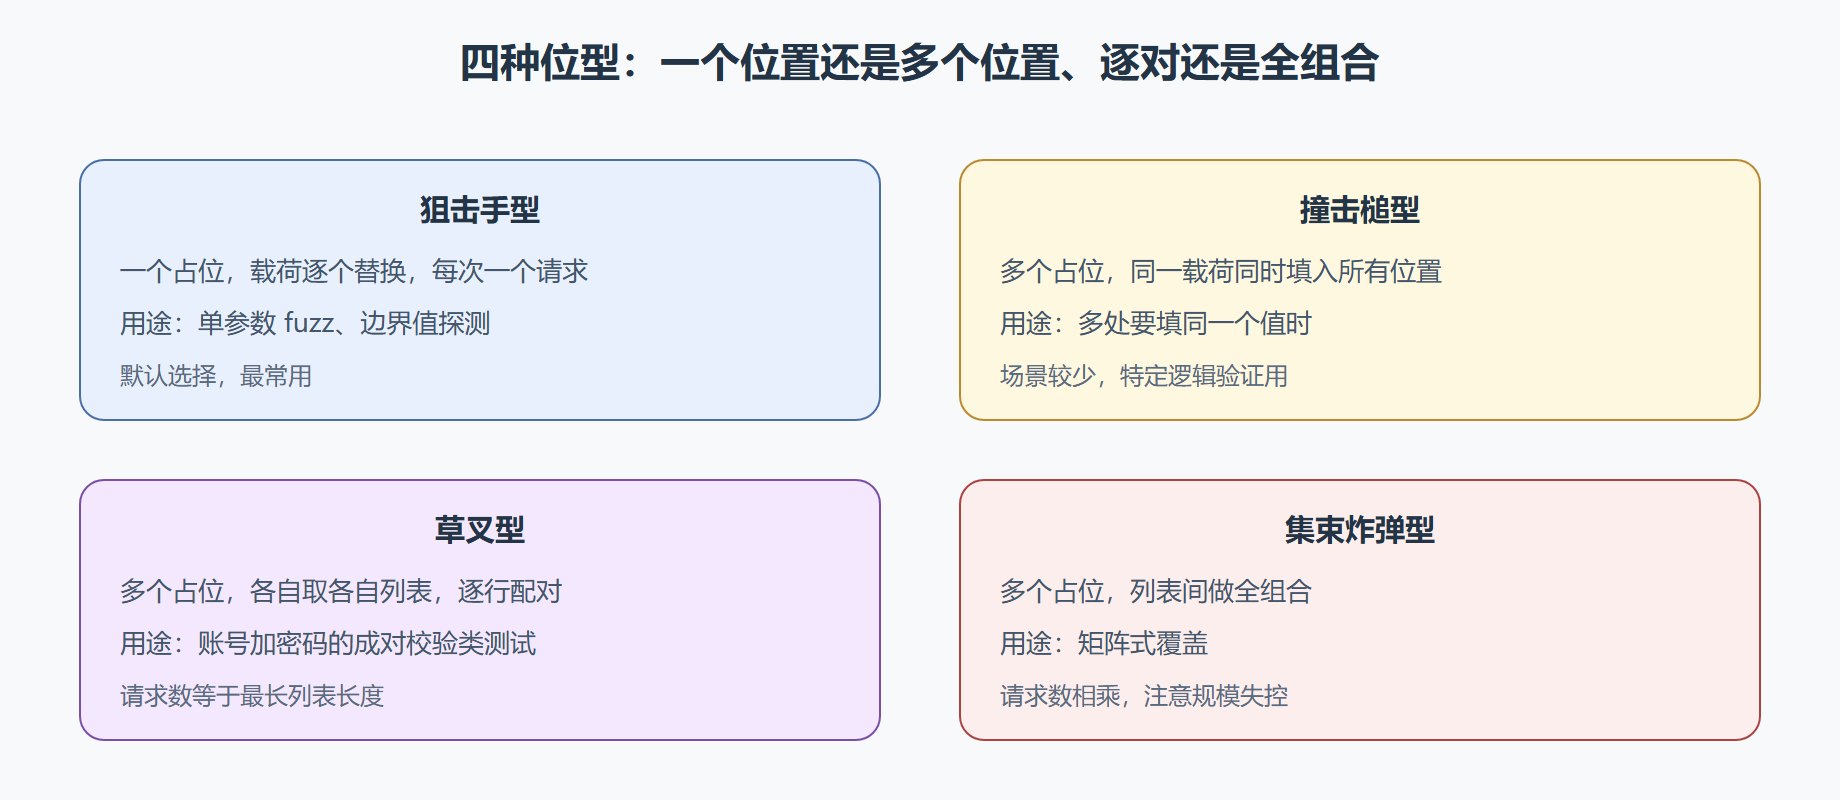
位型选择是第二个功课。占位标记决定"哪里会被替换",位型决定"用什么组合替换"。四种子型对应四类任务,选错位型的代价通常不是报错,而是默默跑出一堆无意义组合。
图:四种攻击位型的组合方式
案例实录:靶场单号枚举的量化
背景。3.2 节在重放器坐实了单号归属校验缺失,现在要回答报告里必然被问到的问题:影响面多大。
操作。把验证请求送入批量模块,占位标记在单号参数上,位型用狙击手,载荷选数字序列覆盖两个账号的单号区间,并发与节奏按靶机承受力设定。跑完后结果表按列排序——状态行、响应长度、特征匹配数。长度明显偏离群体的条目单独拎出。
GET /order/detail.php?order_id=§1001§ HTTP/1.1 Host: lab.local:8088 Cookie: PHPSESSID=lowprivsession
结果。区间内所有单号返回长度一致的"有单据"响应,而区间外随机抽样的单号返回统一的"无此单"短响应——两组长度边界清晰可分。
解读。长度列把"存在"与"不存在"切成两个群体,这正是批量结果判读的通用方法:先找一个能把结果分成两群的观察列,再看小群里的条目是否都能被重放器坐实。抽三条长度异常值回重放器复核,判定与 3.2 节一致,则整批结果可信度有依据。影响面结论随之成立:区间内全部单号可被任意低权会话访问。
变式。当判定依据从响应内容换成响应时间(时间型盲测的典型场景),批量结果的可信度会显著下降——宿主机的瞬时负载就能污染时间差。此时正确的做法是缩小批量规模、增加重复次数取均值,且对每条候选都用重放器单独复核。社区版限速在这类任务上反而友好:慢而稳的时间数据好过快而抖的。
结果复核的固定动作
批量结果进报告前有三个必做动作:抽样回放(每类异常条目至少抽几条在重放器复核)、去重归并(同一根因的多条命中合并为一个报告条目)、标注证据(把判定依据与代表性请求响应写入条目备注)。这三个动作做完,批量结果才算从"机器输出"变成"测试证据"。
⚠️ 字典类载荷在练习靶场随意,在真实评估中必须与委托方确认允许的字典规模与失败锁定策略——把对方账号批量锁死是真实发生过的事故类型。
载荷的来源与加工
占位与位型解决"往哪填、怎么配对",载荷解决"填什么"。载荷来源按可控性分几档:手工列表最可控,几十个边界值、特殊字符、标记串,适合精确验证;数字与日期序列适合枚举与区间探测,本节的单号案例即此类;字典适合存在性探测类任务,规模要与委托方约定(4.1 节开头的速率规矩在此生效)。载荷加工常被忽视却高价值:编码变换(对载荷做编码以满足目标解析)、前后缀拼接(给载荷加语法上下文)、按响应动态取舍(高级玩法,配合结果处理规则做半自动筛选)。这些加工的目的是让机器发出的每个请求仍是"一个明确假设的检验"——批量不等于乱枪。
结果表的进一步加工同样重要:除按列排序外,用结果过滤把"长度在正常区间"的群体直接隐藏,视野里只留异常群体;用分组功能把相近条目聚类;对候选条目加标记,批量结束后按标记逐条回重放。这一套"跑完再加工"的动作,是批量结果从数据变成证据的必经工序,与 4.1 节的三个固定动作配套。
规模估算:跑之前先算账
发起批量前的最后一步是规模核算:请求数等于各载荷规模的组合结果(单点位是载荷数,多点位按位型相乘或配对),再乘以平均响应耗时,得到总时长估算。这个习惯的价值有三层:超时的任务在配置阶段就调整,而不是跑了三小时后中断;目标侧的请求总量可以提前与委托方核对,写进授权沟通;估算与实际耗时的偏差还能反推目标的响应特征——批量本身就是一次对目标性能画像的测量。把"先算后跑"当成纪律,自动化就从危险动作变成了受控动作。
一次受控批量的完整清单
把本节的动作收成一张可直接执行的清单:作用域确认(目标在范围内);规模核算(请求数与预估时长);速率上限(默认值改掉,按约定设定);载荷审读(字典过一遍内容,确认没有越界词与真实凭证);试发三个(正式开跑前手动发三个载荷样本,确认请求构造正确);结果分群(跑完先找分群列再谈发现);抽样回放(异常群体回重放坐实);记录归档(任务配置与结果摘要入项目)。清单的价值在"试发三个"这一步——批量任务最贵的事故是跑完几万请求才发现占位标记标错了位置,三个样本请求就能拦住它。
高频疑问
问:批量跑完了,但结果里看不出可分群的迹象怎么办?
答:换观察列再试:长度之外看响应码、看特征匹配、看头部差异;仍不可分,说明该假设可能不成立或载荷设计不对,回到重放器用一个极端载荷验证探测思路本身是否有效。
问:并发开多少合适?
答:以目标可承受为准而不是以工具上限为准。靶场可以放满速跑;真实目标从保守值起步,观察响应延迟与错误率,与委托方约定的上限是硬顶。并发的调节过程本身就是对目标承载力的尊重。
问:批量与扫描器都在跑会互相干扰吗?
答:会叠加压力且日志互相混淆,不建议并行。时间安排上串行:先扫描铺覆盖,后批量做专项,各自的发现汇入同一张条目池。
与后续章节的接口
本节的批量是"你设计、机器执行";下一节的扫描器是"行业知识库替你补盲"。两者产出的条目汇入同一条处置流程:机器候选、人工确认。确认过的高频模式,4.3 节教你沉淀成自定义规则。
本节要点回顾
- 两条规矩:范围锁在作用域内,速率是合同条款的执行细节而非默认值。
- 位型:单点狙击手起步,成对草叉、全组合集束按需,选型错误=静默浪费。
- 判读:先找能把结果分群的观察列,异常群体抽样回重放坐实。
- 复核:抽样回放、去重归并、标注证据,三步后才配进报告。