第3章 · 数据建模与 CQL
第3章 · 数据建模与 CQL
章节摘要:CQL 是分布式契约语言:
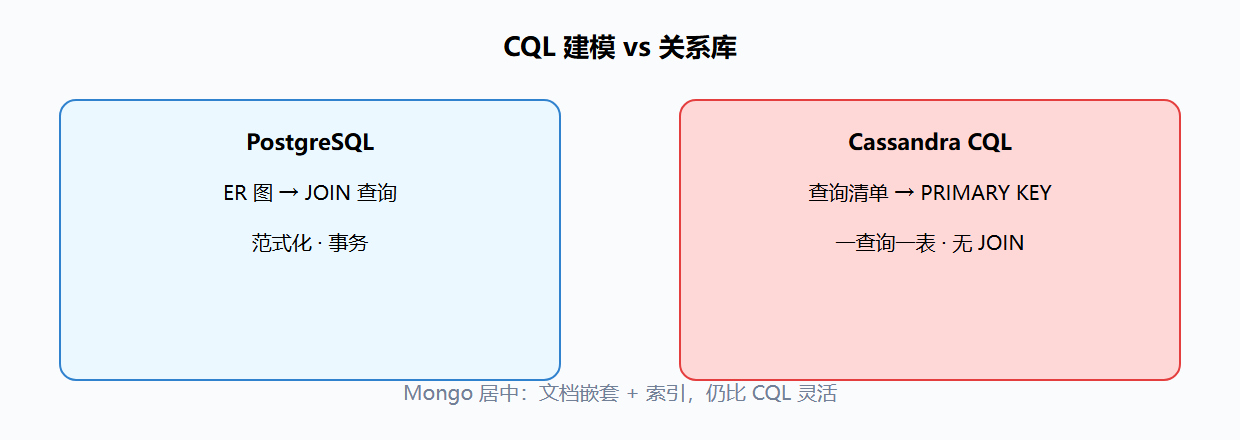
PRIMARY KEY决定 co-location,禁止无分区键扫描。建模顺序是「先列查询,再建表」——与 Mongo 灵活 schema、PostgreSQL 范式化相反。本章覆盖键空间、CQL DDL/DML、反模式。
学习目标
阅读完本章,你应当能够:
- 编写带 NTS 的
CREATE KEYSPACE与表级PRIMARY KEY - 区分 partition key 与 clustering key 的查询能力
- 识别 ALLOW FILTERING、大 partition、双表反模式
- 对照 Mongo 嵌入文档与 HBase RowKey 设计
核心概念速览
在 Cassandra 里,
CREATE TABLE是拓扑声明,不是逻辑 ER 图。
子章节导航
3.1 CQL 基础语法
Keyspace、表、类型、TTL;与 SQL 的差异。
3.2 主键设计与分布
Murmur3、复合键、盐、热点诊断。
3.3 查询驱动建模
一查询一表、时间序列表、与 Mongo/HBase 建模对照。
子章节之间的逻辑关系
CQL 语法约束 → 主键决定物理分布 → 查询驱动决定表数量
前置知识与后续延伸
- 前置:第2章 Token Ring 与 LSM
- 延伸:第4章 schema 变更成本;第5章 批写与二级索引性能
建模决策速查表
| 决策点 | 判断标准 | 错误后果 |
|---|---|---|
| Partition Key | 查询的等值条件、写入热点分散 | 热点分区、单节点瓶颈 |
| Clustering Key | 分区内排序与范围查询 | 排序错位、范围查询失效 |
| 单表 vs 多表 | 查询是否完全独立 | 跨分区扫描(ALLOW FILTERING) |
| 加盐 / 时间桶 | 是否存在超高基数热点 key | 写热点、分区膨胀 |
| TTL vs 显式 DELETE | 数据是否有自然过期语义 | 墓碑堆积、读放大 |
| 物化视图 vs 双表 | 写放大预算与一致性要求 | 写放大 ×2 或状态漂移 |
-- 一个"查询即建表"的最小示例:先列查询,再写 schema CREATE TABLE user_profile ( user_id uuid PRIMARY KEY, -- 按用户等值查 display_name text, created_at timestamp ); CREATE TABLE timeline_by_user ( user_id uuid, event_id timeuuid, body text, PRIMARY KEY (user_id, event_id) -- 分区内按时间排序 ) WITH CLUSTERING ORDER BY (event_id DESC);
常见疑问答疑
CQL 为什么没有 JOIN? 因为 JOIN 需要在运行时跨节点合并数据,代价是网络跳数与延迟不可控。Cassandra 的答案是「在建模期完成组合」:把需要一起查的数据放进同一分区,或建第二张表。MongoDB 的 $lookup 同样被官方建议谨慎使用,HBase 的 JOIN 只能走 MapReduce 离线。
PRIMARY KEY 里括号代表什么? PRIMARY KEY ((a, b), c) 中 (a, b) 是复合分区键,c 是聚类键。分区键共同决定数据落在哪个节点,聚类键只在分区内排序。这是 CQL 最容易混淆、也最致命的语法差异。
为什么不建议 ALTER TABLE 加列? 分布式环境下 schema 变更需要广播到所有副本,宽表加列虽支持但会让既有 SSTable 与新 schema 不一致,且无默认值回填。设计阶段应尽量把列一次定全,后期频繁加列是建模未完成的信号。
ALLOW FILTERING 到底能不能用? 能在「分区键已知但无聚类条件」的小范围过滤上用(如一次只扫少数分区);不能在「无分区键的全表过滤」上用。上线前应把每条带 ALLOW FILTERING 的语句单列评审。
术语速查
| 术语 | 一句话定义 | 章节 |
|---|---|---|
| Keyspace | 复制策略与表集合的容器 | 3.1 |
| Partition Key | 决定数据物理落点的键 | 3.2 |
| Clustering Key | 分区内排序的键 | 3.2 |
| TTL | 行/列自动过期时间 | 3.1 |
| LWT | 基于 Paxos 的条件写 | 3.1 |
| SAI | 与 SSTable 共置的二级索引 | 3.1 |
| Materialized View | 自动维护的派生表 | 3.3 |
| ALLOW FILTERING | 显式声明低效过滤的开关 | 3.1 |
进入第4章前的自测
# 用建表 + 查询验证你的建模直觉 cqlsh -e "DESCRIBE TABLE timeline_by_user" # 能回答:这个表支持哪些查询?不支持哪些?为什么?
能答出三问即可继续:其一,为什么建模必须先列查询清单;其二,复合分区键与加盐有什么区别;其三,什么时候应该建第二张表而不是加索引。