3.1 建模基础:实体与关系
3.1 建模基础:实体与关系
本节摘要:实体是元数据图上的节点,关系是边,而"什么值得成为实体"是建模的第一道判断题。本节给出实体的三个判定标准——独立可寻址、独立生命周期、需要被搜索——并用它检验常见资产类型;随后讲解 URN 标识的构造规则与关系建模的两种表达方式。本节是第 3 章的地基,3.2 的 Aspect 设计与 3.3 的自定义建模都建立在这些判定之上。
从一道判断题开始
接入特征平台时团队吵了一架:每个特征该建成一个实体,还是全部塞进"特征组"实体的一个属性里?两种做法都能跑通,但一年后的维护成本天差地别。这类争论没有标准答案,但有可靠的判定方法——一个东西该不该成为实体,看三条:
独立可寻址:人们需要单独提到它、链接它、给它授权。特征显然满足——"把用户画像的特征 vX 授权给风控组"是真实的管理诉求。独立生命周期:它有自己的产生、变更、下线节奏,不随宿主生灭。特征会单独下线,满足。需要被搜索:用户会按它的名字找它。分析师找特征当然要搜,满足。
三条全中,特征就该是实体。反过来检验字段:字段通常不独立寻址(挂在表内管理)、不独立生命周期(随表下线)、搜索时也以表为单位——所以字段不是实体,是表实体的结构 Aspect 里的条目。注意这不是绝对铁律:如果组织里有字段级的授权与分级要求(合规场景常见),字段也有升级为实体的理由。判定标准给的是默认值,业务需求可以推翻它。
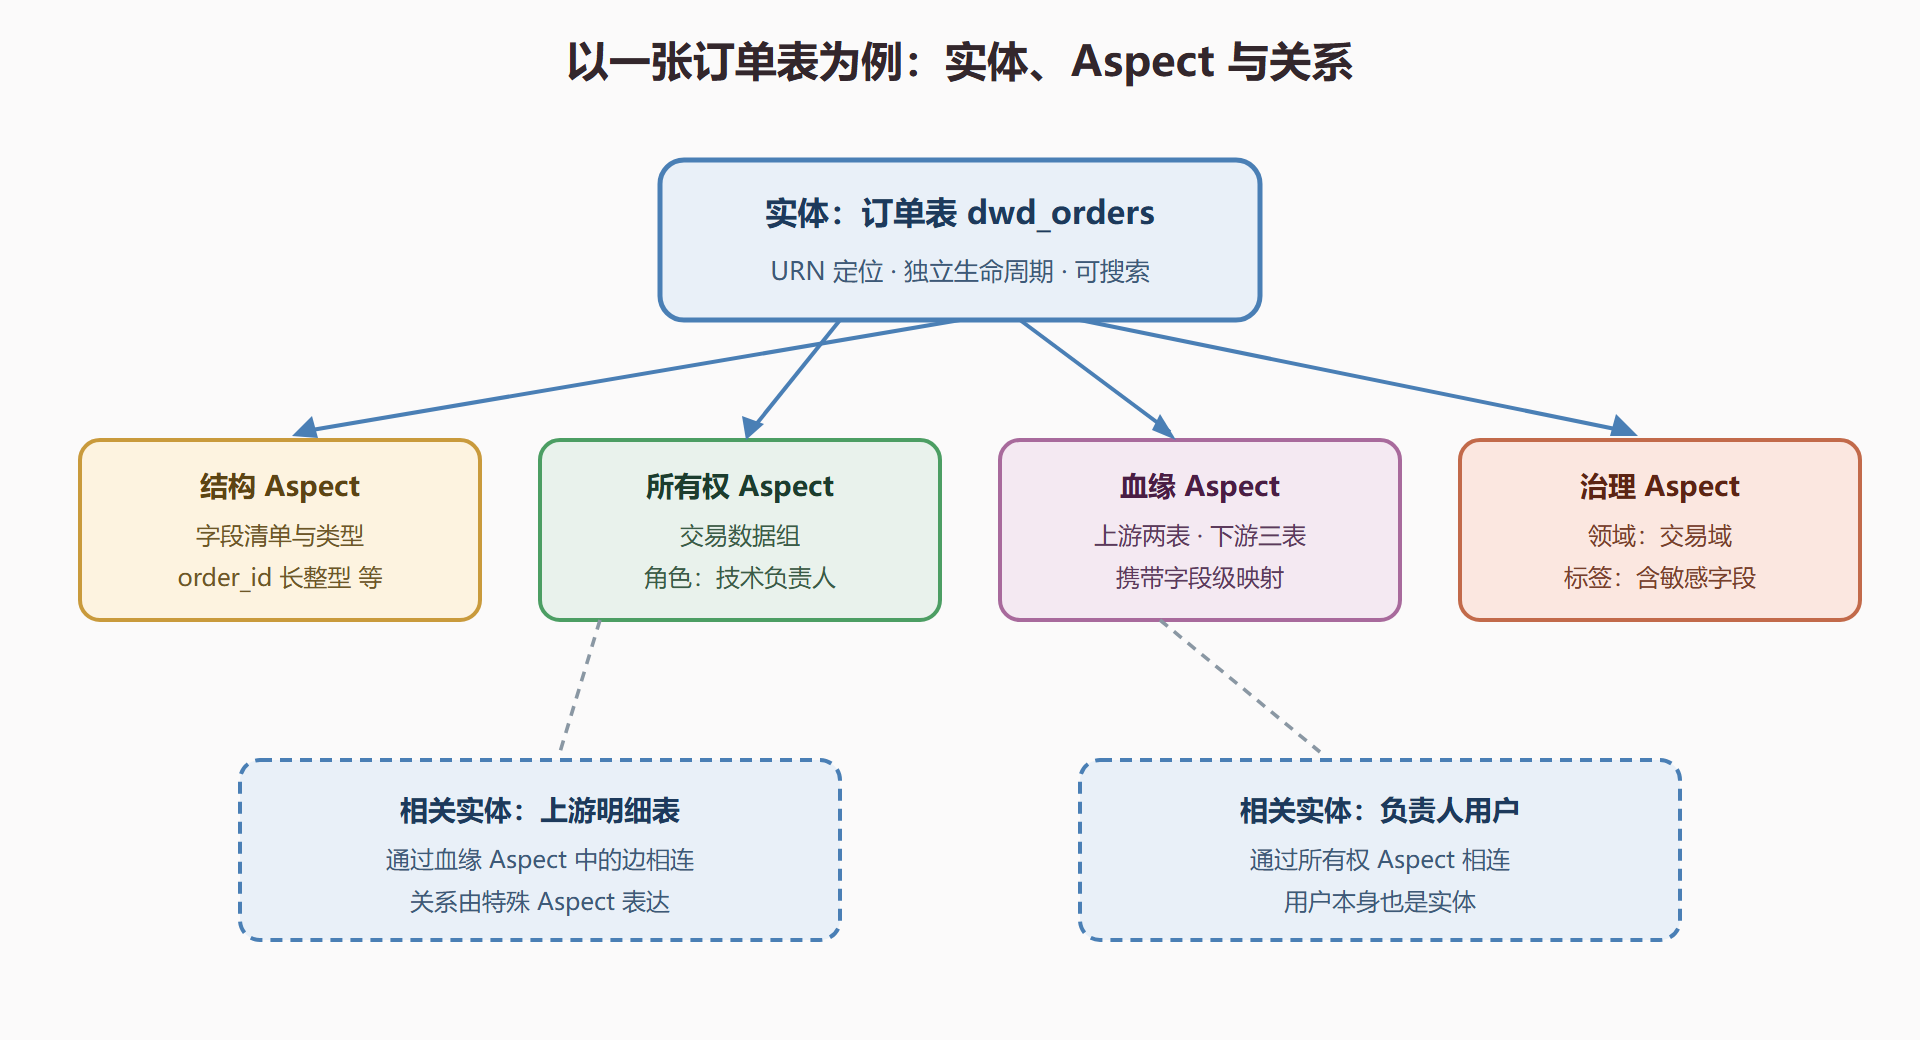
图8 实体、Aspect与关系的结构标注
URN:实体的一等身份证
每个实体由 URN 唯一定位,结构可以拆成三段读:协议前缀声明这是实体标识;平台段说明它来自哪个数据系统(Hive、MySQL、Kafka 之类);名称段是该系统内的坐标(库、表、主题名),最后常带环境标识区分生产与测试。以订单表为例,它的 URN 读出来就是"Hive 平台上、dwd 库、orders 表、生产环境"。
URN 是建模决策里最不容返工的一件事,因为它一旦被大量引用就再难更改。三条经验值得写进团队规范:其一,环境段必须保留,生产与测试同名表是常态,混在一起的代价在第 5 章搜索时就会显现;其二,平台段用受控词表而不是随手字符串,接入新数据系统时先决定它的平台名,防止 mysql、MySQL、MYSQL 三种拼法各成一派;其三,名称段尽量沿用源系统的原生命名,转换与美化留给展示层——原生名是血缘解析对得上的前提。
关系建模:边藏在 Aspect 里
DataHub 有个与其他图系统不同的设计:关系不是独立存储的一等公民,而是以特殊 Aspect 的形式挂在实体上。表的上游清单是血缘 Aspect 的一部分,表的负责人清单是所有权 Aspect 的一部分。写入血缘时,你更新的其实是上游实体的下游血缘 Aspect 与下游实体的上游血缘 Aspect 这一对镜像。
这个设计的妙处在于局部性与完整性:一条血缘的两侧各自持有自己的视角,查询上游时不必遍历全网,读实体自己的 Aspect 即可;同时,镜像机制让"从任何一端看关系"都有一致的数据。代价是写入方要维护两侧一致——自定义血缘写入时只更新一侧,是血缘残缺的经典成因,4.3 节会给出双侧写入的模板。
另一种关系表达是全局关系边,用于那些不属于任何单一实体视角的连接,比如"实体属于某个域"。选择哪种表达,判断依据仍是 3.1 开头的判定法:关系双方是否需要独立寻址、关系本身是否有独立生命周期。拿不准时,优先用 Aspect 表达——它享受统一的模型校验、索引与展示体系,自定义成本也最低。
内置模型速读:以表实体为例
平台的表实体预置了一组 Aspect,读它的划分逻辑是学习建模最好的教材:结构 Aspect 管字段与类型,描述 Aspect 管文档与摘要,所有权 Aspect 管负责人,血缘 Aspect 管上下游,领域与标签 Aspect 管治理归属,统计 Aspect 管使用热度,质量校验结果作为独立 Aspect 由外部工具回写。每个 Aspect 职责单一、可独立更新——改负责人不必重写字段清单,补血缘不必动描述。这个划分逻辑正是 3.2 要展开的 Aspect 设计原则,也回答了一个高频问题:为什么表的一个属性不叫"字段"而叫"Aspect"——因为它们是按更新边界与消费场景切分的,不是按数据结构切分的。
判定法的两个练习
用两条真实资产练一遍判定法,比背三条标准更有效。
练习一:数据产品。 数据中台团队想把"数据产品"(如一张面向经营的宽表服务)接入地图。过三问:独立可寻址——要给产品授权、挂负责人,是;独立生命周期——产品有自己的版本迭代与下线节奏,是;需要被搜索——用户按产品名找它,是。三条全中,建模为实体,而且它通过血缘边与底层表相连,正好把"服务层资产"与"存储层资产"接进同一张图。
练习二:数据的分区。 分区是表的一个属性还是独立实体?独立可寻址——没人单独给某个分区授权,否。独立生命周期——分区随表的结构策略生灭,否。需要被搜索——没人搜"3 月 1 日的分区",否。三条全否,分区只是结构信息,挂在数据集实体的属性里。但你立刻会发现边界情况:如果合规要求"某个特定分区的数据被单独标记冻结",分区就有了独立管理与寻址的诉求——按 3.1 开头说的,业务需求可以推翻默认判定。
两个练习合起来的手感是:判定法回答的是默认值,争议出现时回到"有没有真实的管理动作指向它"这一句。有真实动作(授权、认领、告警、评审)指向的东西值得成为实体;只在展示时出现的细节,留在属性里。
URN 反面教材三则
URN 规则违反的代价是延迟到账的。三个改不出来只能吞下的真实反例,写进规范文档比正面条款更警醒。
反例一:环境段丢失。 某团队接入时觉得环境段多余,URN 里不带环境。半年后测试环境同名表入图,与生产表在搜索结果里并肩而立,分析师拿错表跑错数。此时想给存量实体补环境段,等于全体实体的 URN 重造——所有血缘、标签、所有权引用全部要跟着迁移,成本比重新接入还高。
反例二:平台名随手写。 同一个 Kafka 集群,两个接入者分别注册了平台名 kafka 与 Kafka,图上同一条血缘因为两侧平台名不同而对不上,血缘断在半路。排查这类断边极费眼:两个实体看起来毫无关系,实际只差一个大写字母。
反例三:名称段做了美化。 源系统里的表名带下划线与层级前缀,接入者觉得难看,转成了驼峰。转换单向可达,反向对不上——SQL 解析血缘按源系统原名匹配实体,美化后的名称永远匹配不中,这批表的血缘成了永久性的"哑边"。
三条反例共享同一个教训:URN 是给机器对的坐标,不是给人看的门牌。美观的诉求交给展示层的显示名去做。
本节要点回顾
- 实体判定三问:独立可寻址、独立生命周期、需要被搜索,三条全中才值得建模为实体。
- URN 规范:环境段必留、平台段受控、名称段沿用源系统原生命名,URN 是最不容返工的决策。
- 关系藏在 Aspect:血缘与所有权以 Aspect 表达并两侧镜像,自定义写入必须双侧更新。
- 全局边为辅:跨实体归属类关系用全局边,其余优先 Aspect 表达以享受统一设施。
- 教材方法论:读内置表实体的 Aspect 划分,是掌握建模口径最快的途径。
实体与关系定了坐标系,下一节深入 DataHub 最具特色的建模单元——Aspect:它如何切分属性、键怎么设计、更新语义怎么选。