3.2 Aspect模型设计
3.2 Aspect模型设计
本节摘要:Aspect 是 DataHub 建模的核心机制:属性不直接挂在实体上,而是按"更新边界与消费场景"切成一个个属性包。本节讲清为什么这样设计、Aspect 键的结构与含义、覆盖与合并两种更新语义的选择,以及设计自定义 Aspect 时的键序与版本规则。读完你应能独立为一个实体设计出职责清晰、可局部更新的 Aspect 集合。本节承接 3.1 的实体判定,是 3.3 自定义建模的直接前置。
为什么属性要打包成 Aspect
先看反面:如果把表的所有属性——字段清单、描述、负责人、血缘、统计——拍平成一个大结构,会发生什么?调度系统想补一条血缘,得把整个大结构读出来、改一处、整体写回;数据治理员改描述,与质量平台写校验结果在同一时刻发生,后写的把先写的覆盖。所有写入方在同一条独木桥上互相践踏,并发冲突无法避免。
Aspect 的本质是把并发冲突的粒度从实体级降到属性组级。结构、描述、所有权、血缘各自成包,互不干扰:调度系统只碰血缘包,治理员只碰描述包,谁也不挡谁的道。这就是"Aspect 划分按更新边界来"的由来——一起更新的放一包,分开更新的拆两包。
消费场景是第二个切分依据。搜索视图只收录部分 Aspect 的内容,详情页按区块分别渲染不同 Aspect。切得越符合消费场景,系统的读取路径越顺。两个依据冲突时,优先按更新边界切——写入冲突对平台的伤害远大于读取时多取一包。
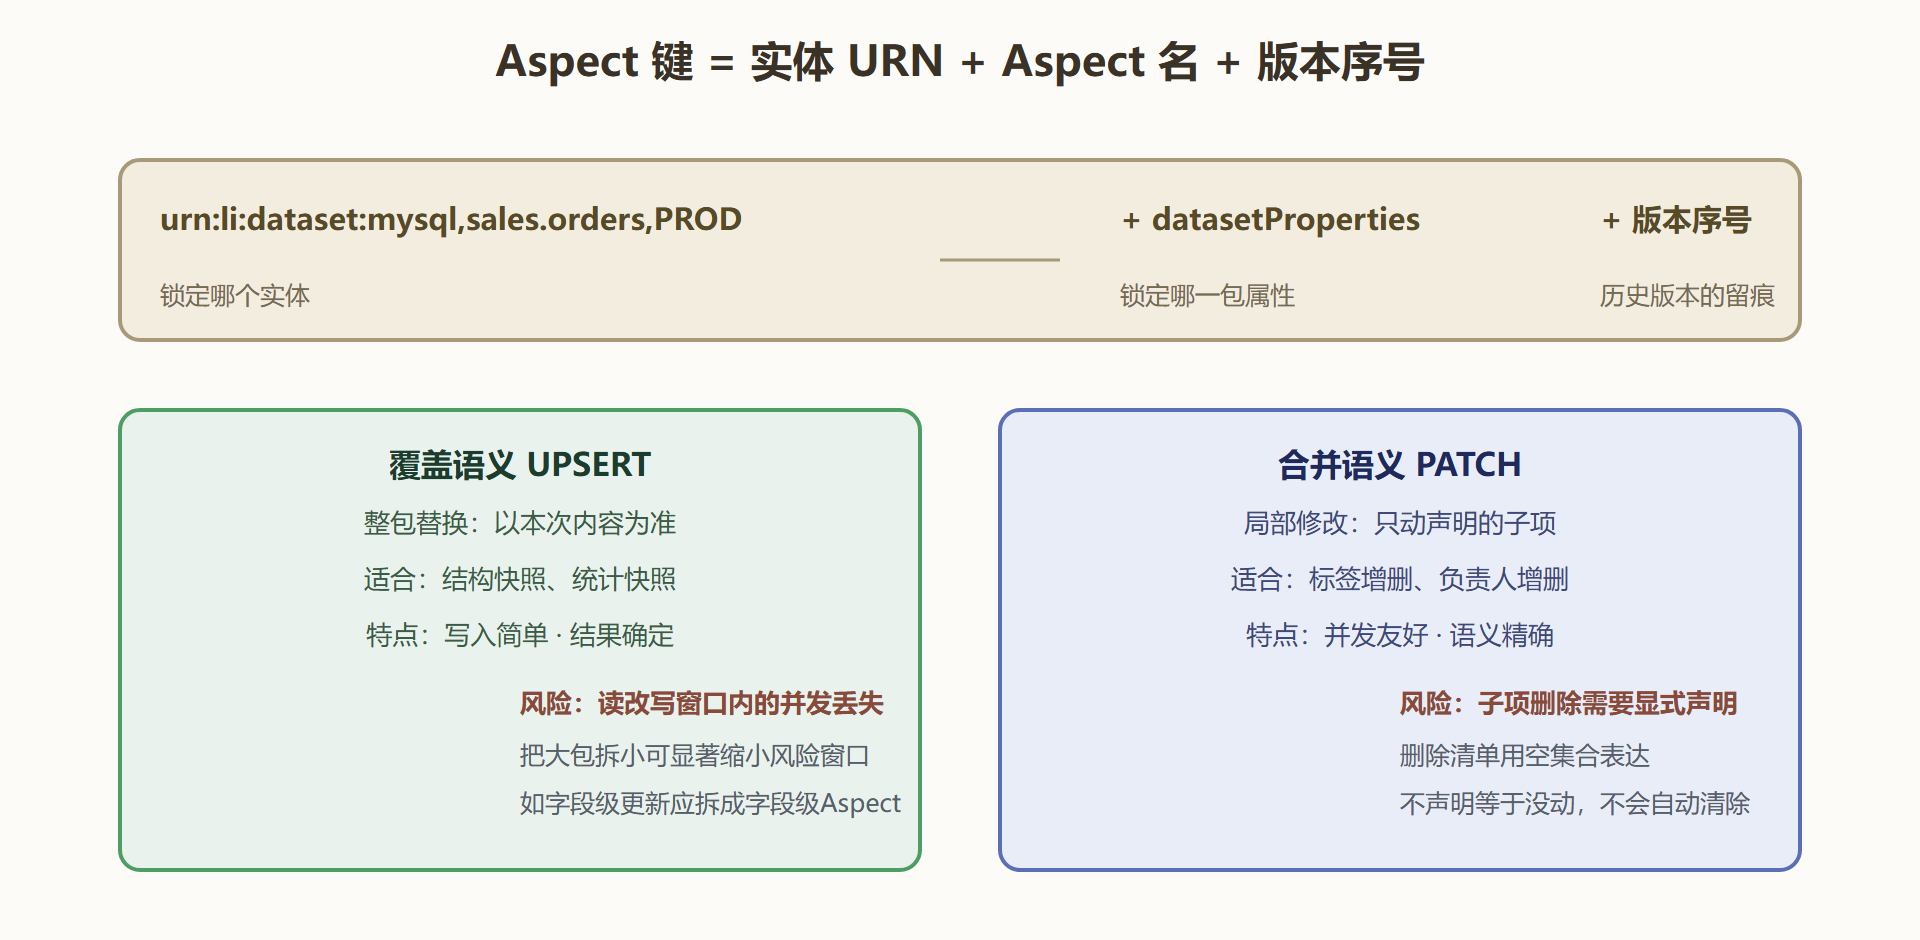
图9 Aspect键结构与更新语义标注
Aspect 键:三段锁定一个属性包
主存储里的每个 Aspect 由键三段锁定:实体 URN 回答"哪个实体",Aspect 名回答"哪一包属性",版本序号回答"第几次变更"。前两段决定写入落在哪,第三段让历史可追溯——平台的版本能力(时间旅行式的"看这表上季度的负责人是谁")就建立在版本序号上。
理解键结构的实际价值在于排错与防错。出现"两个写入方互相覆盖",是它们用同一个键走了覆盖语义;出现"改了不生效",常见原因是写了个错误的新 Aspect 名,平台给挂了个无人消费的新包,而界面上展示的旧包纹丝没动——这类"幽灵 Aspect"问题,把键的三段拆开核对立刻现形。平台对未知 Aspect 名并不总是报错,因为自定义 Aspect 本身就是合法的扩展点,校验只保证类型定义存在,不保证消费方存在。
两种更新语义:覆盖与合并
**覆盖(UPSERT)**是默认语义:提交整包内容,平台以提交内容整包替换。它简单、结果确定、天然幂等,适合内容本来就来自"源系统全量快照"的场景——连接器抓回来的表结构就是典型,快照与源系统对齐,覆盖即真相。
**合并(PATCH)**是局部语义:只声明要增删改的子项,其余保持原样。给表追加一个标签、给实体换一个负责人,用合并语义就不用先读整包再写回,也没有读改写窗口里的并发丢失风险。它的心智成本是删除必须显式声明——把标签集合写成只含一个新标签的清单,合并后是"旧标签都还在、多了一个新标签",不是"只剩这一个"。想让某项消失,要用带删除语义的操作把该项从清单里移除。
选型口诀:**源头给全量快照用覆盖,人手或工具改局部用合并。**违反这个口诀的典型事故是:连接器用了合并语义去同步结构快照,源系统里删掉的字段在平台上永生——因为它从没被显式声明删除。
一次覆盖事故的完整复盘
把口诀换成故事,记忆更牢。某平台的字段描述曾经批量"消失"过一晚。白天,数据治理团队刚组织完一轮描述补全,几百张表的描述写得清清楚楚;凌晨,数仓的结构快照摄入照常运行,把源系统里空空如也的注释同步了上来——覆盖语义生效,平台上的描述被源系统的空值整包替换。早上九点,治理团队的群里炸了。
用本节的概念复盘,事故的每一环都有名字。语义选错:结构快照走覆盖没有错,错在描述这一"慢变量"与结构这"快变量"住在同一个包里,跟着一起被覆盖——正是本节警告的冷热不分。修复:平台立即调整了摄入映射,把人工维护的描述与源系统同步的注释拆成两个独立的 Aspect,互不覆盖;历史描述从版本链里找了回来——3.2 开头强调的版本序号在这里救了场,没有版本化,删掉就是删掉了。
预防写成了两条配置纪律:其一,摄入映射评审时逐个 Aspect 问一遍"这个包里有没有与源系统无关的人工维护内容",有就拆;其二,凡涉及覆盖语义的摄入任务,变更窗口避开人工运营高峰(本例的凌晨摄入撞上白天的运营成果,时间差让发现晚了十个小时)。事故不可怕,同一类事故发生两次才可怕。
版本链的两个实用细节
守则四提到"为历史留版本",补两个用得上的细节。版本链的读取方式:历史查询按 Aspect 键的三段定位,列出该包的全部版本及各自的写入时间与写入方——审计问"这个字段分级是谁在什么时候改的",答案就在版本元数据里,不需要额外的操作日志系统。存储代价的量级:版本以增量方式留存,只有变更的 Aspect 产生新版本,元数据场景的变更频率天然很低,版本链的存储开销通常不到主库的零头。为省这点空间关闭版本化,是用极小的成本节省换掉审计与复盘的全部可能性,这笔账怎么算都不划算。
一个配套的团队约定值得推广:重要的人工变更在提交时附一行变更理由(平台的变更提交支持备注的版本里)。半年后翻版本链,"从 0.8 调成 0.6"旁边有一行"季度合规复查收紧脱敏范围",与没有这行字的版本相比,可读性天差地别。
设计自定义 Aspect 的四条守则
为业务扩展建模时,下面四条守则能避开绝大多数返工。
**守则一:先问能否不建。**平台内置 Aspect 已覆盖大多数需求,扩展属性优先考虑塞进自定义属性键值对;只有当它需要类型约束、独立更新、独立权限或要参与索引时,才升级为正式 Aspect。
**守则二:一包一事。**新建 Aspect 的内容必须共享同一个更新频率与同一批写入方。"信息杂项包"是设计失控的起点——三个月后没人说得清里面哪些字段还有人在维护。
**守则三:键序与嵌套保持稳定。**Aspect 内部的结构变更要走模型演进流程(下一节详述),运行期用未注册的新字段结构写入,轻则字段被静默丢弃,重则读取方解析失败。
**守则四:为历史留版本。**默认版本化开启即可,别为了省存储关掉它。元数据的价值很大一部分在"何时变的、从什么变成什么",审计与故障复盘都靠版本链。
⚠️ 最昂贵的建模错误是把高频变更的内容(如每日统计值)设计进低频更新的包里。统计值会拖着整个包高频率覆盖写,把描述这类慢变量也卷进覆盖风险。拆开,让快的快、慢的慢。
两个语义没有绝对优劣,只有场景适配。团队内出现“该用哪种”的争论时,回到源头问一句:这次写入的内容来自全量快照还是局部判断?答案几乎总是自己跳出来的。
本节要点回顾
- 切分依据:一起更新的放一包、分开更新的拆两包;消费场景为辅,更新边界优先。
- 键三段:实体 URN、Aspect 名、版本序号;版本链支撑历史追溯,键写错会产生无人消费的幽灵 Aspect。
- 语义口诀:源系统全量快照用覆盖,人工与工具改局部用合并;合并下删除必须显式。
- 四条守则:能不建就不建、一包一事、结构稳定、保留版本。
- 冷热分离:高频变更内容单独成包,避免拖累慢变量卷入覆盖风险。
机制清楚了,下一节进入实操:写一个 PDL 文件、注册一个新模型,并学会安全地演进它。