3.3 用PDL自定义模型与Schema演进
3.3 用PDL自定义模型与Schema演进
本节摘要:本节走通模型自定义的完整闭环:以"把指标资产接入元数据平台"为任务,用 PDL 定义指标实体与信息 Aspect,构建注册并让其可被搜索;然后给出 Schema 演进的兼容性判级——哪些改动可以直接上、哪些必须迁移——以及一条团队可执行的演进规范。读完你应能为任意一类业务资产建立合规模型并管理它的生命周期。本节是第 3 章的落地点,也为第 4 章自定义连接器的数据装入提供模型容器。
任务:让指标进入数据地图
数仓的表已经入图,但组织的指标定义还躺在文档里:"月活用户"有三个版本的定义,谁也说不服谁。目标很明确:指标要成为元数据图上的一等公民——可搜索、有负责人、能关联到产出它的表。按 3.1 的判定三问过一遍:指标独立可寻址(授权与认领都是真实诉求)、独立生命周期(指标会单独下线)、需要被搜索(分析师按名字找指标),三条全中,值得建为实体。
实体之外还要一个信息 Aspect 承载指标的业务属性:口径描述、统计周期、维度约束、刷新频率。按 3.2 守则一先问能否不建:这些字段有类型约束与独立更新需求,自定义属性键值对撑不住,正式 Aspect 是对的。
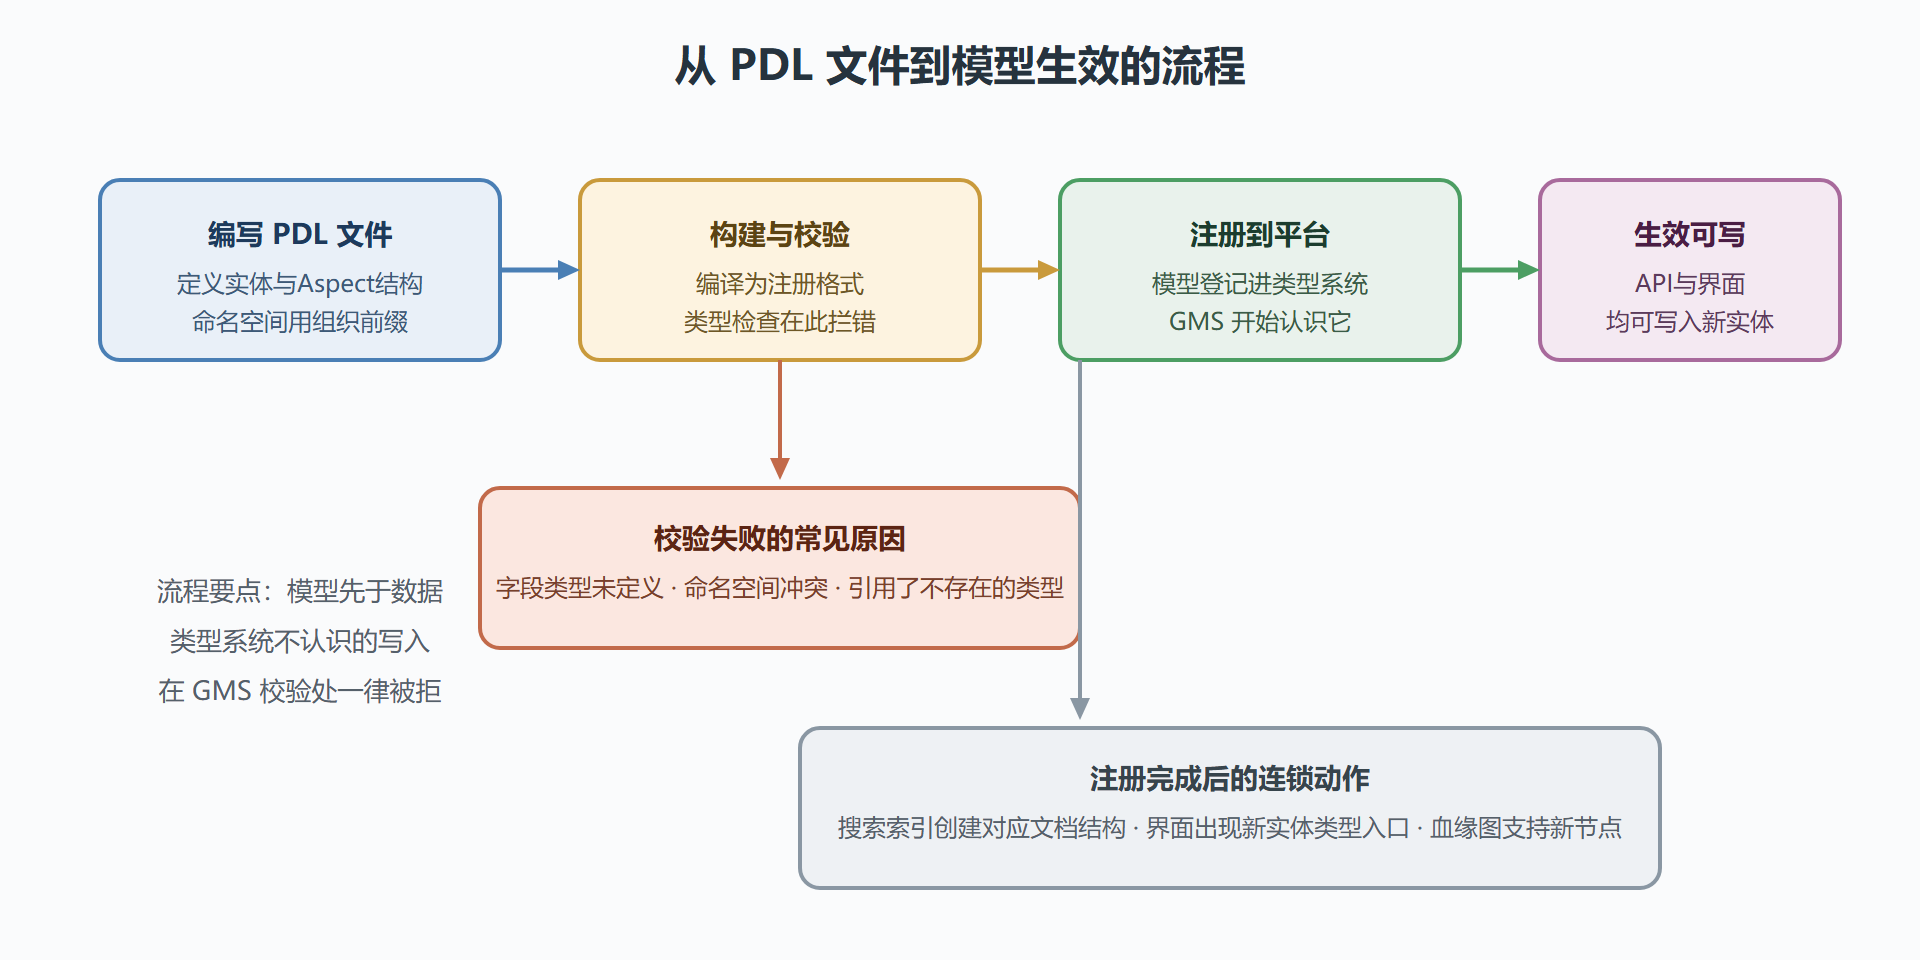
图10 模型定义到生效的注册流程
写第一个 PDL 文件
PDL 是 DataHub 的建模语言,风格接近类型化的记录定义:一个 Aspect 就是一个带字段的记录,字段有类型、可声明可选与默认值。指标信息 Aspect 的定义骨架如下(简化示意,保留主干结构):
{ "type": "record", "name": "MetricInfo", "namespace": "com.company.metric", "doc": "指标的业务信息", "fields": [ { "name": "description", "type": ["null", "string"], "default": null, "doc": "口径描述:统计对象、计算规则、排除条件" }, { "name": "granularity", "type": "string", "doc": "统计周期:日、周、月" }, { "name": "refreshSchedule", "type": "string", "doc": "刷新频率:如每日凌晨批任务" }, { "name": "dimensions", "type": { "type": "array", "items": "string" }, "default": [], "doc": "可用维度清单" } ] }
几处写法都有讲究。命名空间用组织前缀,避免与社区模型撞名;description、granularity 这类人写的字段声明为可空带默认值——这是为将来演进留的余地,下一小节会看到它如何救你;数组字段给空集合默认值,合并语义下它才能正确表达"无维度"。字段文档不是装饰,它们会出现在界面上,是未来使用者的第一手说明书。
实体类型的声明同样是一个 PDL 单元:声明实体名与它的 URN 键结构,再把 MetricInfo 等一组 Aspect 挂到实体上。写完的模型文件进入构建流程编译校验,通过后注册进平台的类型系统。注册成功的第一验证法:向 GMS 查询该实体类型,能返回模型定义即算就位。
Schema 演进的兼容性判级
模型注册不是终点。业务会变:要加"指标负责人角色"字段、要把 granularity 拆成粒度与时区两个概念。每一处改动都要先过一遍兼容性判级。
绿色改动,可直接上:新增可选字段(有默认值,旧数据照常读)、给枚举追加新值、放宽字段文档。这类改动对旧读取方透明,注册后即刻生效。
黄色改动,需评估:给可选字段追加约束、修改字段文档中的语义约定。技术上不破坏,但语义变化会影响消费方理解,应同步通知下游使用方。
红色改动,必须迁移:删除字段、修改字段名、修改字段类型、把可选改成必填。这些会让旧数据无法按新模型读取。处理办法不是硬改,而是加新字段、迁移数据、再淘汰旧字段的三步走:注册包含新字段的版本,写迁移脚本把旧字段值填充到新字段,确认全部实体迁移完成后,在下一个大版本移除旧字段。
一个真实教训供参考:某团队图省事直接把统计周期的字段类型从字符串改成枚举,注册是成功了,但存量指标里"月 "(带空格)这类脏值不在枚举范围内,读取方批量解析失败。类型收紧属于红色改动——枚举化之前先清洗数据,顺序不能反。
给团队定一条演进规范
判级规则要变成规范才能防事故。建议四条写进团队文档:其一,模型文件进版本库,改动走评审,评审时必须标注判级颜色;其二,红色改动必须附迁移方案与数据迁移脚本,方案未过评审不得注册;其三,所有新字段一律可选带默认值上线,观察一个周期后再考虑收紧约束;其四,注册动作安排在低峰期,注册前在测试环境用生产快照数据演练一遍读取。四条都不重,缺了任何一条,代价都会以线上事故的形式补齐。
💡 模型文件当作代码对待,是这一节所有实践的心法:版本库、评审、测试环境演练、灰度上线——数据领域的"模型即代码"比大多数工程实践更值得,因为模型错误的爆炸半径是全部存量数据。
注册完成后的验证清单
模型注册成功只是"平台认识它了",离"可以放心往里写数据"还差一轮验证。四步验证走完再让业务方接入。
读回验证:向 GMS 查询新实体类型的模型定义,核对字段名、类型、默认值与 PDL 文件一致——注册的是编译产物,源文件与注册物不一致的事故虽然少见,但发生时排查方向全错。写入冒烟:手工创建一个测试实体,填齐每个字段后提交,再读回比对——枚举值、数组、可空字段是三类最容易在序列化环节出偏差的位置。索引确认:搜索新实体类型的测试实体,确认它能被搜到且展示字段正确——搜索视图的字段映射是独立配置,模型注册不会自动保证展示符合预期。权限预演:用普通用户身份访问新实体类型,确认默认权限组的行为符合设计——新模型默认对所有人可读还是默认收窄,要在业务方涌入之前想清楚。
四步各自只需要几分钟,合计不超过半小时。跳过它们的代价通常在业务方接入的第一周集中爆发:字段显示不对、搜不到、权限告警一拥而上,而此时数据已经进来了,返工对象从"模型文件"升级成"存量数据"。验证通过后,把 PDL 文件、注册记录与验证结论一起归档进版本库——这份档案是下一个实体类型建模时的模板,也是模型争议时的最终依据。
PDL 文件本身也是最好的学习材料:平台内置模型的源定义与你的自定义文件结构完全相同,读不懂平台的某项行为时,翻内置模型的字段定义往往比查外部文档更快、更准。
最后一个提醒:三色判级的执行者是人不是工具,评审时的那一句“这是什么颜色的改动”值得写进评审模板的首行。
本节要点回顾
- 先判定后建模:实体判定三问通过才建实体;字段有类型约束与独立更新需求才建正式 Aspect。
- PDL 要点:组织前缀命名空间、人写字段可选带默认值、数组给空集合、字段文档认真写。
- 判级三色:加可选字段是绿色可直接上;语义变化是黄色需通知;删改字段与类型收紧是红色必须迁移。
- 迁移三步走:加新字段、迁数据、淘汰旧字段;数据清洗先于类型收紧。
- 演进规范:版本库加评审、红色附迁移方案、新字段先松后紧、注册前演练。
模型的坐标系建好了,下一章开始真正的外业:把各类数据系统的元数据接入平台,让地图上的地标一点点亮起来。