5.1 数据发现与搜索
5.1 数据发现与搜索
本节摘要:搜索是数据地图的使用入口,也是决定平台口碑的第一道闸门。本节讲清搜索结果的排序构成——匹配度、使用热度、治理状态各占什么权重——以及类型、平台、环境、标签四类过滤的组合技巧,并用三个真实检索场景演示从模糊需求到精准定位的完整路径。本节承接第 4 章的接入产出,是第 5 章价值链的第一环:找得到,才谈得上信得过与敢动手。
排序不是玄学
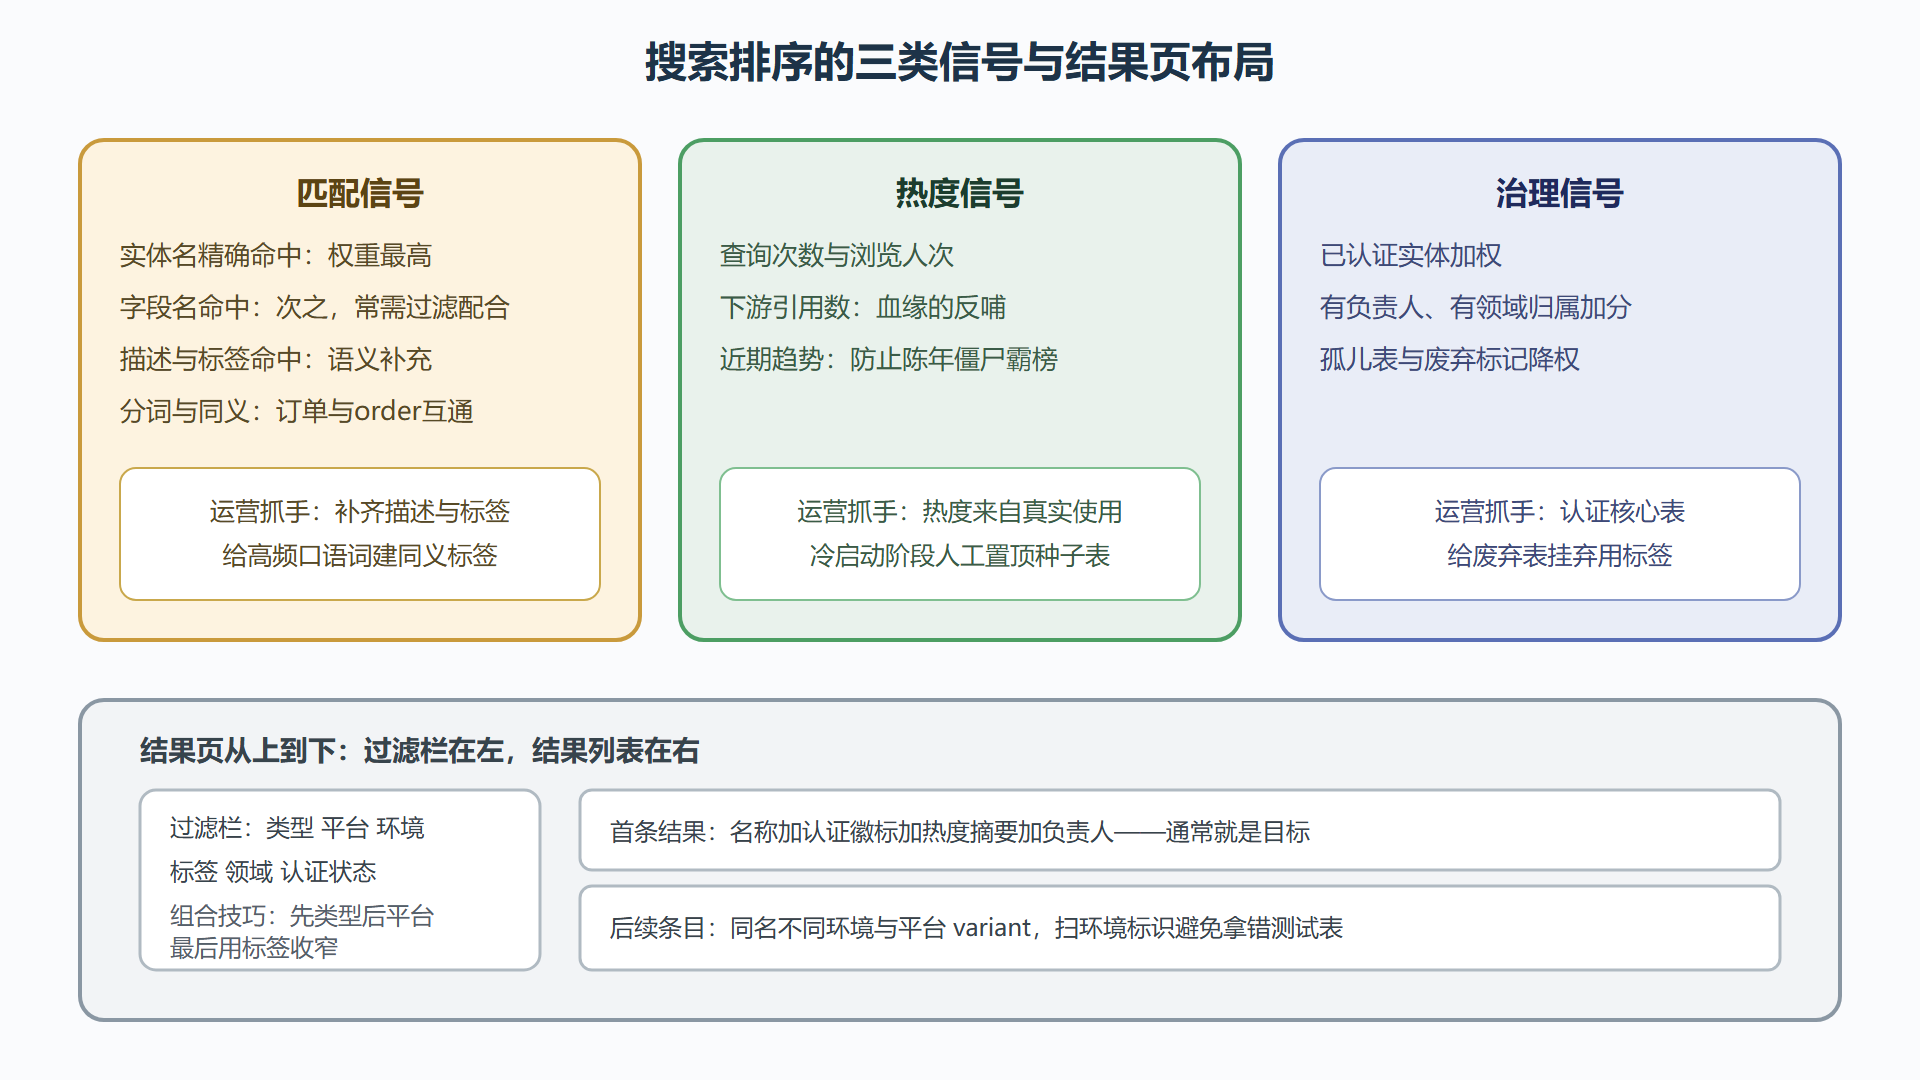
先破除一个迷思:搜"订单"出来的第一条不是平台在偏心,是排序因子在说话。结果的相关性由三类信号合成。匹配信号:关键词命中实体名、字段名、描述、标签的部位与权重不同——表名精确命中最高,描述里出现居中,标签命中是加分项。热度信号:实体的查询次数、下游引用数、浏览人次构成使用热度,一张被几十个看板引用的表天然该排前面。治理信号:已认证、有负责人、有领域归属的实体获得加权,孤儿表被降权。
理解排序构成有两个直接用处。对使用者:结果第一页往往就是"该用的那张",但仍要养成扫一眼治理标识的习惯——热度高只说明用得多,不说明它有主、没错。对运营者:排序因子是可以影响的地基,把热门表的描述与标签补齐、推动核心表完成认证,搜索质量会肉眼可见地提升——这正是 5.5 推广案例的起手式。
图14 搜索结果的相关性构成与页面布局
过滤组合的正确姿势
过滤栏里的每一项都是收窄器,但顺序有讲究:先粗后细,先排他后优选。第一步用类型排他——找指标就先把实体类型切成指标,结果列表瞬间干净;第二步用平台与环境排他——排除测试环境、排除不相关引擎,同名异源表是误用的重灾区;第三步才用标签优选——"含敏感字段""已认证"这类正向筛选放最后,因为标签覆盖是逐步完善的,放前面会误伤尚未打标的正确结果。
环境过滤值得单独警告一次。生产与测试同名表在搜索结果里比邻而居,分析师拿错环境表跑数的事故在导入期高发。团队约定一条铁律并写进新人手册:取数前必看环境标识,生产取数必须经环境过滤确认。
三个检索场景实战
**场景一,模糊需求起步。**业务方说"想找用户流失相关的数据"。直接搜"用户流失"可能颗粒度不对——它可能是一张表、一个指标、一个看板或一份术语。正确路径:先搜术语表,看"用户流失"的官方定义与挂接的实体清单;顺着术语跳到指标实体,再看指标的血缘落到哪几张表。这个路径绕但稳,避免拿错口径。
场景二,按字段找表。"哪些表里有手机号字段"是合规与开发的高频问题。直接在搜索框敲字段名,匹配信号会把字段命中的表排上来,但更可靠的做法是配合类型过滤加标签过滤:类型收窄到数据集,标签选"含敏感字段"(前提是 5.3 的打标已铺开)。两种打法的结果差异恰好暴露了打标覆盖率——这也是打标推广的最好论据。
**场景三,搜不到的时候。**排除三件事再下结论:环境过滤器是否把它筛掉了(5.4 排错实录的同名症状)、实体是否确实没接入(回到第 4 章补接入)、名称是否用了源系统的别名(换成口语词或同义词再试)。搜不到的工单按这个顺序处理,多数在三分钟内关闭。
搜索体验的运营清单
搜索质量一半靠排序引擎,一半靠内容运营。给运营者一份清单:核心域表完成认证与负责人认领;高频口语词建立同义标签("GMV"与"成交总额"挂同一术语);废弃表挂弃用标签让它们从结果里降权;每月查看零结果搜索词榜单——每一个零结果词都是内容缺口,补描述、补标签或补接入,搜索体验就有了持续改进的闭环。
⚠️ 不要用"把所有表名堆进描述"的方式讨好搜索。堆砌会污染匹配信号,让真正命中的实体被稀释,效果适得其反——描述写给下一个读它的人,不是写给索引器。
检索语法的几个进阶动作
基础的关键词搜索覆盖八成需求,剩下两成靠这几个进阶动作。
限定字段检索:支持按字段名前缀匹配的检索语法(如只搜 schema 里的字段名),找"哪个表有 device_id 字段"时比全文关键词准得多——全文会把描述里碰巧提到 device 的表也拉进来。标签语法:用标签标记直接筛出一类实体(如带"含个人信息"标签的清单),合规同事的例行检查可以从半天缩到五分钟,前提是 5.3 的打标已经铺开。域名限定:搜索时限定在某个业务域内,跨域同名表的干扰立刻消失——这也是 5.3 建议尽早完成领域归属的又一个理由。精确短语:给关键词加引号做整词匹配,搜英文缩写与专有名词时能避免分词器的自作聪明。
还有一个很少被写在手册里的习惯:把好用的检索路径存下来。平台的收藏夹或书签功能(支持的版本里)可以保存过滤条件组合,把"核心域加生产环境加已认证"这类高频组合固化成一键入口,分发给团队——检索技巧的复用,和代码复用一样产生复利。
给平台运营者的搜索看板
如果你是运营者,每周值得看三组数字。零结果词榜单:每个词都是一个内容缺口,按周分配修复责任人。点击分布:搜索后用户点了第几条?首条点击占比下降,说明排序质量或内容质量在恶化。高频词与实体名的差距:用户搜的词与平台里的实体名对不上(搜"退款"而实体叫 refund_order),这个差距清单就是同义标签的工作计划。
三组数字都不需要额外开发,平台的搜索分析能力或日志就能出。它们把"搜索体验"从一句口号变成三个可执行的待办清单。
一次取数申请的完整走查
把搜索技巧放进真实工作流里检验。分析师小李收到需求:"上季度各渠道的退款金额,用于渠道复盘。"用本节的方法,他的动作链是这样的:先搜术语——"退款金额"在术语表里有正式词条,定义明确写着"含取消单、按退款成功时间统计",附带挂接的指标实体;点进指标实体,血缘显示它由明细层两张表加工;看指标详情,认证徽标在、负责人在、质量区块显示绿色(最近一轮完整性校验通过);最后确认环境过滤在生产档位,复制连接附进取数申请。全程四分钟,没有问任何人。
对照一下没有这套习惯的走法:群里问"退款金额哪张表",等十分钟,收到三四个不同答案,挑一个跑数,跑完发现口径与需求方想的不一样——含不含取消单,需求方自己也说不清,返工开始。
两条路径的分水岭不在搜索技巧本身,而在从口径出发而不是从表名出发。术语先行、指标中转、质量把关、环境确认——四步习惯养成后,"找数"就从碰运气变成了走流程。把这条走查写进新人培训材料,比任何操作手册都直观。
搜索能力的天花板还有一个隐性约束:元数据本身的语言质量。描述写得含混、标签打得随意,再好的排序也难为无米之炊。这正是本章先讲搜索、后讲治理的用意——5.3 的打标与描述补全,本质是在给 5.1 的搜索引擎供弹。
把搜索练成本能的最后一招:每周给自己出一道“三步找数题”,从随机需求出发练到三步内命中,四周后速度会有质变。
本节要点回顾
- 排序三信号:匹配看命中部位、热度看真实使用、治理看认证与归属;三者皆可运营。
- 过滤口诀:先类型排他、再平台环境排除、最后标签优选;取数前必看环境标识。
- 术语先行:口径类问题从术语表进入,顺定义找实体,避免拿错版本的定义。
- 搜不到三查:环境过滤、接入缺失、命名别名,按序排查多数三分钟解决。
- 零结果榜单:每月复盘零结果搜索词,它是内容缺口与接入缺口的自动探测器。
找到了数据,下一步是看懂它的来龙去脉。下一节进入血缘:读图、做影响分析、把变更决策建立在证据上。