5.2 端到端血缘与影响分析
5.2 端到端血缘与影响分析
本节摘要:血缘是数据地图上最锋利的一层:它把"改了会影响谁"从经验猜测变成证据查询。本节讲血缘图的正确读法——纵向是采集层次、横向是上下游展开——然后给出一次完整影响分析的五步操作,并用三个典型范式(变更管控、故障溯源、下线评估)展示血缘的业务落点。本节承接 5.1 的发现能力,是第 4 章接入成果的兑现环节,也是 4.5 项目复盘里"发布卡点"的能力底座。
血缘图的三层读法
拿到一张血缘图,从三个维度读它。纵向读层次:图上的边来自不同采集渠道——调度系统给的任务级血缘、SQL 解析给的字段级血缘、报表工具给的展示层依赖。层次决定了置信度与粒度:任务级血缘说明"这两个表之间存在加工关系",字段级血缘进一步说明"哪一列流向哪一列"。读图时先确认图的层次,字段级缺失时不硬猜列级影响。横向读方向:上游回答"这数从哪来、源头变了它受不受影响",下游回答"它变了谁会炸"。纵深读距离:一跳邻居是直接依赖,多跳展开是完整传导链,展开深度要与决策粒度匹配——评估一个字段调整,通常两到三跳足以覆盖真实风险面。
图15 端到端血缘分层标注图
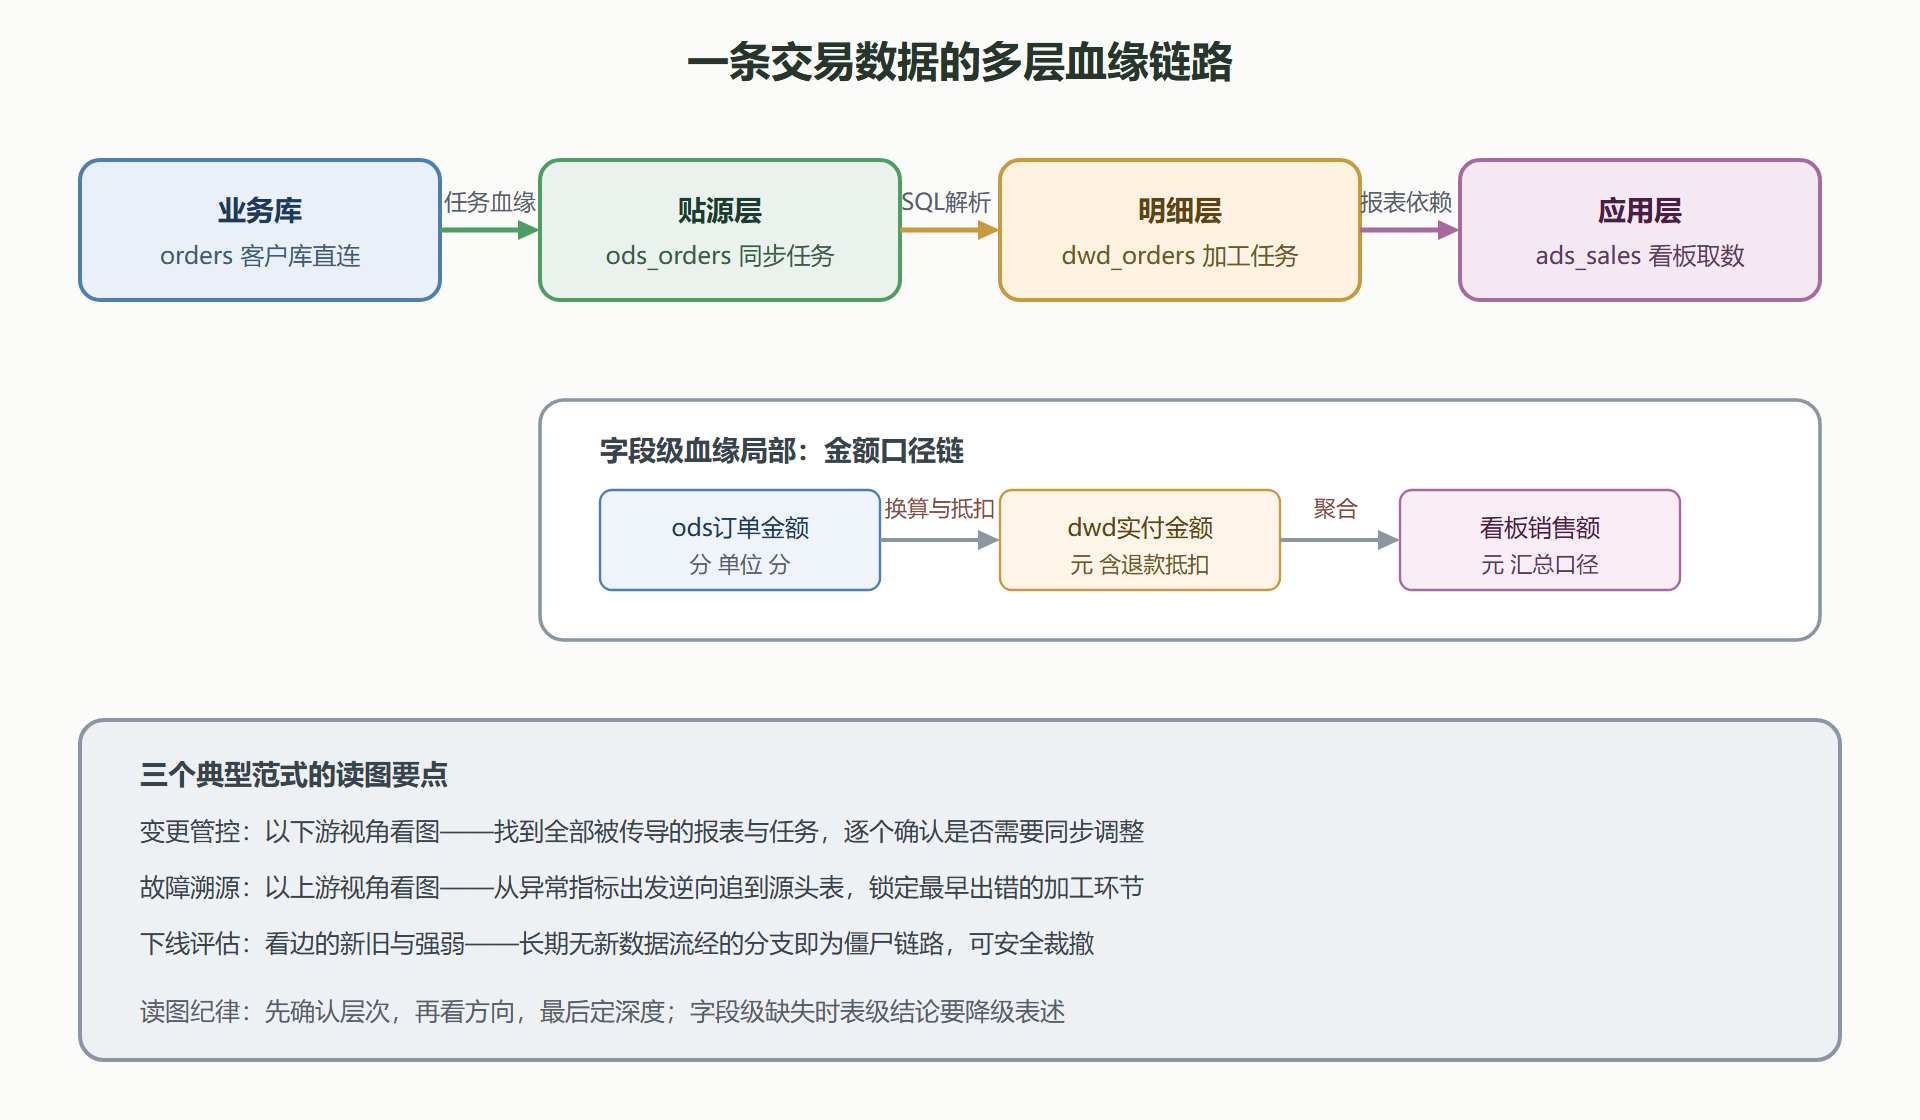
影响分析五步操作
以一次真实的字段调整为例:明细层的"实付金额"要从含抵扣改为不含抵扣。完整的影响分析五步走:
第一步定锚点:搜索定位到该字段,确认环境与平台无误——锚点拿错,后面全错。第二步看下游:展开字段级血缘的下游视图,记录直接消费方:本例为两张汇总表、一个看板指标。第三步追传导:从直接消费方继续展开二跳,汇总表下游还有三张应用表与两个看板。到此传导链闭合:一个字段变动,五步之内牵动两个层级。第四步分级:把消费方按重要性分档——服务经营决策的核心看板必须同步改口径;边缘的探索性报表登记知悉即可。第五步留证:把影响清单导出附进变更单,评审人在变更单上看到的是证据链而非口头保证。
这套流程在 4.5 的项目里被固化成了发布卡点:第五步的留证由流程强制完成。影响分析的价值兑现形态,不是画图好看,而是变更单上有据可查。
三个范式的展开
**范式一:变更管控(事前)。**上面五步就是完整示范,此处补一个经验值:传导链上出现"看板"节点时风险等级自动上调——报表炸了用户先于工程师发现,事故的观感与实际损失不成比例。管控的产出物是"影响清单加处置措施",措施通常是同步修改、限期迁移或明确接受。
**范式二:故障溯源(事后)。**指标异动的排查从血缘图反向走:从异常的看板指标出发,沿上游逆向检查各加工环节的数据更新时间与体量曲线。血缘图把"问一圈谁改过数"的社交式排查,压缩成"沿图找第一个更新时间异常的节点"的机械式排查。一次数据事故的平均定位时长,是血缘投资回报最直观的度量。
**范式三:下线评估(瘦身)。**数仓瘦身时,血缘回答"这张表能不能删":上游仍被引用的不能动,无下游引用的是候选。但要警惕血缘的时效性——低频任务(月末批、季度批)的边可能长期"看起来不动",删表前把低频调度也纳入观察窗口,或直接与任务负责人确认。下线评估是血缘图最容易立竿见影的应用:僵尸表清一轮,存储与计算成本立刻可见地下降。
⚠️ 血缘图有一个必须向使用者声明的边界:它反映的是"元数据采集到的事实",不是"此刻物理世界的实况"。接入滞后、解析失败、钩子断流都会让图落后于现实,影响分析的重大决策要以源头系统的交叉验证兜底。
两个标注让血缘图更可信
血缘图上所有边看起来一模一样,但它们的可信度并不相同。给边补两个维度的心智标注,图就从"看起来全"升级为"知道哪里可能不全"。
置信度标注:字段级解析出的边最可信(SQL 摆在那里);任务级钩子推的边次之(任务确实跑了,但表级映射可能掩盖细节);报表工具报的依赖再次之(工具自己也是猜的)。重大变更评审时,对低置信度的边做一次源头确认,五分钟换一个安心。新鲜度标注:每条边背后都有最近一次确认时间——解析器上次成功解析这个任务是什么时候、钩子最近一次推送是什么时候。边的新鲜度在界面上未必直接可见,但影响分析的结论里应该写:本次影响面基于最近一次血缘同步时间。这两句标注写进变更单模板,评审质量立上一个台阶。
一个反面案例:被漏掉的那条边
最后讲一个教训形态的案例。某团队做字段类型调整前跑了影响分析,血缘显示下游两个表一个看板,全部确认完毕,变更上线。三天后,一个使用方投诉数据对不上——原来下游还有一条链路:一个由临时脚本(不在调度系统里)每天手动运行的导出任务在消费那个字段。它没接调度系统、没有钩子推送,血缘图上根本没有这条边。
案例的教训有两层。流程层面:影响分析的字段要加一项"线下链路排查"——问一圈"还有谁在用这张表",把脚本党、Excel 党这些元数据盲区的使用方找出来确认。平台层面:这次事故后来推动了该组织把散装脚本收编进调度系统——血缘的完整性上限,就是组织数据作业的收编率。血缘图不会漏掉收编进系统的作业,收编不进来的,谁也保不住。
让影响分析接口化的三个场景
五步操作是人肉流程,成熟团队会把它接口化,让机器走在人前面。三个典型场景。
发布前的自动闸门。 调度系统在任务发布流程里调用血缘接口:以变更涉及的表为锚点拉下游清单,命中核心域下游就要求发布者填写影响评估,未填则拦下发布。4.5 复盘里的发布卡点,技术实现就是这一个接口调用——它把影响分析的纪律从"记得做"变成"逃不掉"。
变更订阅通知。 数据产品的消费方在平台订阅自己依赖的实体,上游有变更提案时自动收到通知,附影响路径。相比"出事了查血缘"的事后模式,订阅把消费方拉进了变更的环路,多数影响在发生前就被消化掉了。
变更单机器人。 研发协作平台里挂一个机器人:变更单提到表名,机器人自动回贴该表的影响面摘要与负责人名单。接入成本一个脚本级别,收益是让"影响分析"出现在工程师本来就在的地方——工具追着人走,永远好过人记着找工具。
三个场景共享同一个底座:血缘接口返回的结构化影响清单。把五步操作里"看下游、追传导"两步固化成接口调用,剩下的人肉部分(分级处置与知悉确认)才是真正需要判断力的环节。
末尾给血缘能力画一条成长曲线:初期的表级血缘解决“有没有”,中期的字段级血缘解决“准不准”,成熟期的接口化订阅解决“用不用”。多数组织卡在第二级,不是技术不够,是作业收编率与治理没跟上。评估自己组织在哪一级,用本节的三层读法抽查十个真实场景即可。
影响分析的功夫在图外:结论要落进变更单,责任要落到签字处——血缘提供证据,流程赋予证据效力。
本节要点回顾
- 三层读法:先层次(任务级还是字段级)、再方向(上游溯源下游管控)、后深度(两三跳匹配决策粒度)。
- 五步操作:定锚点、看下游、追传导、分级处置、留证入单;留证是价值兑现的关键一步。
- 风险加权:传导链上出现看板即升级处置,报表事故的用户感知远快于内部告警。
- 三范式:事前管控出清单、事后溯源缩时长、下线评估降成本,各答一类决策。
- 边界声明:血缘是采集事实不是实时实况,重大变更需源头交叉验证。
变更有了依据,接下来是给数据本身建立秩序。下一节讲治理三件套——标签、术语表、所有权——怎么以最小成本落进平台。