2.1 编译与执行引擎:从 Jinja 到 DAG
2.1 编译与执行引擎:从 Jinja 到 DAG
本节摘要:dbt 的一切能力都始于编译:它在真正连数据库之前,就把你写的模板 SQL 渲染成纯 SQL,同时收集出完整的依赖关系图。本节用一段具体的模型代码走完整个编译过程,拆出「编译期三件事」——渲染、引用替换、依赖收集,再讲执行期如何按拓扑排序分批并行。理解了这条流水线,后面遇到「模型没跑」「引用报错」「执行顺序不对」时,你都能自己定位到是哪一环出了问题。
从一段模板 SQL 说起
先看一段最典型的模型代码。这是一张「订单明细」模型的全部内容:
-- 一张贴源清洗模型:从原始订单表选出有效字段 with source as ( select * from {{ source('raw', 'raw_orders') }} ), renamed as ( select id as order_id, user_id as customer_id, status as order_status, created_at as ordered_at, amount as order_amount from source where status not in ('test', 'deleted') ) select * from renamed
这段 SQL 里有一样东西不是标准 SQL:{{ source('raw', 'raw_orders') }}。它是 Jinja 模板语法的一个函数调用,意思是「引用原始数据区里名叫 raw_orders 的那张源表」。人读得懂,但数据库读不懂——直接把这段文本发给数据库,只有两种下场:报语法错,或者更糟,被当成普通字符串处理。在它到达数据库之前,必须有人把花括号里的部分翻译掉。这个「人」就是 dbt 的编译器。
编译期三件事
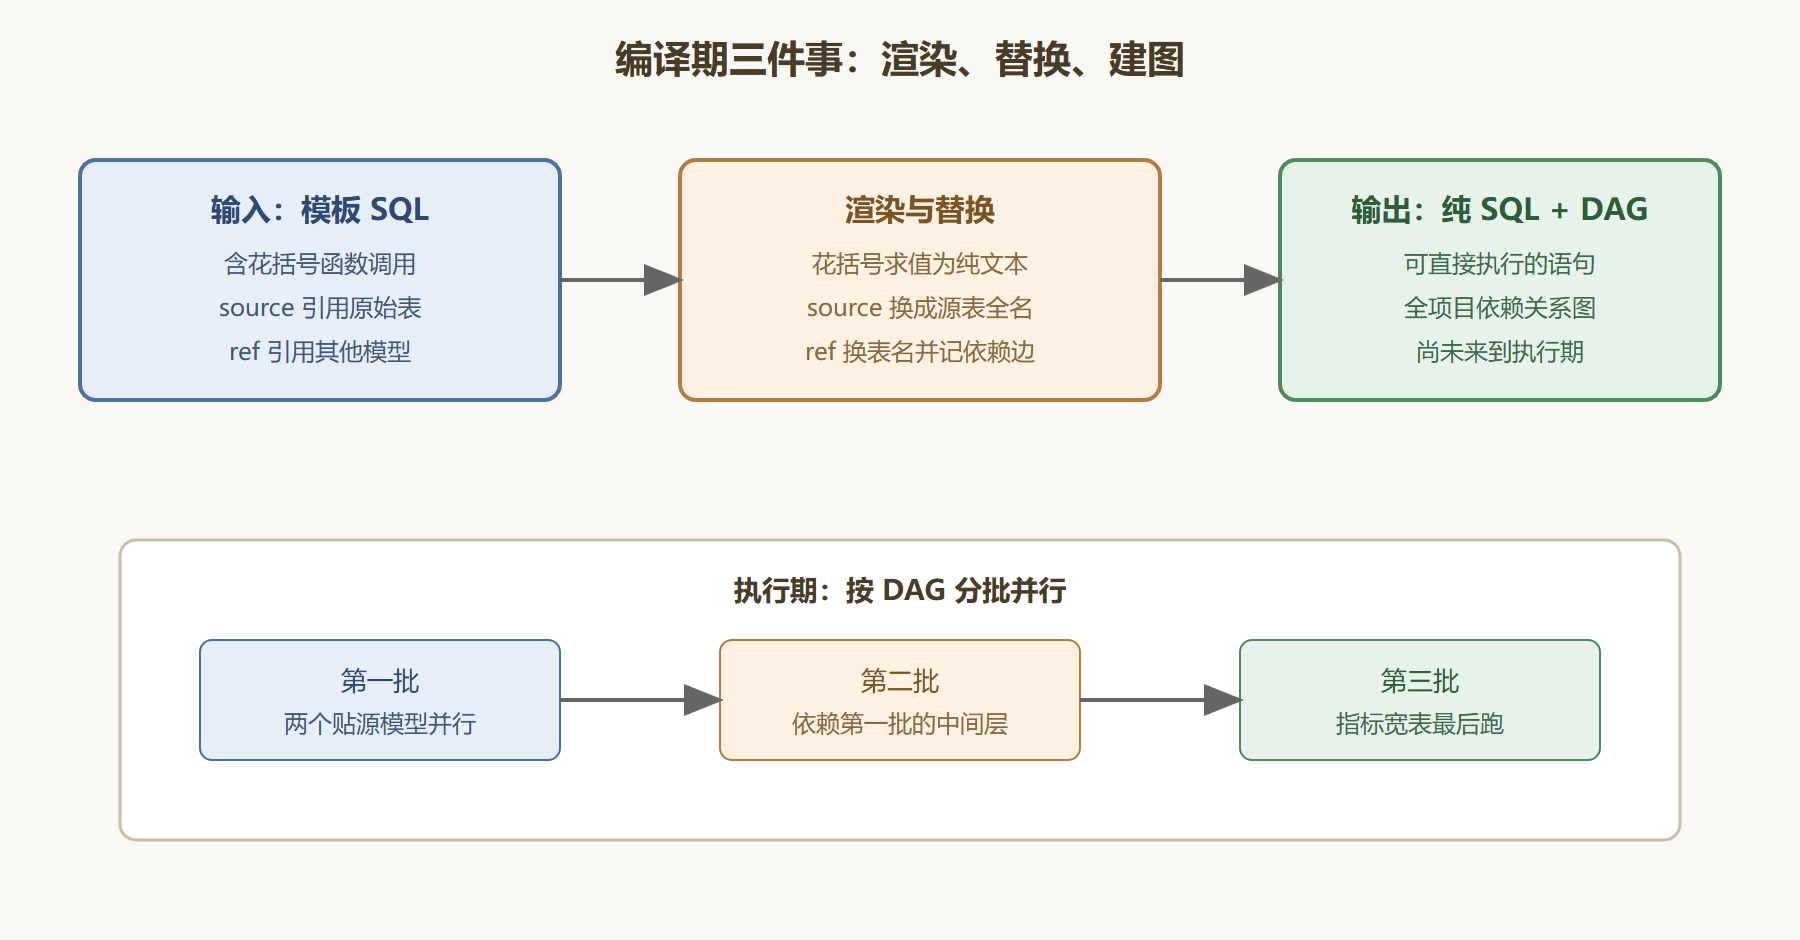
第一件:渲染模板。 dbt 用 Jinja 模板引擎逐文件处理模型代码。模板语法在渲染后要么产生文本(比如函数调用被替换成表名),要么控制文本(比如条件判断决定哪些 SQL 片段保留)。渲染完成后,得到的是一份纯 SQL 文本——数据库认识的、可以直接执行的那种。
第二件:替换引用。 模板里最重要的两类函数调用,渲染规则是 dbt 核心语义所在:
{{ source('raw', 'raw_orders') }}被替换成源表在目标环境里的全名(数据库与模式前缀加表名)。source 声明的是「别人喂给我的原始表」,它不带依赖边——原始表的到货不由 dbt 管;{{ ref('stg_orders') }}被替换成另一个模型的目标表名,同时在这两个模型之间记下一条依赖边:当前模型依赖 stg_orders。
注意这两者的差别:source 是「引用数据」,ref 是「引用模型 + 登记依赖」。整个 dbt 的依赖管理能力,起点就是 ref 在渲染时顺手做的那次登记。
第三件:收集依赖、构建 DAG。 所有模型编译完,dbt 把依赖边汇总成一张有向无环图。每个模型是图上的一个节点,每条 ref 是一条从上游指向下游的边。这张图在编译期就完整成形,执行还没开始,顺序已经定了。
图:一段模板 SQL 的编译流水线
动手验证:把编译结果看个明白
dbt 允许只编译不执行,这是理解编译器最直接的办法。写好模型后,运行编译命令,产物是每个模型对应的纯 SQL 文本。拿前面那张订单模型举例,编译产物里的引用部分会变成这样:
-- 编译产物(节选):花括号已消失,只剩纯 SQL with source as ( select * from "warehouse"."raw"."raw_orders" ), renamed as ( select id as order_id, user_id as customer_id, status as order_status, created_at as ordered_at, amount as order_amount from source where status not in ('test', 'deleted') ) select * from renamed
对照输入与输出,三件事都看得见:花括号没了(渲染)、source 换成了带库和模式前缀的全名(替换)、这份产物对应的依赖关系已经进了依赖图(建图,虽然文本上看不见,但运行构建命令时它决定顺序)。遇到「编译出来的 SQL 和我想的不一样」的问题,看编译产物永远比猜快。
执行期:拓扑排序与同层并行
编译产物就绪后,执行引擎按依赖图分批:所有没有上游依赖(或上游已跑完)的模型构成第一批,并行执行;第一批全部成功后,依赖它们的模型构成第二批,以此类推。这个算法叫拓扑排序,它有一个隐含承诺——只要构建成功,任何模型的下游一定在它之后跑,上游一定在它之前跑。 你不需要(也不应该)在调度系统里手写「先跑 A 再跑 B」,顺序是算出来的。
一个三层的典型项目在执行时的样子:第一批是几张贴源清洗模型(并行);第二批是依赖它们的中间拼装模型(并行);第三批是面向报表的指标宽表(并行)。批次之间的等待是刚性的——没得商量,上游没跑完就轮不到你;批次内部是自由的——没有互相依赖的模型同时开跑。
引用函数的两个进阶用法
掌握了 ref 与 source 的基本语义后,两个进阶用法很快会进入你的视野,提前认识能少走弯路。
跨项目引用。当公司有多个 dbt 项目(比如一个基础项目管客户主数据,业务项目引用它的产出)时,引用函数可以指向另一个项目的模型——依赖边跨项目生效,基础项目的构建状态会通过元数据传递到业务项目。这是「微服务式」的数据团队分工的基础设施:各团队维护各的项目,公共资产通过跨项目引用共享,呼应 4.2 节内部 Git 包的思路,但粒度更细、耦合更低。
版本与回滚友好的引用。引用函数支持「最后一次成功的构建结果」语义:下游可以声明「引用上游最近一次跑成功的版本」,这样上游某次构建失败时,下游仍基于上一次的干净结果运行,而不是被失败卡死整条链。这个语义适合「上游偶尔抖动、下游时效性要求高」的链条,代价是下游可能用到略旧的数据——用不用,取决于你的业务对「新」和「稳」哪个更敏感,没有标准答案。
这两个用法共同指向一件事:ref 不是「表名替换」这么简单,它是整个依赖管理体系的语法入口,你在依赖图上享受的每一项能力(排序、影响分析、血缘),都源于你在代码里写下的那一次引用。
⚠️ 常见坑:有人为了「控制执行顺序」在调度脚本里把一个项目拆成几段、按段定时跑。这等于亲手把工具算好的顺序拆碎,还会造成上游刚跑一半、下游就开跑的脏读窗口。顺序问题一律回到依赖图上解决:该谁先跑,就让谁被引用。
还有一类高频报错值得提前认识:循环依赖。如果模型 A 引用 B、B 又引用 A,依赖图上出现环,拓扑排序无解,编译期直接拒绝构建。这不是缺陷而是保护——真正互相依赖的模型意味着职责没有切干净,正确做法是把公共部分抽成第三个模型供两者引用。第四章的排错实录会完整走一遍这类案例。
本节要点回顾
- 编译期三件事:渲染模板、替换引用、构建依赖图——全部发生在连数据库之前。
- source 与 ref 的语义分野:source 引用别人喂的原始表、不产生依赖边;ref 引用模型、同时登记依赖边。
- 看编译产物是排错第一动作:编译命令只产出纯 SQL 不执行,输入输出一对照,玄学变常识。
- 拓扑排序的承诺:构建成功即顺序正确;批次间刚性等待,批次内自由并行。
- 循环依赖是编译期错误:互相依赖说明职责未切开,抽公共模型是标准解法。
编译解决了「SQL 从哪来、按什么顺序跑」。接下来的问题是:跑完的结果以什么形态留在仓库里——是每次查询都现算的视图,还是一次成型的大表?这就是下一节物化策略要回答的。