2.2 物化策略体系:五种物化方式的取舍
2.2 物化策略体系:五种物化方式的取舍
本节摘要:物化(materialization)决定一个模型的查询逻辑在仓库里以什么物理形态存在:是每次查询都现算的视图,还是一次写成的实体表,或是只算新增的增量表。形态不同,查询速度、构建成本、数据延迟全都不同。本节逐一拆解五种物化的机理与代价,给出「查询频率、数据量、构建成本、延迟要求」四要素选型法,并用一个真实项目的物化配置表收尾。
五种物化各是什么形态
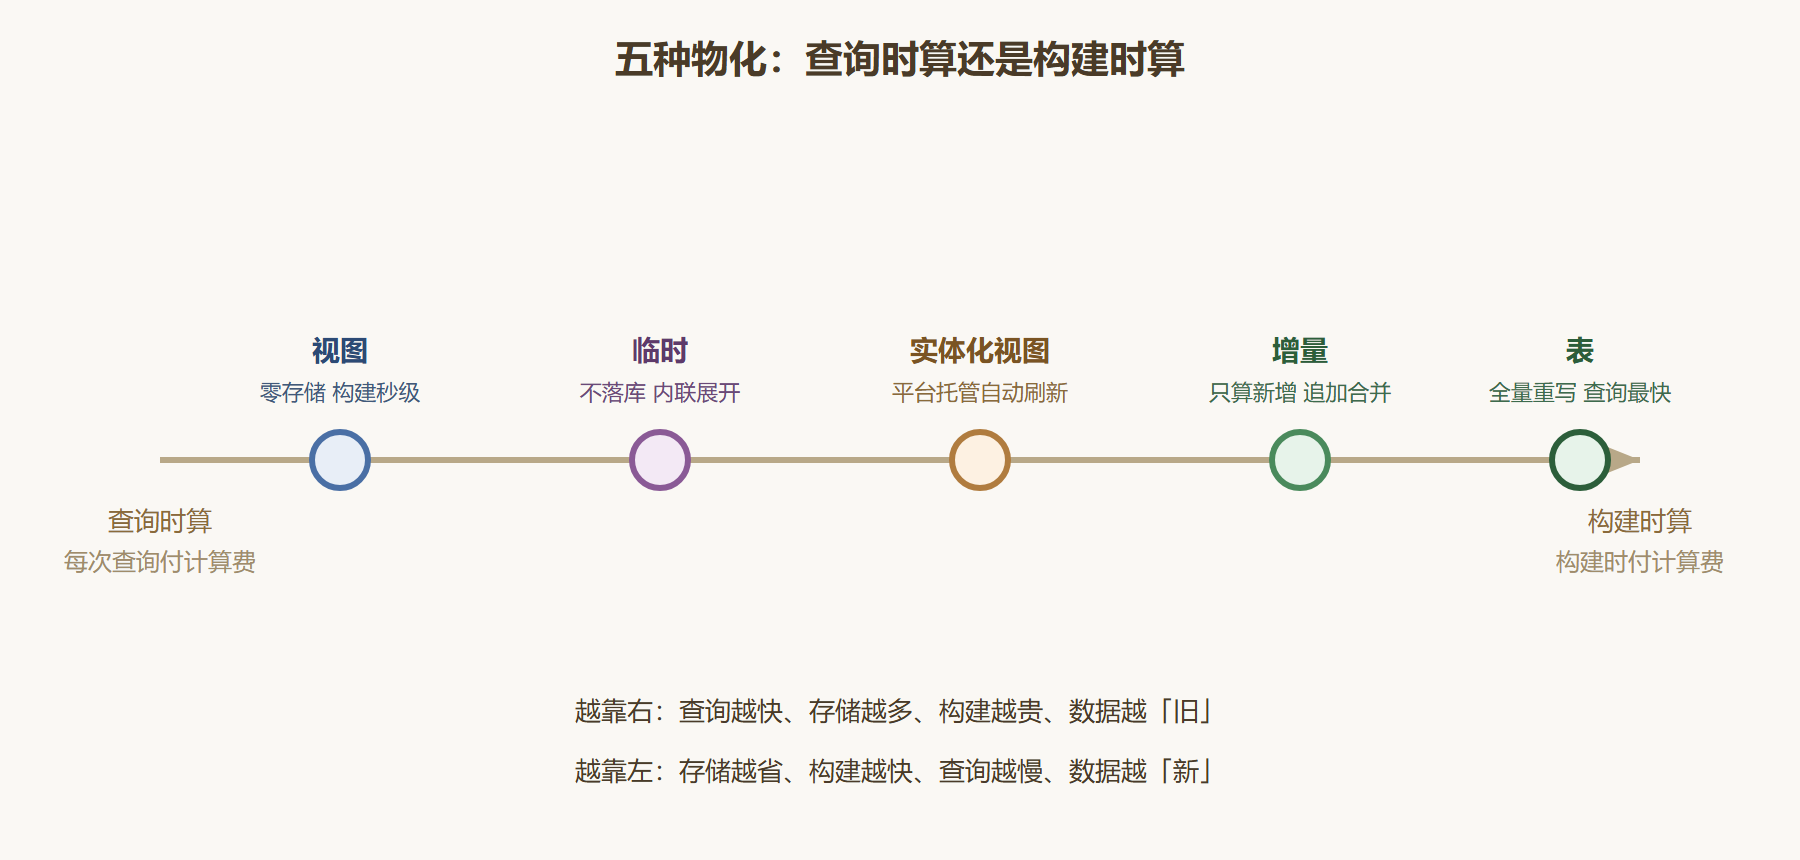
施工时同样的图纸可以选不同的建造方式:现浇、预制、临时设施——材料与工期各不相同。dbt 的物化是同一回事。五种形态,按「查询时算」到「构建时算」的光谱排列:
视图(view)。 构建时只在仓库里存一条查询语句,不存任何数据。每次有人查这个视图,数据库现场执行那条语句。好处是永远最新、零存储、构建秒级完成;代价是每次查询都从底表重算,链路一长(视图引用视图引用视图)查询延迟线性叠加,还会把计算压力转嫁给每一次业务查询。
表(table)。 构建时执行完整查询并把结果整表写入仓库(通常是「建新表、换名字」的替换策略,保证过程中读者不看到半成品)。查询时读现成数据,速度最快、查询成本最低;代价是每次构建都全量重写,数据量大时构建时间和存储成本都高,且数据新鲜度取决于构建频率——两次构建之间,表里是上一批的旧数据。
增量(incremental)。 表的智能版:首次构建全量,之后每次构建只处理新到的数据,追加或合并进已有大表。它把「每天重算十亿行」变成「每天只算昨天新增的一百万行」,是大数据量表的标准解法。代价是配置复杂度高一截(要定义唯一键和增量判定条件),且历史数据处理出错时修补麻烦——2.3 节专门展开。
临时(ephemeral)。 根本不落库。构建时它被「内联」进下游模型的 SQL 里,像一段被展开的公共子查询。适合纯粹的中间清洗逻辑:不想让它变成仓库里的实体对象,又想多处复用。代价是没法直接查询它、调试时看不到中间结果。
实体化视图(materialized view)。 数据库原生的「自动刷新的表」:仓库替你维护物化结果,部分平台还支持查询时自动重写命中。各平台能力差异大,dbt 的这个物化本质上是薄封装。适合「想要表的查询速度、又不想自己管刷新」的场景,但刷新策略受限于平台本身。
一张表看懂五种取舍
| 物化 | 查询速度 | 构建成本 | 数据新鲜度 | 存储占用 | 典型用途 |
|---|---|---|---|---|---|
| 视图 | 慢(现算) | 几乎为零 | 实时 | 一条语句 | 轻量逻辑、小表封装 |
| 表 | 最快 | 高(全量重写) | 取决于调度频率 | 全量 | 高频查询的下游宽表 |
| 增量 | 最快 | 低(只算新增) | 取决于调度频率 | 全量(只增) | 千万行以上的事实表 |
| 临时 | 无(不落库) | 零 | 跟随下游构建 | 零 | 多处复用的清洗逻辑 |
| 实体化视图 | 快 | 中(平台托管) | 平台刷新策略 | 全量 | 想要表又不想管刷新 |
图:五种物化在成本光谱上的位置
四要素选型法
给一个模型定物化,依次过四个问题:
- 谁在查、查多勤? 供报表或应用高频查询的,倾向表或增量;只有少数分析师偶尔看一眼的,视图够用。
- 数据量多大? 百万行以内,全量表的成本无感;千万行以上、还在快速增长的事实表,增量几乎是必选项。
- 构建预算多少? 全量重写一张十亿行大表,在按扫描计费的仓库上每天跑一次就是真金白银;增量把这笔账除以几百。
- 业务能容忍多旧的数据? 天级报表容忍 T 加 1,小时级看板要求每小时构建,对延迟的要求直接决定构建频率,进而影响物化的成本核算。
一个典型电商项目的配置结果可以作参照:贴源清洗层全用视图(逻辑轻、要最新);订单明细这种大事实表用增量(量太大,全量不划算);中间拼装层用视图(被少数下游引用,不值得存两份);面向报表的指标宽表用表(被查询最频繁,查询体验优先);维度的缓慢变化历史用快照(下一节的正题)。
物化的写法有两种层级。项目级默认值写在工程配置里,按目录生效:
# 工程配置片段:按目录设默认物化 models: my_project: staging: +materialized: view # 清洗层默认视图 marts: +materialized: table # 报表层默认表 facts: +materialized: incremental # 其中的大事实表单独设增量
单个模型的特殊需求在该模型文件里覆盖:
-- 模型内覆盖:这一张表虽然住在 marts 目录,但很小且要实时,改用视图 {{ config(materialized='view') }} select ...
配置的生效规则是「就近优先」:模型内的声明覆盖目录默认,目录默认覆盖项目默认。实际项目里推荐目录默认为主、模型内覆盖为例外——例外越少,新人理解整个项目的物化版图越容易。
⚠️ 常见坑:把物化当成纯性能问题来调,会漏掉它最大的隐性代价——下游看到的数据延迟。一张表物化的上游模型,下游构建时读到的是上一次构建的结果;如果上游改用视图,下游每次构建都读最新明细。两种选择没有对错,但口径上的这个细微差别,足以让两张「理论上相等」的表对不上数。改物化形态时,务必核对下游的数字预期。
物化决策的两个常见疑问
模型已经建好了,物化形态还能改吗
能,而且这正是「配置即代码」的红利之一:改一个配置项,下一次构建就按新形态重建。但改之前要把两件事核清楚。一是下游语义——本节开头警告过的数据延迟问题:从视图改成表,下游读到的数据从「每次最新」变成「上一次构建的快照」,如果下游的口径预期建立在实时性上,数字就会对不上。二是首次重建的成本——从视图改成表或增量的第一次构建是全量的,千万行级的大表要在低峰期安排,避免白天把仓库算力打满。
全部用表物化、把构建时间拉长,不就绕开选型了吗
这是新手常有的「一根筋方案」:所有模型都用表,查询永远最快,慢就慢点。它的问题有三层:构建时长随模型数量线性增长,项目过百个模型后单次构建以小时计,迭代节奏被拖垮;存储成本翻数倍(大量中间结果只有一两个下游却整表落库);最关键的是它让「数据新鲜度」退化为「构建完成时刻」——为了查询快牺牲了全部时效弹性。选型的意义正在于承认「不同模型的最优点不同」,一根筋方案等于把最优点拉平到最差。
实体化视图听起来两全其美,为什么不推它
它在「两全」的同时引入了「第三样东西」:平台绑定性。刷新策略、可表达能力、成本行为全由平台决定,各家差异极大;换仓库时(1.2 节的迁移案例)它是迁移清单里最重的一类。经验法则是:除非你恰好命中「平台原生支持良好 + 刷新语义恰好匹配」的场景,否则「自己管表或增量」的可控性更值钱。
本节要点回顾
- 五种物化一条光谱:视图与临时在「查询时算」一端,表在「构建时算」一端,增量与实体化视图在中间各有专长。
- 四要素选型:查询频率、数据量、构建成本、延迟要求,按顺序问一遍,答案自然浮出。
- 配置就近优先:目录默认为主、模型内覆盖为例外,让整个项目的物化版图一眼可读。
- 物化改变数据延迟语义:表物化让下游读到上一批数据,视图物化让下游每次读最新——改形态要连带核对下游口径。
五种物化里,增量的门道最深:判定条件写错一行,轻则数据重复,重则整月数据静默丢失。下一节把增量模型和它的孪生兄弟快照放在一起,用实验把两者的行为差异钉死。