3.1 模型结构与分层规范
3.1 模型结构与分层规范
本节摘要:分层是 dbt 项目的第一张图纸:贴源清洗层负责标准化,中间层负责业务拼装,报表服务层负责面向消费的最终形态。层与层之间的引用方向、每层的职责红线、模型命名的三段式规则,这三样定下来,项目就有了防腐化的骨架。本节给出一套经过多个项目验证的结构方案,并解释每条规范背后的理由——规范如果不讲理由,执行不出两周。
分层为什么是第一张图纸
观察两个同样用 dbt 的团队,一年后的项目状态可能天差地别:一个的项目目录打开像一份井然的施工图,新人半小时能定位任何一张表;另一个的目录像一盘散沙,几十个模型平铺在根目录,谁引用谁全靠搜索。差别通常不在技术水平,而在开工第一周有没有定分层规范。
分层的本质是给模型分类,让「每种处理逻辑」都有固定的去处,从而让依赖方向变得可预测。没有分层时,一段 SQL 既可以清洗、也可以拼装、还可以直接出报表——三件事混在一起,改任何一处都牵动全局。有了分层,清洗逻辑只住在清洗层、被上层引用,业务拼装只住在中间层、不直接触碰原始表,依赖图自然长成自下而上的形状。
三层标准结构
业内经过充分验证的是三层结构,目录大致长这样:
models/ staging/ # 贴源清洗层 ecommerce/ # 按业务域分子目录 stg_orders.sql stg_customers.sql intermediate/ # 中间层 ecommerce/ int_orders_customers.sql int_daily_sales.sql marts/ # 报表服务层 ecommerce/ dim_customers.sql fct_orders.sql sales_summary.sql
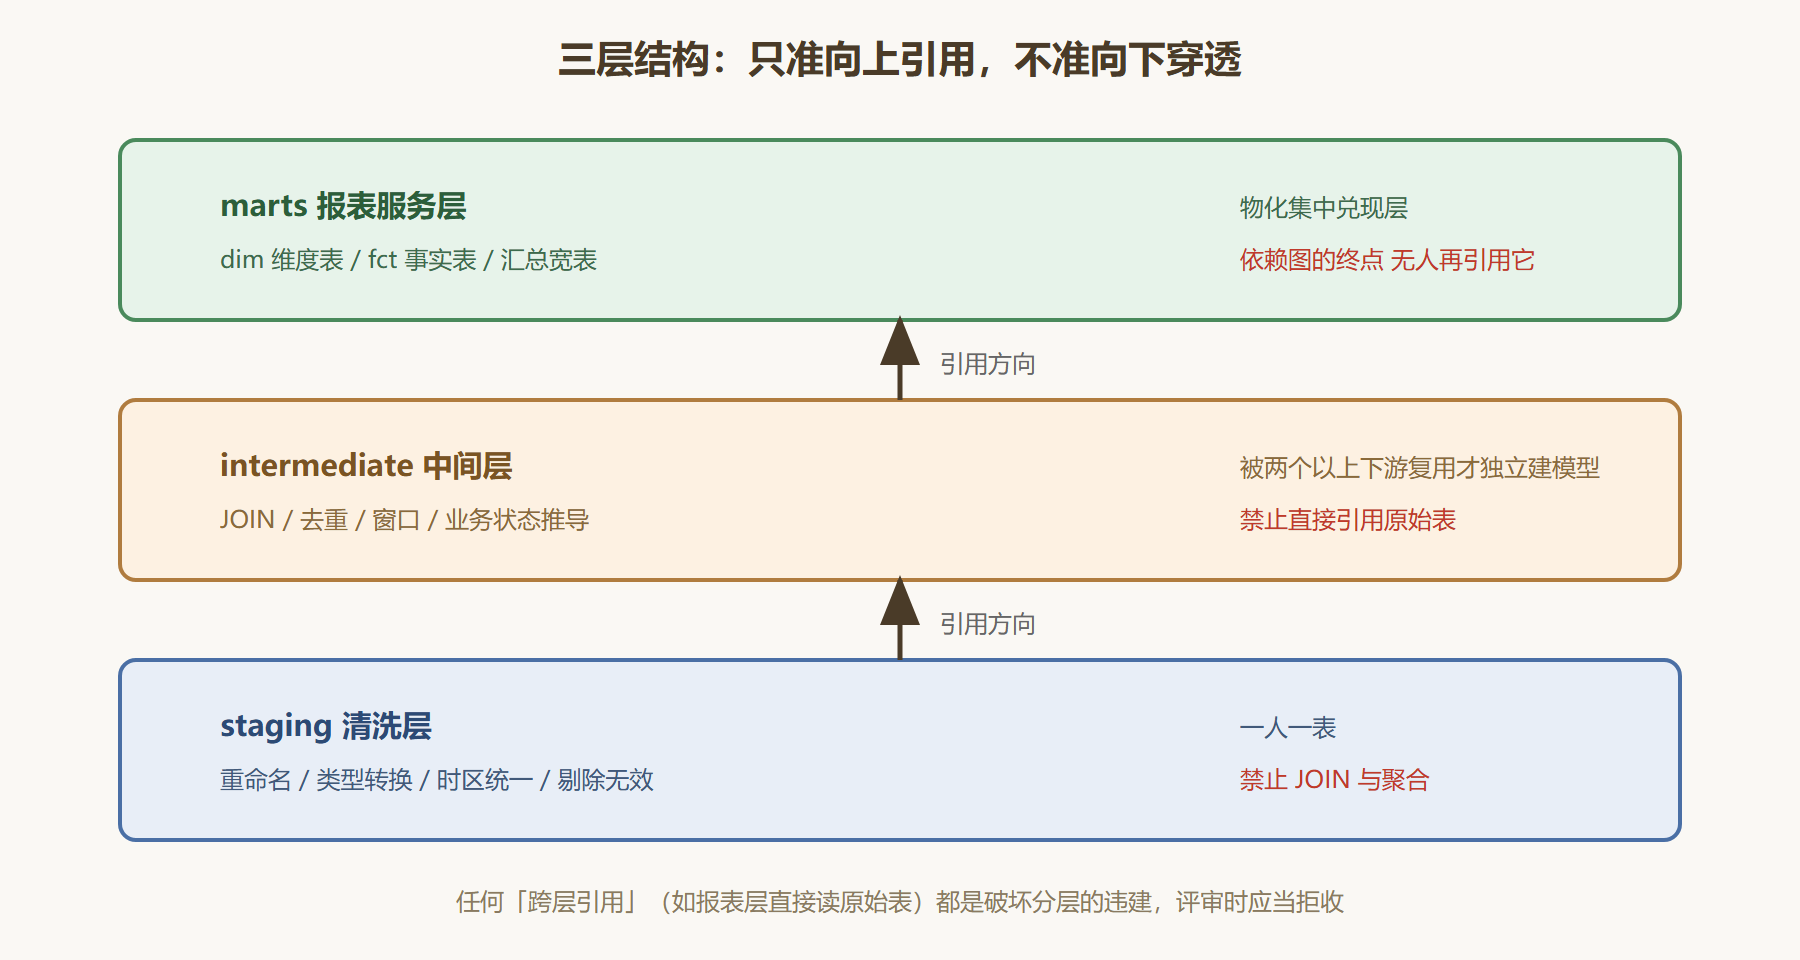
三层的职责红线,每一条都值得写进团队规范:
贴源清洗层(staging):一人一表——每个上游源表对应一个清洗模型。只做四件事:重命名(把源系统的神秘缩写翻译成人话)、类型转换、时区统一、剔除无效记录。不做任何 JOIN 与聚合,不丢行不加行。它存在的意义是给原始数据一个稳定、干净的「入场照」,让上游的表结构怪癖被隔离在这一层,不再向下游传染。
中间层(intermediate):业务逻辑的加工车间。JOIN、去重、窗口计算、业务状态推导都发生在这一层。它的模型通常不直接面向业务方,而是被报表层引用。中间层是三层里最自由的一层,也是最考验设计的一层——拆粗了会退化成「什么都往里塞的大杂院」,拆细了会碎片化成几十个只有单个下游的小模型。经验法则是:一段拼装逻辑被两个以上下游用到,就值得独立成模型;只有单个下游且逻辑简单,就内联在报表模型里。
报表服务层(marts):面向消费的最终形态。按业务建模惯例分为维度表(dim 前缀,描述实体)与事实表(fct 前缀,记录事件),以及面向特定看板的汇总宽表。这一层的模型只被 BI 与应用消费,不被其他层引用——它是依赖图的终点。物化策略也集中在这里兑现:报表层用表或增量(2.2 节四要素法的应用),清洗层用视图。
图:三层的职责边界与引用方向
每层要落到不同的 schema 吗
值得,这是把「分层」从目录约定变成物理事实的手段。三层的模型各自配置目标 schema(或数据集),至少带来两个收益:一是权限有了物理抓手——BI 账号只授报表层 schema 的读权限,分析师进不了清洗层,6.3 节的「消费面收敛在报表层」靠的就是这道物理边界;二是成本与问题排查有了边界——「慢查询集中在哪个 schema」「存储增长来自哪一层」,答案不用翻代码就出来了。配置本身很轻:
# 项目配置:按层落 schema models: my_project: staging: +schema: staging # 贴源清洗层 intermediate: +schema: analytics # 中间层 marts: +schema: marts # 报表服务层
一个连带的好处是命名自解释:看到表名里的 schema 前缀,就知道它住在哪一层、可不可以被直接消费——与三段式命名一起,构成「看名字即懂结构」的双重保险。
命名:让目录自解释
规范如果只分层不命名,等于图纸只画了承重墙没画房间门牌。一套在多个项目里跑通过的三段式命名:
- 前缀定层:stg、int、dim、fct。看前一个词就知道模型住在哪一层;
- 业务域定归属:订单域、用户域、支付域,用一致的域词(orders、customers、payments),不要同一个域今天叫 order 明天叫 trade;
- 后缀定形态:明细不加后缀,汇总表加 summary 或 agg,快照表加 snapshot。
对照实例:stg_orders(订单源表的清洗版)、int_orders_customers(订单与用户的拼装)、fct_orders(订单事实表)、sales_summary(销售汇总宽表)。一个新人看到 fct_payments_refund_summary 这个名字,不需要打开文件就知道:支付域、退款相关、事实型汇总表、住在报表层。命名即文档——这是名字被认真设计过的项目共同的特征。
⚠️ 常见坑:分层规范最大的敌人是「紧急需求」。上线前夜业务方要一个数,有人抄近道在报表模型里直接引用了原始表——一次违建,两次效仿,三个月后分层名存实亡。对策不是靠自觉,而是把「跨层引用」变成评审时肉眼可见的问题(依赖图上方向反了的边一眼就能看到),并给紧急需求留一条正门:先出一次性查询结果应急,第二天补正规模型。堵死所有正门、又不给应急出口的规范,一定会被绕开。
分层的两个衍生问题
中间层是不是可有可无
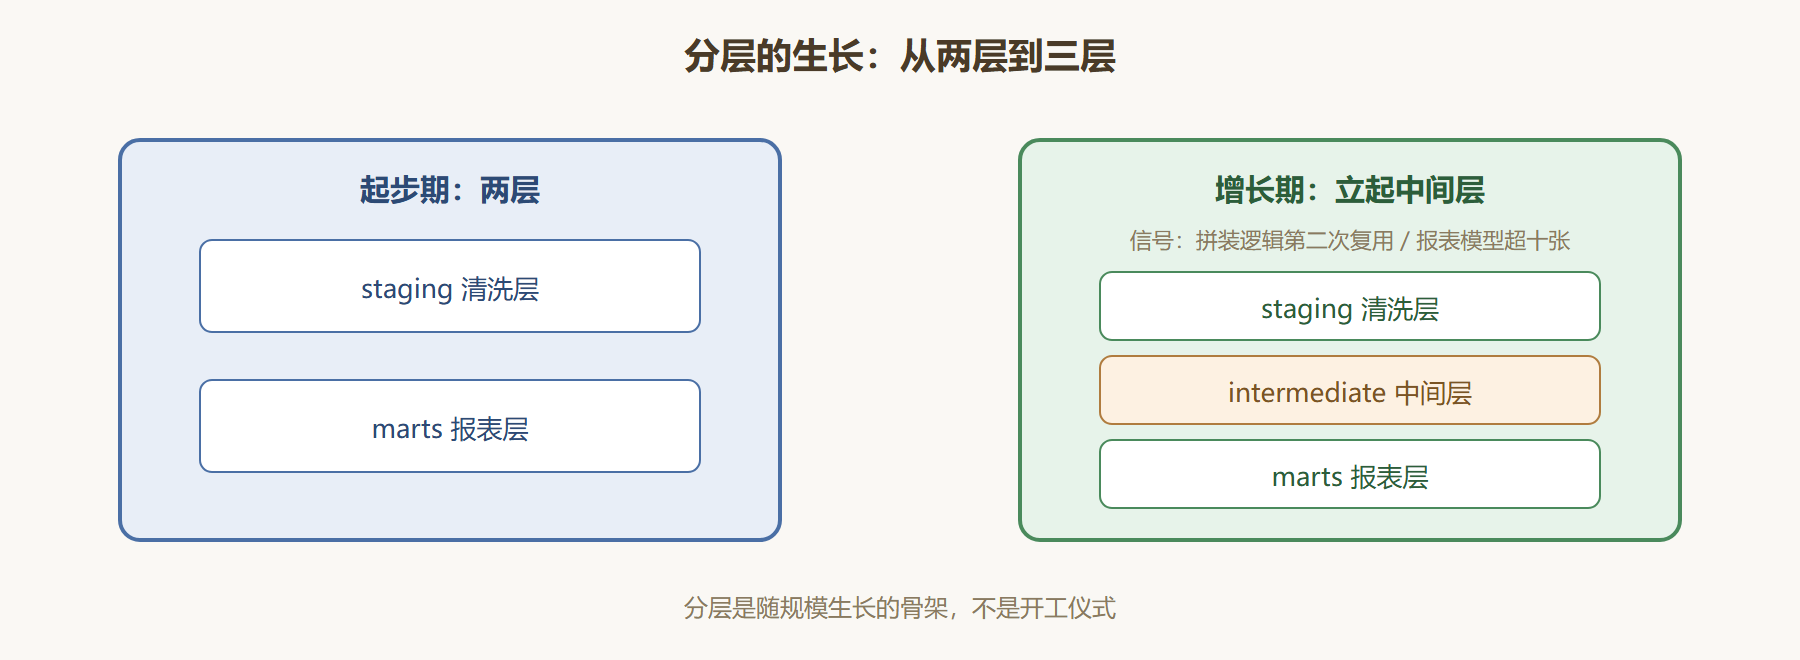
小项目里常见这个疑问:清洗层直接到报表层,两层不够吗?能跑,但会在两处开始疼。第一处是逻辑重复:报表层多张宽表都需要「订单拼用户」的同样拼装,没有中间层就得各抄一份,改一处漏一处。第二处是报表层膨胀:清洗逻辑、业务拼装、报表形态挤在报销表层的目录里,层的「可读性红线」名存实亡。经验节奏是:项目起步时两层(清洗、报表)完全可以接受;当同一拼装逻辑出现第二次复用,或报表模型开始超过十张,就把中间层立起来。分层不是仪式,是随规模生长的骨架。
清洗层「一人一表」遇到宽源表怎么办
有些上游源表一百多个列,清洗模型照抄一遍 columns 列表又长又难维护。这里的规范弹性是:清洗层允许「按业务域拆列组」,即一张宽源表拆成两个清洗模型(如订单基础信息、订单物流信息),各自透传自己域的列。拆的前提取决于下游消费模式——下游从来不会同时用两组列,拆开反而减少每个下游的扫描宽度。红线仍然只有一条:清洗层不 JOIN、不聚合,拆分是纵向的列拆分,不是横向的行加工。
图:分层随项目规模的生长节奏
本节要点回顾
- 分层是防腐骨架:三层结构让每种处理逻辑有固定去处,依赖方向从任意生长变成自下而上。
- 三道职责红线:清洗层不做 JOIN 聚合,中间层不碰原始表,报表层是依赖图终点。
- 命名三段式:前缀定层、业务域定归属、后缀定形态,让文件名即文档。
- 规范的存亡靠流程:跨层引用要在评审里可见,紧急需求要留正门,否则规范活不过一个季度。
图纸画好了,下一节进场验材料:上游的原始表如何登记在案、参照数据如何进版本库、数据「到没到货」怎么监控。