3.2 数据源、种子与新鲜度监控
3.2 数据源、种子与新鲜度监控
本节摘要:施工前先验材料。本节讲两类「进场材料」的管理方式:用 source 声明把上游原始表统一登记在案,让所有模型从同一个入口引用原始数据,并顺带获得新鲜度监控;用 seed 把小体量的参照数据收进版本库,让映射表、字典表和代码一起走评审。两类材料都管好的项目,上游故障和口径漂移都能在第一时间被发现。
进场的材料要先登记
工地上的规矩:所有进场材料先登记验收,再投入使用——谁供的货、什么时候到的、验收人是谁,台账上都有。dbt 里对应的机制就是 source 声明。
回想 2.1 节的语义分野:模型引用模型用 ref,模型引用原始表用 source。后者不只是个函数调用,它要求原始表先在一个集中的声明文件里登记:
# 源声明:登记上游原始表的台账 sources: - name: ecommerce_raw # 源系统的逻辑名 database: warehouse schema: raw tables: - name: raw_orders loaded_at_field: updated_at freshness: # 新鲜度:超过阈值告警 warn_after: {count: 6, period: hour} error_after: {count: 24, period: hour} - name: raw_customers loaded_at_field: updated_at freshness: warn_after: {count: 24, period: hour} - name: raw_payments
登记之后,所有模型统一这样引用:{{ source('ecommerce_raw', 'raw_orders') }}。这个机制的价值分三层:
第一层,引用入口唯一。 原始表在仓库里的真实位置(库、模式、表名)只写在这一处。上游迁移表位置时,改一行声明,全项目生效——如果没有这层间接,迁移意味着全局搜索替换每一个引用点,漏一处就是一个运行期报错。
第二层,出处可审计。 想知道「订单明细模型的数据从哪来」,沿着 source 走两条边就到原始表;反向查「这张原始表喂了哪些下游」,血缘图上一点全出。没有登记的材料是黑户,出了问题连召回范围都圈不出来。
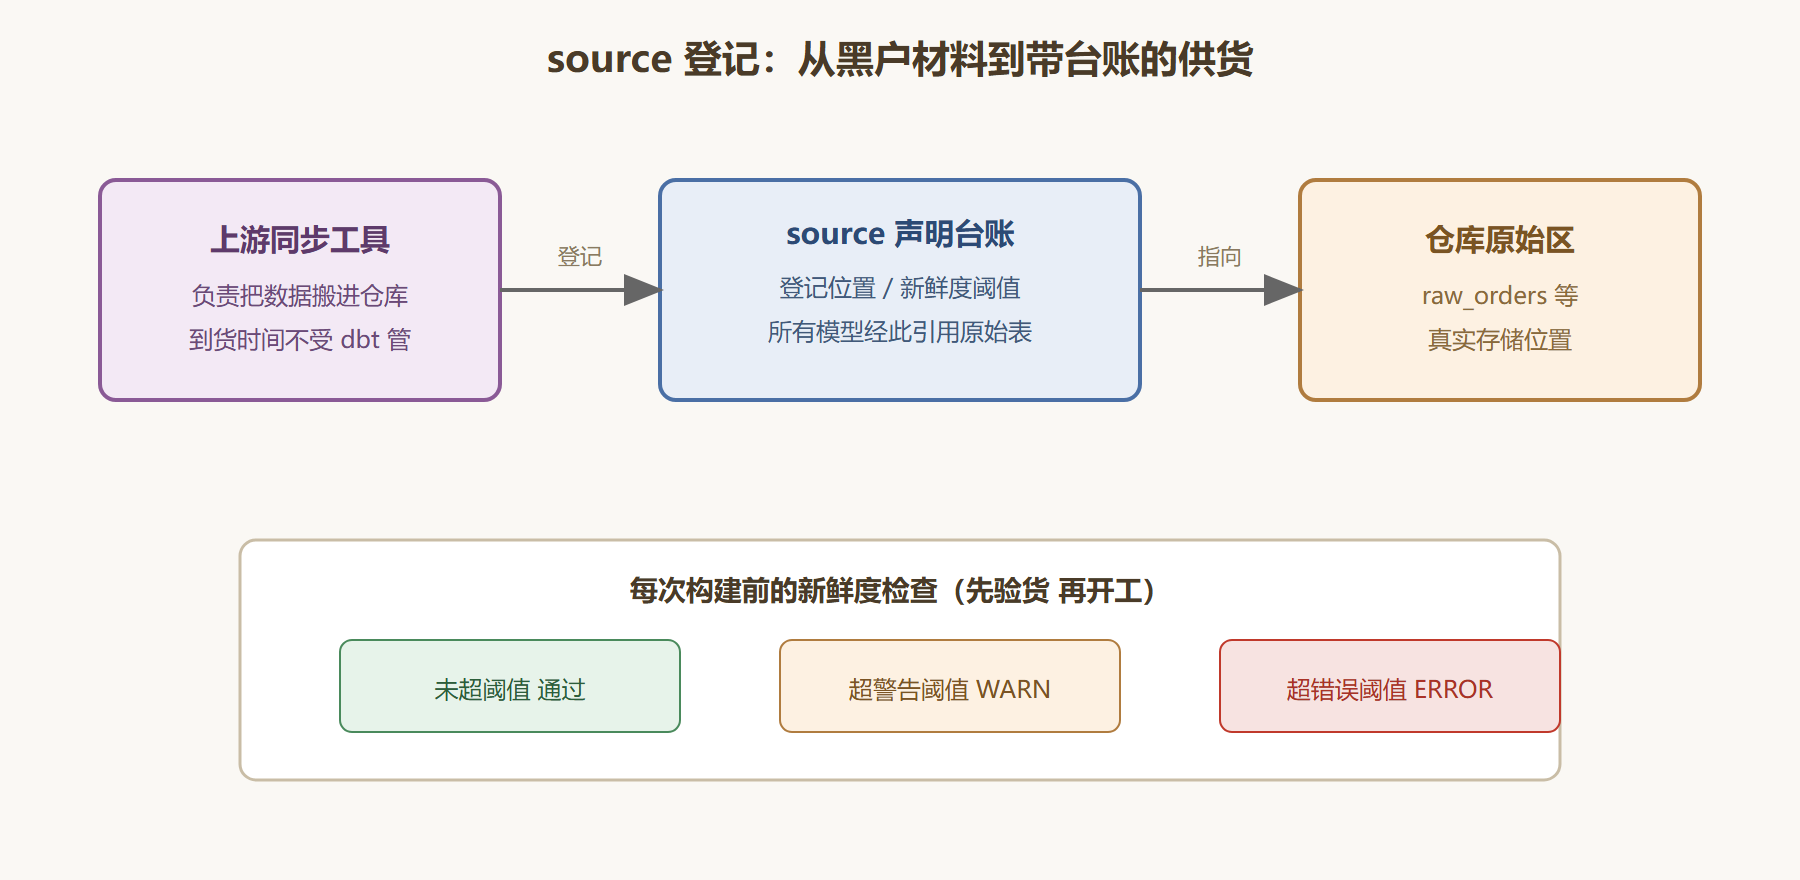
第三层,新鲜度可监控。 声明里的 freshness 配置是一份到货契约:loaded_at_field 指明用哪个字段判断数据的新旧,warn_after 与 error_after 定义两级阈值。运行新鲜度检查命令时,dbt 逐表查「最新一条记录的更新时间距现在多久」,超过警告阈值出警告、超过错误阈值报错。把这组检查挂在调度最前面,就形成了「先验货、再开工」的工序——上游没到货,下游不白跑。
图:源声明在数据链路中的位置与新鲜度检查
一个新鲜度救场的案例
背景:某团队的订单宽表每天凌晨五点构建,供八点的经营晨会用。某天上游同步工具的一次任务静默失败(运维侧显示「执行完成」,实际只搬了一半分区)。没有源检查的日子里,这样的故障要到早上八点会上一堆人对不上数才被发现,而且第一反应永远是「是不是 dbt 跑错了」。
接入 source 新鲜度后的流程变成:凌晨五点调度先跑新鲜度检查,订单源表的最新记录时间停在昨天下午,超过六小时警告阈值——调度日志立刻出现 WARN,继续跑会出 ERROR 时按配置直接中止本次构建,并向值班群发告警。值班工程师五点二十定位到同步任务失败,重跑同步,五点四十手动触发构建,八点的晨会照常开。
解读这个案例:新鲜度检查没有修复任何故障,它改变的是故障被发现的时间——从「业务方用数时」提前到「构建开始前」。故障发现得越早,排查的语境越干净(此时上游刚出问题,下游还没被污染);发现得越晚,你面对的是一整条被污染的血缘。变式:对关键源可以把 error_after 的动作配置成「中止构建」,对次要源只配警告不阻断——验货标准按材料的重要性分级,不必一刀切。
种子:放进版本库的参照数据
第二类材料是种子(seed):放在项目文件里的 CSV 数据,一条命令即可装载进仓库成为表。适合它的是三类小数据:映射表(如门店编号到区域的对照)、业务字典(如订单状态码到状态名)、分析用的假设参数。
store_id,store_name,region,city S001,旗舰店,华东,上海 S002,滨江店,华东,杭州 S003,南山店,华南,深圳
种子的价值在于它随版本库走评审:区域归属调整时,改 CSV、提交、评审、合并,改动的每一行都有记录可回滚——对照直接在数据库里手改映射表的方式,后者改错没人知道、改对也没人记得。
种子的边界同样要划清:几百万行以上的数据不要当种子(装载慢、版本库膨胀、评审看不过来),频繁变化的业务数据不要当种子(它是手工维护的快照,不是同步管道的替代品)。种子是参照数据的家,不是数据同步的捷径。
💡 关键直觉:source 与 seed 一进一出,构成项目与外部世界的两道门——source 是别人递进来的原材料入口,seed 是我们自己准备的参照材料入口。两道门都有台账,项目的数据来源就永远说得清。
源登记的三个实操疑问
上游表很多,声明文件会不会失控
会——如果不加管理的话。治理手法和模型一致:按源系统分组,每组一个声明块,配合统一的命名前缀;更重要的是「登记纪律」——只有真的被模型引用的表才登记,注册不用的表等于制造死库存。季度盘点时(4.2 节的盘点习惯可以通用),对着声明清单问一遍「这张表还有下游吗」,没有的就连同引用它的废弃模型一起清理。
新鲜度阈值怎么定才不闹狼来了
定阈值的依据不是拍脑袋,而是上游同步任务的「历史行为统计」:查看过去一个月每次到货的实际间隔,取常见间隔的一点五倍做警告阈值、三倍做错误阈值。小时级同步的任务,警告六小时、错误二十四小时是常见起点;天级同步的任务,警告放宽到一天半。阈值上线头两周是校准期——出现了两三次误告警就放宽,一次真故障没抓到就收紧。阈值是可校准的仪器参数,不是一次定死的军令。
种子数据更新了,仓库里的表会自动变吗
会,但只在你主动装载时。种子文件改动走完评审合并后,需要执行装载命令(或在构建流程里带上装载步骤)才会写进仓库——「合并即生效」只发生在代码层,数据层要等装载动作。这正好是个合理的保险丝:映射表的变更通常需要下游同步核对,装载时机由人把握比自动跟随更稳。5.2 节的流水线里,装载步骤一般放在构建之前,种子变更随同一次发布一起生效并被测试验证。
上游加列、改列名,项目会立刻炸吗
不会立刻,但会留下暗伤,两类变化要分开看。加列:现有模型照常构建——没人引用新列,它只是静静躺在源表里,直到某个模型开始透传它;这时的风险是「静默可用」,新列没登记进源声明与清洗模型,下游用硬编码方式去够它就会绕过分层(1.3 节说的暗边)。改名与删列:引用它的模型当场编译或运行报错,报错直接指向具体模型,定位不难,修复属于机械劳动。真正的暗伤是第三类——「改含义」:字段还叫那个名字,口径已从下单时间换成支付时间,编译不报错、结构测试抓不住,唯一防线是 3.3 节的业务断言加协作约定。所以源治理的最后一块拼图不在工具里:把「上游 schema 或口径变更须提前报备」写进与源系统团队的协作规范,比任何配置都管用。
本节要点回顾
- source 是台账不是别名:唯一引用入口、可审计出处、附带新鲜度契约,三层价值层层递进。
- 新鲜度检查改变故障发现时间:从业务方用数时提前到构建开始前,早发现意味着干净的排查语境。
- 验货分级:关键源超阈值可中止构建,次要源只告警,标准按材料重要性定。
- 种子管参照数据:进版本库走评审可回滚;大数据量与高频变化的数据不进种子。
材料验完,该定验收标准了。下一节讲测试体系——怎么让「字段非空、主键唯一、枚举合法」这些检查在每次构建时自动执行。