4.3 性能调优指南
4.3 性能调优指南
本节摘要:构建越来越慢是每个 dbt 项目的必经阶段。调优的第一原则是先诊断后开方:本节给出一套四步诊断法,把「整个构建三小时」这种模糊的抱怨拆解成「哪一个模型、慢在哪一步」的具体问题,然后按「编译期省、运行期快」两条线给出对应手段——少生成废 SQL 是免费的优化,分区聚簇与增量化是数据层的优化。盲目加机器是调优的下策,本节解释为什么。
工期都耗在哪里
先建立一个正确的心智:dbt 构建的总耗时 = 每个模型的耗时之和,再减去并行的收益。所以「构建慢」永远是「某些模型慢」,不是一个笼统的系统问题。调优的对象是具体的模型,就像工期延误要定位到具体工序,而不是给全工地加班。
四步诊断法,从模糊到具体:
第一步,看执行日志的总账。 每次构建结束的输出里列着每个模型的状态与耗时,按耗时排序,前几名一目了然。多数项目的耗时分布高度集中:百分之二十的模型吃掉百分之八十的时长。总账大致长这样:
# 构建输出总账(节选,按时长倒排) Concurrency: 4 threads fct_orders SUCCESS 0h 14m 12s int_daily_sales SUCCESS 0h 3m 58s dim_customers SUCCESS 0h 0m 41s stg_orders SUCCESS 0h 0m 7s
看总账别漏一个细节:并发线程数。四个线程跑两小时和十六个线程跑两小时,含义完全不同——后者说明仓库侧算力被排队吃掉了,这直接影响第二步的分段判断。
第二步,把总时长拆成段。 对排名靠前的慢模型,区分三类耗时:编译与依赖解析(通常秒级,可忽略)、仓库排队(请求多算力少的等待)、真正的 SQL 执行。多数「慢」其实慢在第三类,但排队型慢站(高峰期挤在一起跑的大模型)也不少见——它的解法是错峰或提算力,和 SQL 写法无关。
第三步,看这个模型在仓库侧的执行计划。 把编译产物拿到仓库里解释一下,看扫描量集中在哪:全表扫了大表?某个 JOIN 把行数放大了几十倍?一个聚合把明细从头算了一遍?这一步通常能直接指出病灶。
第四步,回到设计层问一句。 这个模型的数据量配它的物化方式吗?它是不是在每次构建时重算明明可以增量算的东西?很多「慢」不是 SQL 写得差,是物化选型落后于数据量的增长——量级变了,2.2 节的选型结论就该重算。
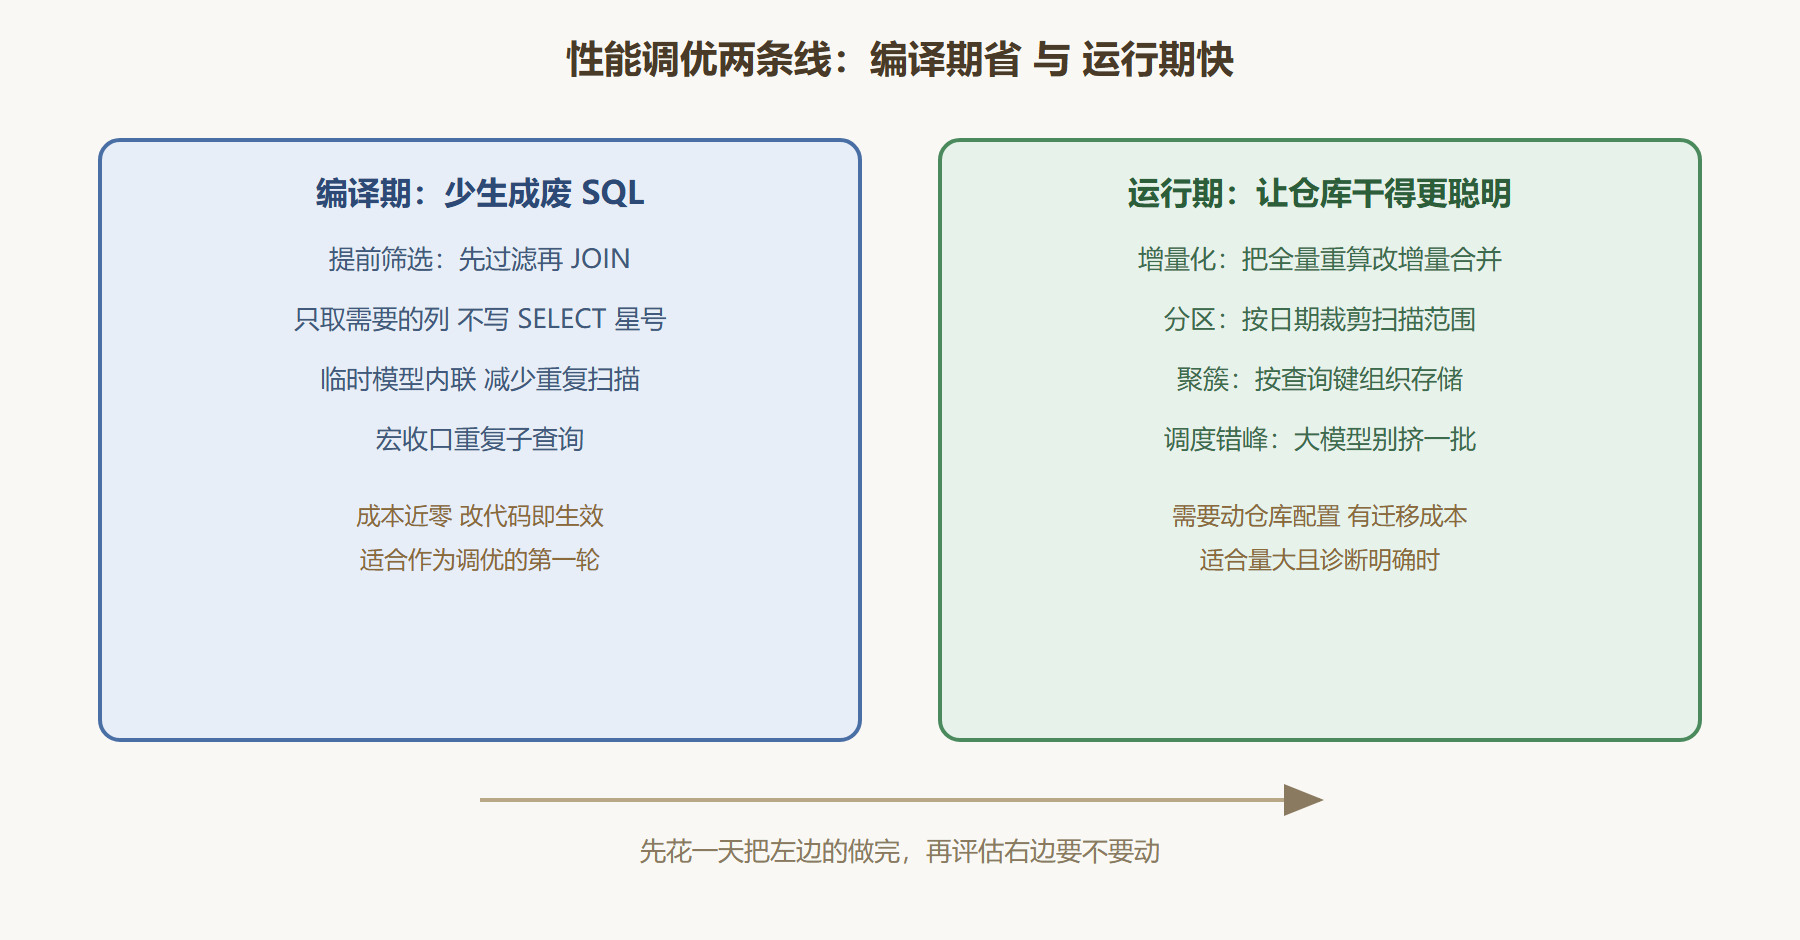
图:调优手段的两条战线
编译期:免费的那部分优化
编译期优化改的是 SQL 本身,不碰仓库配置,成本几乎为零,永远是调优的第一轮。三个高频手法:
先过滤再连接。 一个查了三亿行、过滤完只剩五百万行的 JOIN,写法顺序不同扫描量差一个量级。CTE 结构让过滤逻辑前置变得自然:先定义过滤后的子集,再拿子集去 JOIN。这类优化的原理谁都懂,难的是在几十个模型的存量代码里把它们找出来——诊断法第三步的执行计划就是探照灯。
只取需要的列。 SELECT 星号在贴源清洗层是合理的(它的职责就是完整搬运),但在中间层与报表层是浪费:列多意味着扫描宽、传输重、下游物化的存储大。规范上一条硬规矩:除清洗层外禁止星号。
别重复扫同一张表。 一个模型里对同一张明细表扫了五遍(五个独立子查询各扫一次)的写法并不罕见,CTE 定义一次、多处引用,仓库优化器能识别为单次扫描。跨模型的重复扫描则靠宏收口或临时物化内联。
运行期:动仓库的那部分
编译期手段做完还慢,才轮到运行期。按性价比排序:
增量化优先。 这不是新话题——2.3 节的增量模型就是把「每次重算十亿行」变成「每次算昨天的一百万行」。存量全量表模型转增量,是大多数项目耗时骤降的第一功臣。转的时候记得带上 2.3 节那三条防静默丢失的措施,别把慢的问题换成丢数据的问题。
分区与聚簇。 按日期分区让「只查最近七天」的查询只扫七个分区;按高频查询键聚簇让过滤与 JOIN 的裁剪更狠。注意这是仓库配置不是 dbt 概念——dbt 的模型配置支持把这些参数随模型声明,但参数选什么键,取决于你的查询模式,先看查询日志再定键,别拍脑袋。
调度错峰。 排队型慢站靠这个解:构建日志里如果大量模型状态是「等待队列」,说明同一时刻挤了太多大活。把没有依赖关系的重模型拆到不同时段的调度批次(用选择参数按目录或标签挑模型),或者错开 BI 高峰期,总时长立降。
一个真实项目的调优账单可以作参照:某项目全量构建两小时四十分。四步诊断定位出三个慢模型:订单事实表(全量重写六千万行)、日销售聚合表(每次扫全量明细)、渠道汇总表(对聚合表再全量聚合)。处置:订单事实表转增量合并(四十分钟降到四分钟);日销售聚合表改「只聚合最近三十天加历史冻结分区」(十四分钟降到两分钟);渠道汇总表挪出高峰批次。改完总时长三十一分钟,没有加一台机器,没有动仓库规格。
⚠️ 常见坑:调优后的数字验证。把全量表改成增量表之后,第一次构建就要做新旧表全字段比对——增量化改变了数据的到达路径,任何判定条件的疏漏都会表现为数字差异。比对通过才算调优完成,光看构建变快不算。
调优的三个常见疑问
什么时候该调优,什么时候该忍
阈值是个工程判断,给个可操作的分界:构建时长影响到了迭代节奏(开发者等待本地验证的时间可感)或逼近调度窗口(构建时间开始吃掉下游消费的时间),就到了调优时刻。只影响夜间批处理、下游宽裕、业务无感的长构建,优先级可以放低——调优是花工程时间去换计算资源或时效,两边的成本都要算。唯一例外的时机是「趋势」:时长连续数周单调上涨(5.3 节的第二维监控抓的正是它),哪怕绝对值还忍得住,也要进场看一眼,趋势不会自己停。
加机器和改代码,优先哪个
先改代码,例外情形再谈机器。原因很直白:多数项目的慢是 SQL 结构与物化选型问题,加机器的收益被浪费的结构吃掉一大半——先优化再扩容,往往发现根本不用扩。例外有三:排队型慢站(4.3 节诊断第二步识别的那种)本质是算力供给问题,代码无解;数据量处于陡峭增长期,优化追不上增长;业务侧对时效的要求已到小时级,工程优化空间用尽。三种情形都成立时,扩容是合理选择——但请带着诊断结论去扩,而不是带着焦虑。
小表需要调优吗
几乎不需要,这正是「四步法」存在的意义——它先告诉你哪里不用调。百兆级的小模型,全表扫与精心设计的索引执行时间都是亚秒级,任何调优投入都是浪费。把精力集中在执行日志里前几名的大模型上(诊断第一步),小表唯一值得做的是别拖累别人:别让小模型挤在大模型的执行批次里白白排队,这在调度错峰时顺手就解决了。
调优的收益怎么守住不回弹
一次调优管不了一年,守住收益靠两个习惯。其一,把构建时长曲线交给 5.3 节的监控持续盯着——回弹几乎都从曲线抬头开始,等开发者抱怨时往往已经涨了两个月。其二,给新增模型立一条规矩:进主干前看一眼预估扫描量级,量级配物化、物化配周期,别让新债进门。有的团队在流水线里加一道「耗时预算」检查:单模型超过阈值就在评审里标黄,逼着作者当场解释或拆分。调优是排水,规矩是防水,只排不防的项目,半年后会把同一条曲线再走一遍。
本节要点回顾
- 先诊断后开方:四步法把「构建慢」拆到具体模型的具体环节,总账、分段、执行计划、设计回问。
- 编译期优化免费先行:先过滤再连接、除清洗层外禁星号、消灭重复扫描,改代码即生效。
- 运行期按性价比排序:增量化、分区聚簇、调度错峰,都要求诊断明确再动手。
- 调优完成的标志是数字比对通过:快而错不如慢而对。
- 量级变了要重算物化选型:很多慢不是 SQL 差,是 2.2 节的选型过期了。
工期压回来了,但工程化总有防不住的时候:依赖成环、测试翻红、增量丢数——下一节的三份事故档案,把处置套路一次讲透。