4.4 排错实录:循环依赖、测试失败与增量丢数
4.4 排错实录:循环依赖、测试失败与增量丢数
本节摘要:本节是三份事故档案:编译期的循环依赖报错、上线首日的大面积测试失败、增量表悄悄丢了一周数据。每份档案按「现象、定位、处置、预防」四步还原现场——它们分别对应编译期、验收环节与物化机制三类故障高发区,看完这三份,dbt 项目里过半的常见事故都有了现成的处置套路。
从一份报错日志说起
排错能力与经验的关系,比与聪明程度的关系大得多。见过的故障类型多了,报错信息在眼里就不是一行文字,而是一张已经走过的地图。本节把三份档案摊开,目的就是替你把这几张地图先走一遍——真遇到时,你只需要对号入座。
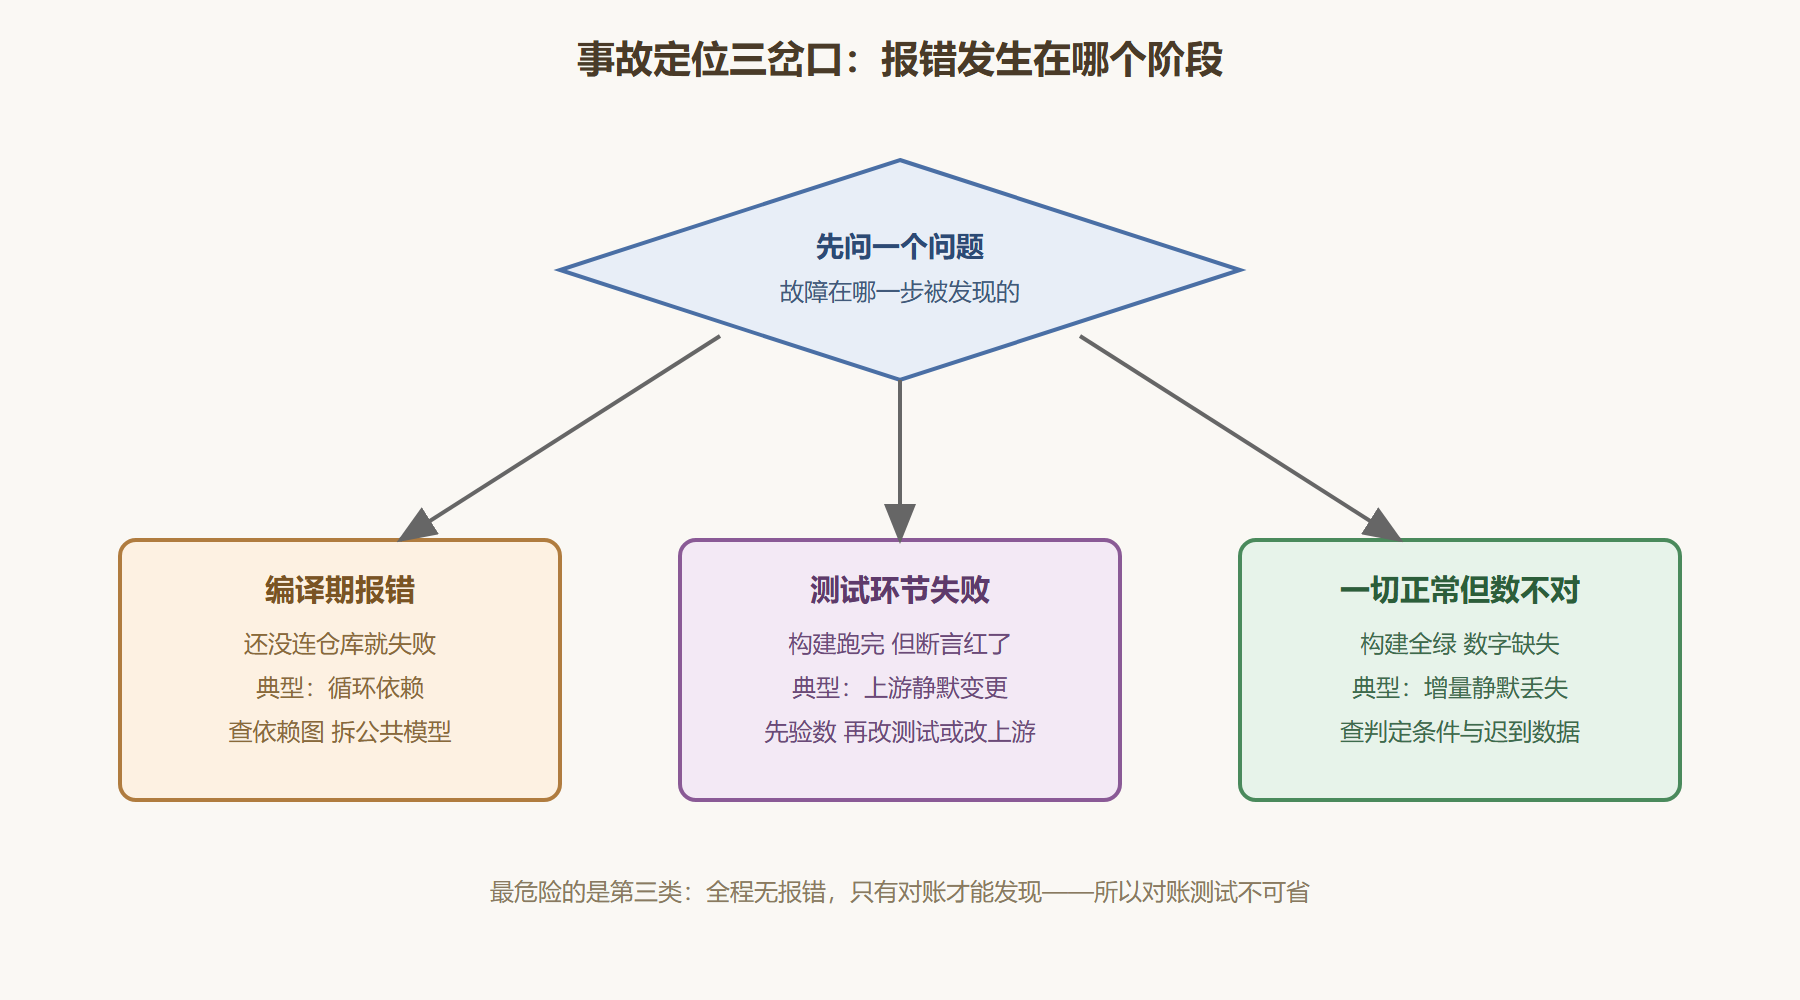
图:三类高频故障的定位路径
档案一:循环依赖
现象。 一位工程师给订单模型加退款逻辑时写下「引用退款汇总模型」的改动,提交后构建直接失败,报错指向两个模型文件,大意是检测到循环依赖。他困惑的点在于:这两个模型他都没改过依赖声明,怎么会突然成环。
定位。 循环依赖是编译期错误——依赖图构建不出拓扑排序,执行根本没开始。顺着报错读两个模型的引用:订单模型的新改动为了算「退款后金额」引用了退款汇总模型;而退款汇总模型从立项第一天起就引用订单模型(它要按订单聚合)。环其实早就半成形了,这次改动是补上了最后一道边。
处置。 环不能「解开」,只能「拆掉」。两个模型互相需要的那部分逻辑,抽成第三个模型:建一个订单基础事实模型(不含退款信息),订单模型与退款汇总模型都引用它,环消失,依赖图恢复无环。这是循环依赖的标准解法——公共需求下沉,而不是让两个模型互相伸手。
预防。 两条工程习惯:其一,设计模型时先想清楚它「被谁引用」,一边设计一边看血缘图的雏形,环在图上比在代码里显眼得多;其二,把「加引用前先看下游」变成肌肉记忆——你要引用的模型,如果它的下游里有你,就要停下来想拆分。
档案二:上线首日的测试连环失败
现象。 新项目上线首日,凌晨构建里四十多条测试同时失败,报错集中在两类:枚举值不合法、维表关系孤儿行。值班工程师第一反应是「测试配错了」,差点按「先放行、白天再查」处理。
定位。 测试失败的处置纪律是先验数、再动测试——用一条手工查询核实失败样本,确认这些数据真的有问题,而不是测试写错。抽样结果:那批「不合法枚举值」是上游系统三天前上线的新订单状态码;孤儿行来自另一张维表的重复键导致的 JOIN 失配。两件事都是真数据问题,测试没有冤枉人。
处置。 两条线并行:联系上游确认新状态码的业务含义,确认合法后更新枚举测试的白名单——这是「测试随口径演进」的正常更新,走代码评审;维表重复键则是上游同步的问题,推给数据同步侧重跑修正。两条都处理完,构建转绿。
预防。 这次事故没有「故障」,只有「暴露」——它暴露的是上线前漏了一道工序:用至少一周的历史数据回放测试。新项目的测试在开发期只跑过当天的增量数据,历史数据里埋的雷(历史遗留状态码、老维表脏键)只有全量回放才能引出来。从此这个团队的上线检查单里多了一条:全量回放测试,红灯清零才准上线。
档案三:增量表悄悄丢了一周数据
现象。 一切正常——构建全绿、无任何报错——直到业务方在月度对账时发现:渠道汇总表的周报数字连续一周偏低,缺口稳定在百分之三左右。最危险的一类故障:没有报错的错。
定位。 沿 2.3 节讲过的三条线索查。第一条线索,增量判定条件:这张表用「更新时间大于目标表最大值」判定,核对日志与数据,确认一周前有业务系统的一次批量补录——补录数据的更新时间戳是补录当刻(晚于判定水位),排除这条。第二条线索,迟到数据:比对源表与目标表的订单号集合,找到了缺口——一批订单在源表的更新时间是正常的,但其中一部分订单在同步管道里延迟了十一个小时落地,落地时的更新时间戳是「源系统生成时间」,早于目标表已记录的最大值,被增量条件永远挡在门外。第三条线索(手工修改痕迹)排除。
处置。 三步:临时把判定水位回拨三天,重跑增量合并——因为用的是合并策略,重叠窗口内的重复行会被按唯一键去重,回拨是安全的;补齐数据后核对周报数字恢复;把判定条件改成「水位回拨两小时加合并去重」的固定写法,宁可多算一点,不留静默缺口。
预防。 这类故障的预防在第 3.3 节就埋了伏笔:行数对账测试。给关键增量表挂「当日新增行数与源表当日行数一致」的对账断言,缺口在当天就会被拦截,而不是等到月底对账。静默丢失最可怕的从来不是丢多少,是「不知道丢了」——对账测试把「不知道」变成「当天就知道」。
💡 关键直觉:三类事故对应三条铁律——编译期错误是设计问题,用拆分解决;测试失败先验数再动测试,别培养「红灯即误报」的条件反射;没有报错的错误最致命,对账是唯一的探测器。
排错通用纪律:先看现场,再动手术
三份档案的处置过程里有几条反复出现的纪律,值得单独提炼,它们适用于本节没写到的所有故障类型。
复现优先于猜测。 三份档案的定位动作都从「稳定复现」开始:循环依赖每次构建必现、测试失败可用同一条查询重放、丢数可通过比对稳定观察。能稳定复现的问题,改动一次验证一次,收敛很快;不能复现的问题(时好时坏)先别改代码,把「什么时候好、什么时候坏」的差异找出来——那正是根因所在。
一次只改一个变量。 排查中最忌讳「同时改了配置又改了代码再重跑」——问题好了也不知道哪个改动是功臣,问题没好也不知道哪个改动把水搅浑。每一步改动都对应一个明确的假设:「我假设是判定条件问题,回拨水位验证」。
修复与预防分开提交。 当晚救火(回拨水位补数)与长期预防(对账测试、条件改造)是两类改动,分开做、分开提交。混在一起的结果通常是:救火动作被顺带合进主干却没人评审,预防动作被救火的紧迫感淹没而不了了之。4.4 节每份档案都有「预防」一节,就是这条纪律的产物。
排错时保护现场。 手工重跑之前先留证:报错日志全文、失败测试的样本查询结果、当时的编译产物,各存一份。救火急,改着改着现场就没了——等你想复盘「它当时到底报了什么」,日志已经被下一次构建冲掉。事故复盘的价值取决于现场保真度,这也是把故障写成 6.1 节那种可检索文档的起点。
给关键链路备好外部裁判。 三份档案里最贵的一课是:发现故障的常常不是报警,是对账。每个核心指标都值得有一个不依赖本项目链路的核对口径——财务的流水总表、上游系统的记录数、业务方月度报表里的总数。它们平时看着多余,出事时是唯一的裁判。基线核对不必每天全量:周频抽样加月频全量,配合行数对账测试(3.3 节),多数静默丢失都能在一周内现形。
最后一条心态上的:报错信息是朋友不是敌人。 编译期报错会指出文件与依赖链,测试失败会返回问题行明细——dbt 的报错设计是给排查者看的。把报错读完整再动手,比扫一眼就开始改,平均省一半时间。
本节要点回顾
- 循环依赖的标准解:公共需求下沉成第三个模型,环拆掉而不是解开;设计期看血缘图比写完再看便宜。
- 测试失败的纪律:先手工验数确认问题真伪,再决定改测试还是改上游;上线前必须全量回放历史数据。
- 静默丢失三线索:判定条件、迟到数据、手工修改;合并策略让水位回拨成为安全的补救手段。
- 对账测试是唯一的静默探测器:构建全绿不代表数据正确,数字对得上才是终点。
事故的坑填完了,项目也到了要走出开发者机器、进入生产环境的时候。下一章讲交付:环境怎么隔离、代码怎么上线、任务谁来看着。