6.1 文档与知识管理
6.1 文档与知识管理
本节摘要:文档的常见命运是「上线时写一版,三个月后没人敢信」。dbt 的文档机制换了一条路线:描述紧跟模型代码走评审,文档站点随构建自动刷新,文档的保鲜不靠自觉靠流程。本节讲描述写在哪、站点怎么建、以及什么样的文档才会真的被业务方使用。评价文档体系的标准只有一条:业务方自助找到答案的比例。
文档为什么总是过时
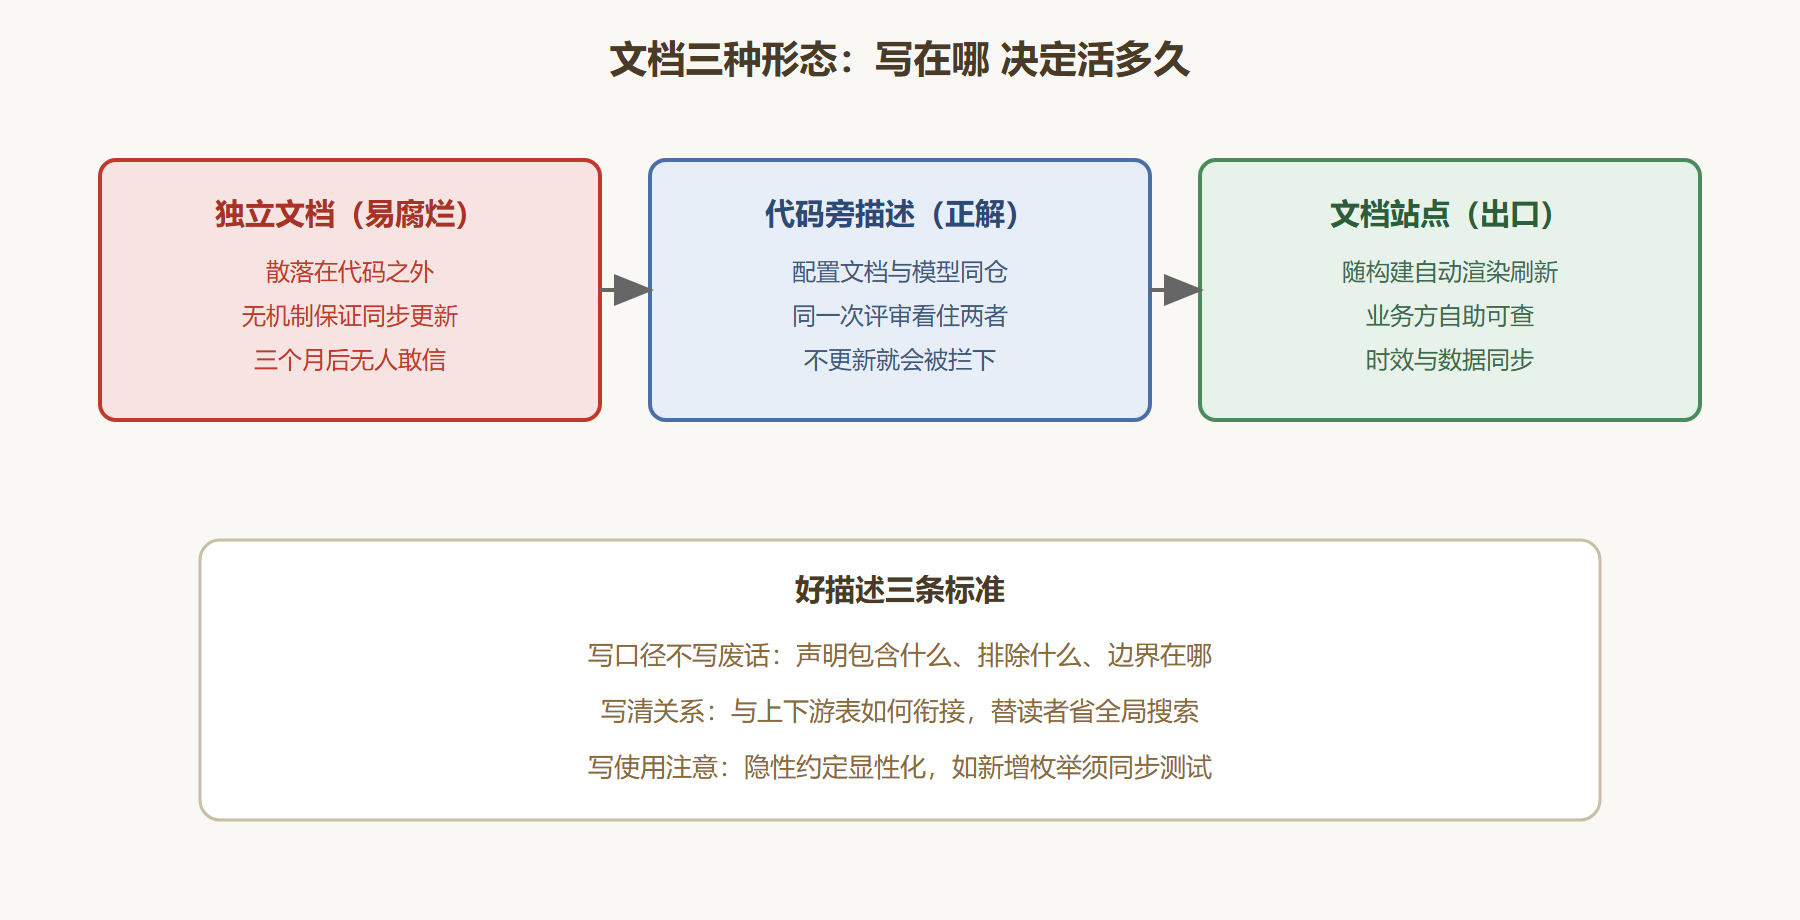
先承认一个现实:任何「单独维护」的文档都会过时,因为文档与它描述的东西住在两个地方,改其中一处没有任何机制强制改另一处。数据团队的常见景象是:模型口径三个月前改了,文档还写着旧定义,新人按文档理解,得出与报表矛盾的结论,然后开始怀疑自己的阅读能力。
dbt 的解法不是「让大家勤快点」,而是把文档搬进代码的家,让同一次评审同时看住两者。描述写在模型旁边的配置文件里,与模型一起提交、一起评审;改了模型逻辑却不改描述的合并请求,评审者一眼能看到不一致,当场要求补上。文档保鲜从「个人美德」变成「流程产物」——这是整节最重要的一句话。
描述写在哪儿
每个模型与每列都可以有描述,写在模型对应的配置文档里:
# 模型文档:与代码同仓同审 models: - name: fct_orders description: > 订单事实表:一行代表一笔订单的当前状态。 口径:不含已取消订单;金额为含税应付金额。 columns: - name: order_id description: 订单唯一编号,来源于业务系统订单主键 tests: [unique, not_null] - name: order_amount description: 含税应付金额,退款不在此列冲减,见退款事实表 - name: order_status description: 订单状态,枚举见测试定义;新增枚举值须同步更新测试
好描述的三条标准,从上面这段示例里都能看出来:
- 写口径不写废话:「不含已取消订单;金额为含税应付金额」是有信息量的口径声明;「订单表,存储订单信息」是零信息量的重复表名;
- 写清与其他表的关系:「退款不在此列冲减,见退款事实表」替读者省了一次全局搜索;
- 写使用注意:「新增枚举值须同步更新测试」把一个隐性约定显性化了。
文档站点:让业务方自助
描述写完,一条命令可以把整个项目的文档渲染成一个可搜索的站点:每个模型一页,列出字段、描述、测试、物化方式,以及它在血缘图上的位置(下一节的正题)。把这个站点的构建挂进 5.3 节的调度批次末尾,文档就随每次构建自动更新——文档时效性与数据时效性同步。
站点最大的受益者是业务方与新人。业务方想确认「成交金额含不含运费」,自助查站点十秒出答案,不再需要在数据群里艾特人;新人接手项目,从站点的业务域分组进入,照着描述读模型,第一周就能定位大部分问题。有人用的文档才有价值——而有人用的前提是找得到、看得懂、信得过(时效性)。
图:文档的三种形态与归宿
一个文档救场的案例
背景:某公司的会员报表连续两周数字偏高百分之五,业务方与数据团队各自排查无果,眼看要上升成信任问题。
操作:一位新人分析师没参与过任何历史讨论,照着文档站点查「会员活跃」的口径页——描述里写明「活跃定义为三十天内有一次下单,不含浏览」,而她注意到报表模型的实际过滤条件是六十天窗口。顺着这条线索,团队在提交历史里找到了根因:三周前一次性能优化改动中,有人把口径窗口从三十天改成六十天(为了减少计算量),改了逻辑没改描述,评审时双方都没注意。按流程补上描述更新、业务方确认口径、模型改回三十天窗口,数字恢复。
解读:这个案例里,文档同时扮演了「案发现场」与「破案工具」——描述与逻辑的不一致本身就是线索。它也说明了为什么文档要跟代码走同一道评审:评审者未必能验证逻辑对错,但「描述与逻辑对不上」是肉眼可见的。变式思考:如果团队有「口径变更必须改描述、描述变更必须@消费方」的双重约定,这次事故会在合并前被拦下——治理规则的成本永远低于事故成本。
让文档有人写的机制
最后回应一个现实问题:工程师不爱写文档怎么办?三个被验证过的机制,比提倡自觉有效:
把描述列入完成的定义。 团队约定:模型合并的完成标准包括描述齐备,缺描述的合并请求评审者有权直接打回——这是把文档变成验收工序(与 3.3 节测试同一待遇)。
优先补「消费端」的描述。 人力有限时,先给报表层模型与高频字段写描述(业务方天天查的那些),清洗层的内部模型可以缓——文档投入跟着阅读量走,别平均用力。
让文档参与排错。 4.4 节的复盘纪律在这里再加一条:每次事故复盘确认「哪条描述本可以阻止这次事故」,顺手补上。文档体系就这样从事故里一寸一寸长出来,比立军令状可靠得多。
💡 关键直觉:文档不是给「现在的自己」看的,是给「三个月后忘了上下文的自己」和「第一次进场的别人」看的。写得越接近这两类读者的提问方式,文档就越有用。
文档的两个延伸话题
指标口径要不要单独管理
当「同一个指标被多个模型引用」或「业务方频繁追问口径」时,答案是要。两种承载方式:轻量方案是把指标口径写进报表层模型的描述(3.4 节电商项目就是这么做的),配一条 accepted_values 或量级哨兵测试守住定义;重量方案是引入指标语义层——单独声明指标(名称、维度、聚合规则),下游统一消费声明而非各写各的 SQL。判断标准用消费面数量:被三处以下引用的指标,描述加测试够用;核心指标被五个以上消费端引用、或频繁发生口径争议的,值得语义层。与 6.4 节的演进趋势呼应:指标定义正在从项目实践走向平台能力,今天写在描述里的口径,未来有更标准的家。
文档站点谁来维护、放给谁看
维护成本比想象低——站点随构建自动刷新(5.3 节调度批次的收尾工序),人力维护只剩「描述本身的质量」,而这已由评审流程兜住。放给谁看则值得主动设计:最低配置是团队内可访问;进一步的推荐做法是把站点链接放进报表工具的数据字典入口,让业务方「查表义」的动作有一条固定路径——文档的价值在触达率,触达率的敌人是「不知道有这东西」。观察一段时间的访问记录,访问少的板块要么是没价值(砍掉省维护),要么是没触达(补入口),两种处置都比放着强。
存量项目一行描述都没有,从哪补起
别立「三个月补齐全项目描述」的军令状——运动式补文档的常见结局是补到两成就停,而且补出来的部分从没被读过。可持续的节奏是跟着流量补:先给被问得最多的五张表写全描述(它们贡献了大多数口径询问),再把「改哪个模型就同步补哪个模型的描述」写进评审规则,让存量描述随变更自然生长。一两年下来,覆盖率会停在一个与阅读需求匹配的水平——核心链路全覆盖、边缘模型空白,而这个分布恰恰是对的:文档是给人读的,没人读的模型配不上也不需要文档。中途还要防一件事:补描述的人手别扎堆在清洗层——它离业务最远,同样的字数换来的阅读量最低。
本节要点回顾
- 文档过时的根因是分居:描述搬进代码的家,同一次评审看住两者,保鲜靠流程不靠自觉。
- 好描述三条标准:写口径、写关系、写使用注意,不重复表名。
- 站点随构建刷新:文档时效与数据时效同步,业务方自助查询是最终出口。
- 描述列入完成的定义:文档与测试一样是验收工序,不是可选项。
- 文档投入跟着阅读量走:先报表层与高频字段,内部模型缓。
文档回答了「这是什么」。下一个更高频的问题来自变更时刻:「改这个模型,会动到谁?」——血缘与影响分析登场。