6.2 数据血缘与影响分析
6.2 数据血缘与影响分析
本节摘要:血缘图不只是好看——它是变更决策的计算器。本节讲血缘的两个使用方向:上游溯源回答「这个数从哪来、可不可信」,下游影响回答「改这张表会动到谁、影响多大」,并给一份基于血缘的变更预案模板。有了它,「这张表能不能动」从一句凭感觉的问话,变成一次十秒钟的查图。
这张表能不能动
每个数据团队都被问过这个问题,形式五花八门:运营想合并两张重复的表、上游想改一个字段类型、新人想清理「看起来没人用」的旧模型。在血缘靠记忆维护的年代,答案靠老员工的脑子——脑子清楚则平安无事,脑子打个盹就是一次「下游报表集体开天窗」。
dbt 的项目里,这个问题有一个机械化的答案。回想 2.1 节:每次编译,ref 依赖边被完整收集成一张有向无环图。这张图有两个使用方向,对应两类问题:
上游溯源(顺着边往回走):这张表的数从哪来?中间经过了什么加工?最底层的数据源可信吗?典型场景是数据质量争议——报表上一个可疑的数字,沿上游逐层核对,几步就定位到是源数据问题还是加工逻辑问题。
下游影响(顺着边往前走):如果改这张表,哪些模型会被波及?每个被波及的模型又支撑着哪些报表与看板?典型场景就是开头那个问题——变更影响面的计算。
两个方向拼在一起,血缘就是一张「数字的户口簿」:每张表从哪来、到哪去、中途被谁动过,一图可查。
影响分析的实操:一次变更的完整推演
用 3.4 节电商项目里的场景走一遍。需求:运营要求订单渠道字段增加一个新渠道值「直播」,并确认这次变更不影响现有报表。
第一步,圈出改动点:清洗层的 stg_orders(新增渠道的透传)与报表层的 sales_summary(渠道维度新增取值)。
第二步,查下游:在血缘图上选中这两个模型,看它们的下游。stg_orders 的下游比想象的多——订单事实表、日销售聚合、以及一张容易被忽略的退款分析模型都在引用它。sales_summary 没有下游(依赖图终点),但挂着三个看板。
第三步,逐一下游评估:订单事实表与日销售聚合对渠道值不敏感(只是透传与聚合,新值自动多出一行),风险低;退款分析模型里有一段按渠道白名单过滤的逻辑,新渠道不在白名单里,直播渠道的退款会被静默过滤——这是一个不加处理就会丢数的暗雷;看板侧需要确认渠道筛选器是否会漏显新值。
第四步,产出变更预案(模板如下,可直接抄用):
变更影响分析单 - 变更内容:渠道新增「直播」值 - 改动模型:stg_orders、sales_summary - 下游波及:fct_orders(低风险)、int_daily_sales(低风险)、 refund_analysis(高风险:渠道白名单需同步扩充) - 消费端影响:3 个看板,渠道筛选器需确认兼容 - 测试补充:为 sales_summary 的渠道枚举测试加入新值 - 上线顺序:先合白名单扩充,再合渠道透传,最后更新测试 - 验证动作:上线后比对直播渠道订单数与业务系统后台
这份预案的价值不在格式,在于它逼着变更者在动手前把依赖图的下游走完一遍。血缘图把「走完一遍」的成本从半天(人肉排查)降到十分钟(查图),成本一低,动作就普及了。
图:一次字段变更的影响波及面
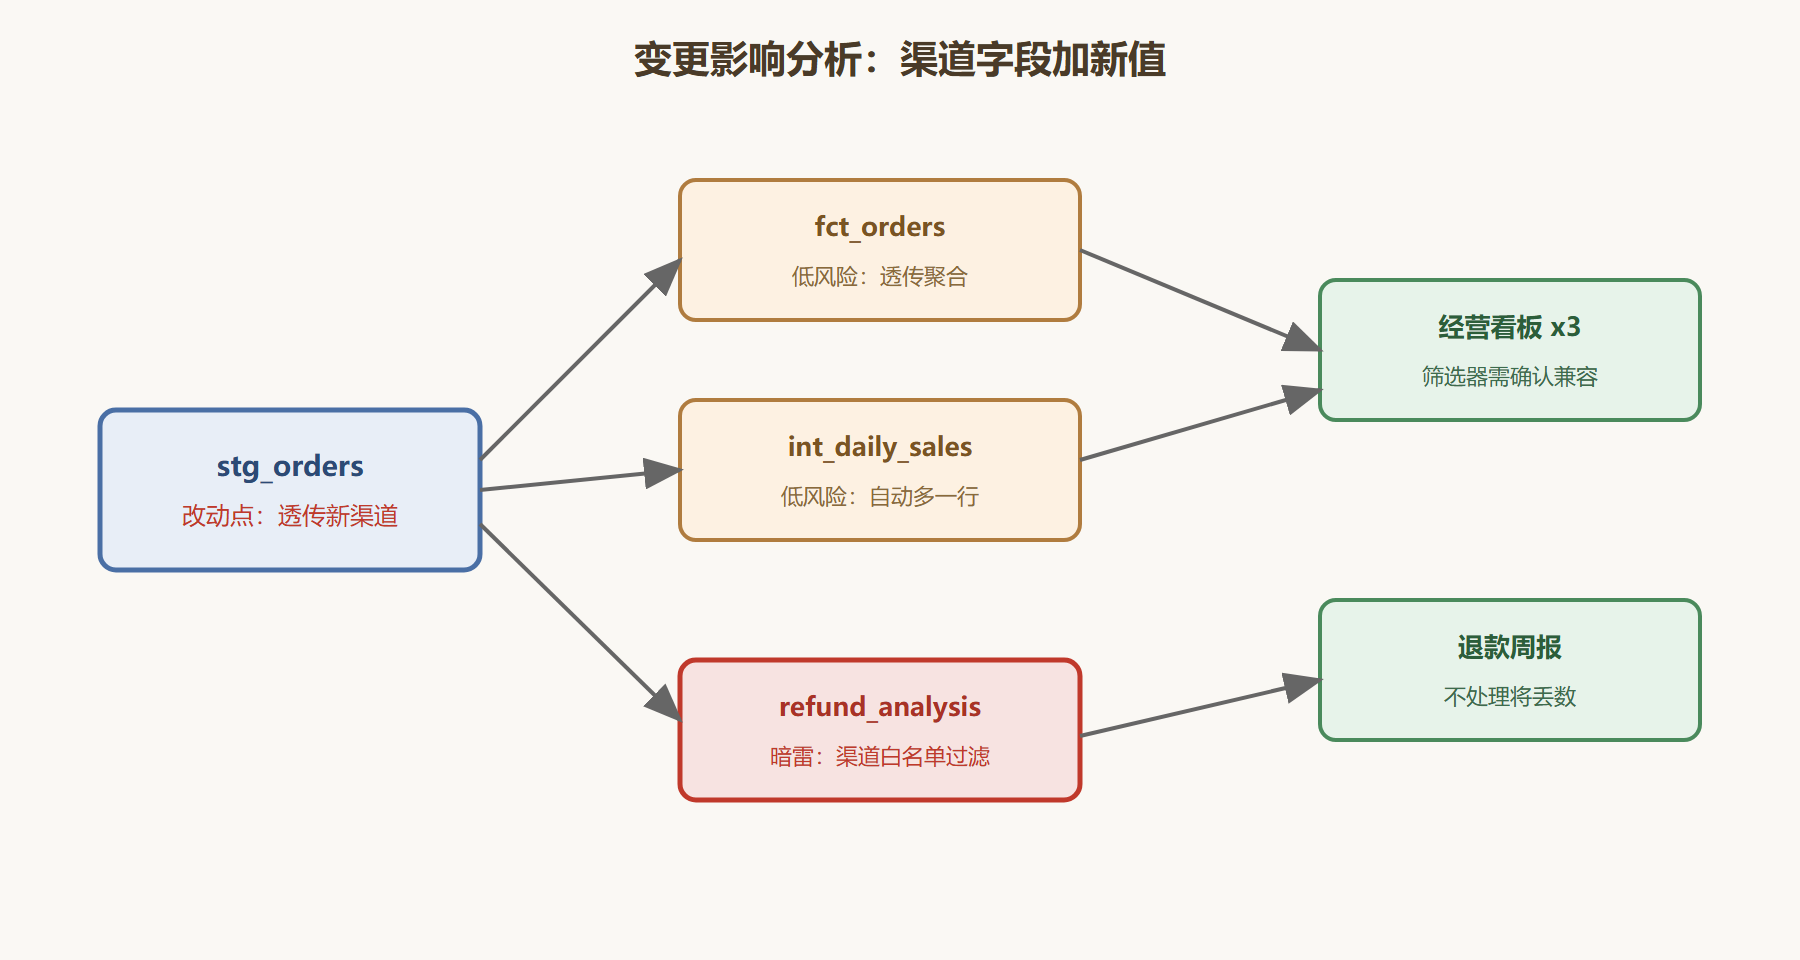
血缘的两个日常使用场景
除了变更推演,血缘在日常工作里还有两个高频出场时刻,熟悉它们能让「查图」成为习惯而不是仪式。
数据可信度争议的溯源。 业务方质疑「这个数字不对」,第一反应不该是打开报表复核,而是沿血缘往上游走:数字由哪个模型产出、它的上游源表是什么、中间有没有已知的风险点(比如 2.3 节讲过迟到数据问题的那张增量表)。多数争议在两三层之内就能定位到「源数据晚到」「口径理解偏差」或「确实有 bug」三者之一——溯源把「数字对不对」的口水战,变成「哪一层出了问题」的工程问题。
新成员的接手地图。 新人接手项目,最贵的成本是建立「表与表之间关系」的心智模型。血缘图把这个成本从「翻代码两周」压到「看图半天」:业务域怎么分、核心链路是哪几条、哪些模型是枢纽(入度出度都高的节点)、哪些是末端叶子。6.1 节的文档站点把血缘嵌在每张表的页面上,新人查任何一张表时顺手就看到了它的上下游——心智模型在日常工作里自然长成,不需要专门的「熟悉期」。
顺带一个团队实践:季度架构回顾时把组级血缘图投在屏幕上走一遍,讨论三个问题——跨域依赖有没有变多、有没有疑似成环的趋势、枢纽模型是否健康(耗时、测试覆盖)。十分钟的路过,能提前发现 4.4 节档案一那种「环快要闭合」的趋势。
粒度问题:组级血缘与节点级血缘
项目大了之后(几百个模型),整张血缘图会密集到没法直接看。两个粒度各有所长:
组级血缘把模型按目录或业务域折叠成组,图上只剩「订单域到支付域」这样的大箭头,用于回答架构层面的问题(跨域依赖是否过多、有没有循环的趋势)。它适合放在架构评审与新成员入门时看。
节点级血缘展开到单个模型与单个字段,用于回答具体变更的影响面。字段级血缘(知道「这个指标由哪几个上游字段算出」)是最细的粒度,dbt 的文档站点提供模型级与列级的展示;更细的「列到列」血缘通常需要额外的元数据工具从执行日志里推断。
实操建议:日常变更用模型级节点血缘就够了(本节的预案模板即基于此);只有追查「指标口径到底受哪些上游字段影响」这类深度问题时,才需要引入列级血缘工具——别为了工具能力而维护一套自己用不上的精细血缘。
⚠️ 常见坑:血缘图「看着对、用着错」的场景——有人绕过 ref 直接写了同库表名硬编码。这条边不会出现在血缘图上,影响分析因此漏算,事故跟着来。防治法有两道:评审时把「模型里出现硬编码表名」列为必拦项;定期用「编译产物与血缘图对照」的方式抽查,发现孤立的硬编码就要求改成 ref。血缘的可信度取决于它的完整性,完整性取决于纪律。
一次漏算的复盘:影响分析为什么失手
标准流程也会失手,一份真实复盘值得记下。某团队按预案四步走完,评估「低风险」后改了清洗层的一个字段类型,当晚两张报表挂了——漏算的模型不在 dbt 血缘里,而在仓库的旧视图里:一个五年前建的存量视图直接查询了 dbt 产出的表,视图又被另一张报表引用。复盘沉淀三条结论:其一,dbt 血缘只覆盖 dbt 世界,存量视图、BI 工具里的直连查询、别的调度脚本都是图外的暗边,影响分析前要用仓库侧的依赖查询把图外引用补进来;其二,改「类型、约束」这类结构性属性时,影响半径默认放大一档——模型下游不敏感是常态,但视图与外部消费者对类型变更比模型敏感得多;其三,低风险结论也要带验证动作,预案模板里「验证动作」一项不许空着。血缘图让影响分析从不可能变成可能,但图与世界的差集,仍要靠制度补齐。
本节要点回顾
- 血缘是变更决策的计算器:上游溯源查来路,下游影响算波及,两句问话都变成查图。
- 影响分析四步法:圈改动点、查下游、逐一评估、产出预案——十分钟走完,暗雷无处藏。
- 预案模板直接可用:波及面、消费端、测试补充、上线顺序、验证动作,五项写全才动手。
- 粒度按需选:日常用模型级,深度追因才上列级,组级血缘留给架构评审。
- 血缘可信的前提是没有硬编码边:评审拦硬编码,定期抽查对照。
理解与因果都齐了,接下来是边界:谁能看什么、谁能改什么。下一节讲访问控制。