1.3 选型对比:SQLite、ClickHouse与Polars
1.3 选型对比:SQLite、ClickHouse与Polars
本节摘要:选型的本质不是"哪个更快",而是"哪组取舍和你的场景咬合"。本节把 DuckDB 与 SQLite、ClickHouse、Polars 放上同一张对比矩阵,按部署形态、存储模型、甜点区规模、集成方式逐维拆解,再用三个真实场景演示决策过程。
先看一个真实的纠结场景
一个小组同时有三类活:给移动端 App 维护本地配置库、给运营出亿行级日志的月度报表、每周把一份几十列的清洗结果交给算法组。新人最容易犯的错,是找到一个"最好的数据库"然后全线押注——三类活的责任书完全不同,任何单一工具都会在两类活上别扭。选型第一课:先分清负载,再谈工具。本节就给你这张"负载到工具"的对照地图。
四个工具各自站在哪
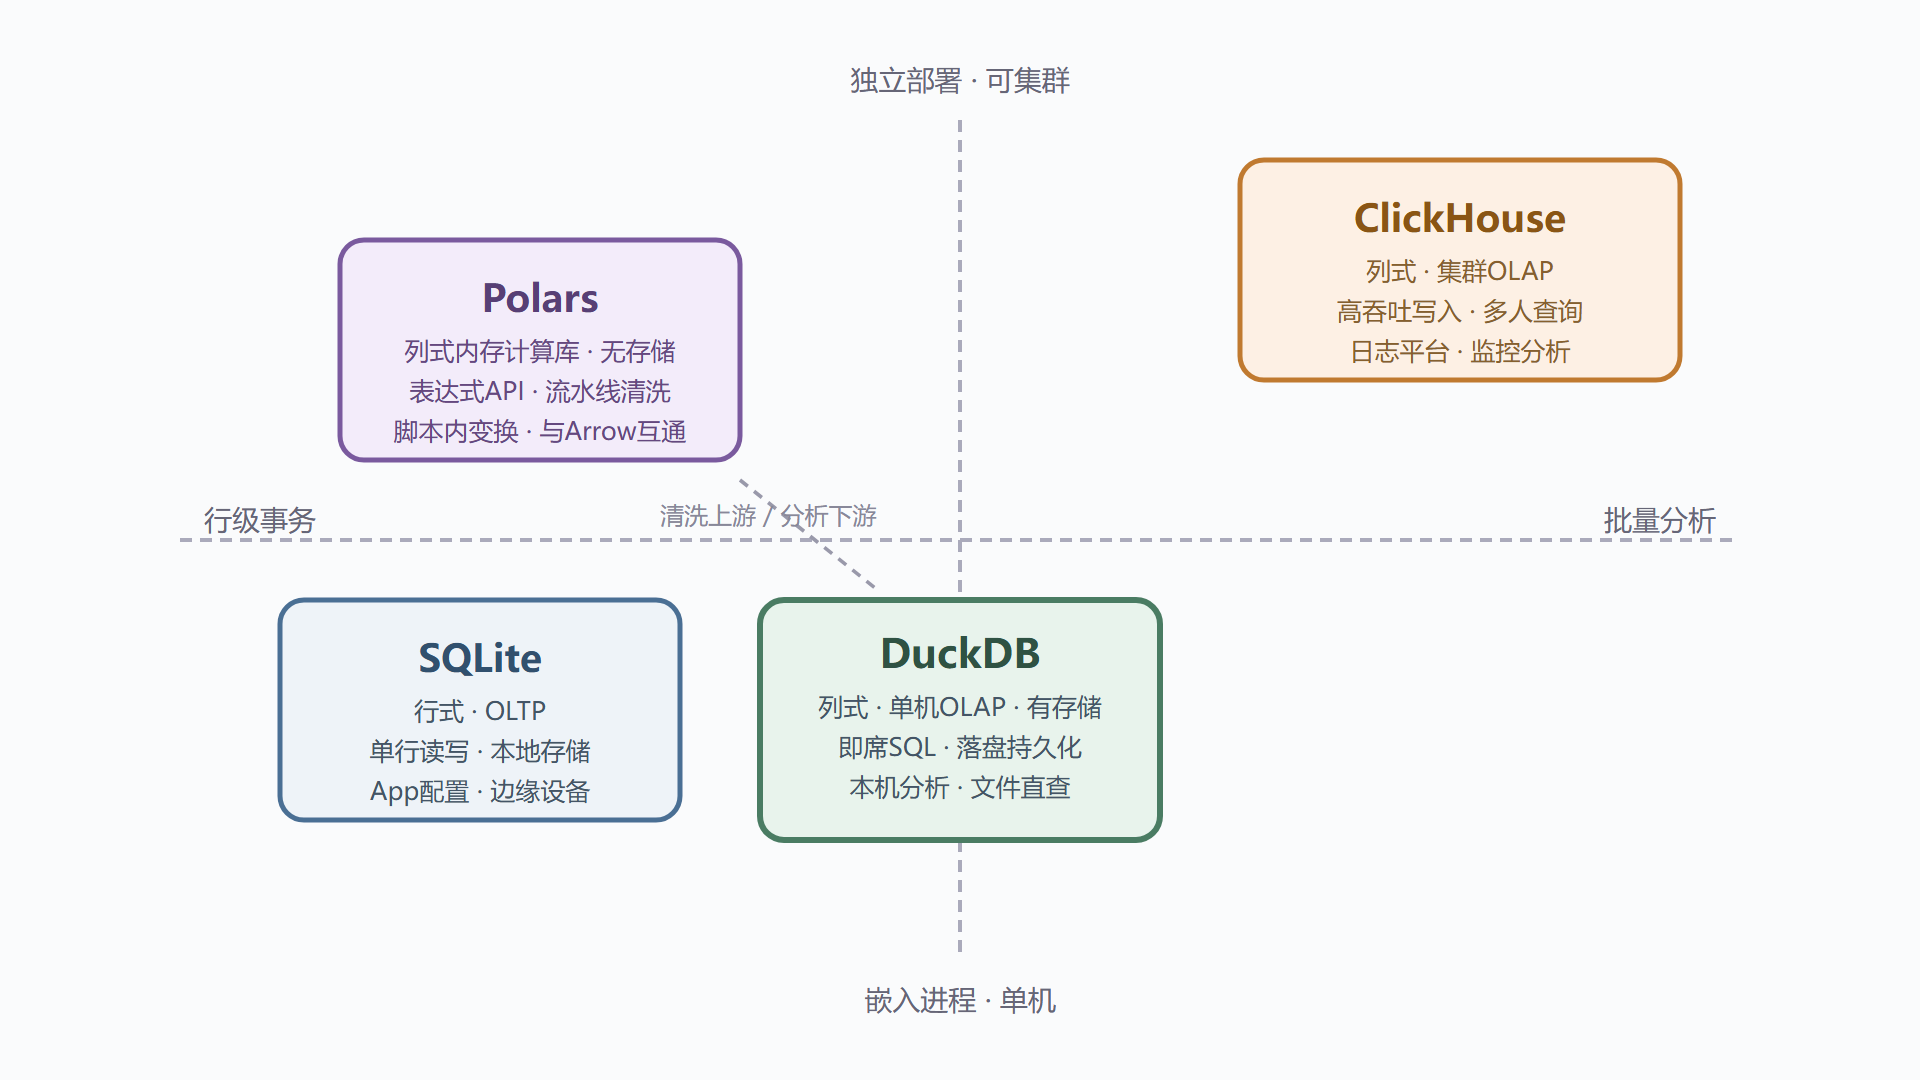
把四个工具放进两张坐标轴:横轴是部署形态(从进程内嵌到独立集群),纵轴是负载类型(从行级事务到批量分析)。SQLite 在"嵌入式 + 事务"的角落,ClickHouse 在"集群 + 分析"的角落,DuckDB 与 Polars 同处"单机 + 分析"的象限——区别在于前者是完整数据库(有存储、有事务、有 SQL 优化器),后者是无存储的计算库(数据仍在文件里,内存中变换)。这个差异决定了它们是互补关系:Polars 清洗,DuckDB 做库内分析和持久化,常常是流水线的上下两段。坐标轴还有第三个隐含维度——数据归谁管:SQLite 与 DuckDB 自带存储,ClickHouse 管集群存储,Polars 什么都不管、只管算。把"存储责任"这个维度挑明,四个工具的位置就从"记出来的"变成"推出来的"。
图1-2 四工具选型定位矩阵
逐维对照表
| 维度 | DuckDB | SQLite | ClickHouse | Polars |
|---|---|---|---|---|
| 形态 | 进程内数据库 | 进程内数据库 | 独立服务,可集群 | 进程内计算库 |
| 存储模型 | 列式,单文件自有格式 | 行式,单文件 | 列式,分布式表 | 无自有存储,吃 DataFrame 与文件 |
| 执行模型 | 向量化 + 多核并行 | 逐行迭代(B树) | 向量化 + 分布式执行 | 惰性表达式图 + 多核 |
| 甜点区 | 单机千万到十亿行级分析 | 高频小事务、单行点查 | 持续写入的海量日志分析 | 中大规模数据的内存内清洗 |
| 接口风格 | SQL | SQL | SQL(强方言) | 表达式 API |
| 写入特征 | 批量为主,事务可用 | 高频小事务见长 | 持续高吞吐追加 | 不负责持久化 |
表里最值得盯住的两行是"执行模型"和"写入特征"。执行模型决定了它们对硬件的用法:向量化引擎按列批量处理、吃满多核,逐行迭代的 B 树引擎则围绕随机读写优化。写入特征决定了运维姿态:SQLite 和 DuckDB 都能"一个文件走天下",但前者为频繁小修改而生,后者更希望你批量写入。
三个场景走一遍
场景一:App 的本地收藏夹。 用户频繁增删单条记录,数据几百行到几万行。这是教科书级的 SQLite 场景——DuckDB 能做,但它的强项(扫描聚合)完全用不上,频繁小事务反而暴露短板。结论:SQLite。
场景二:全站的接口访问日志月报。 日志持续写入,量到每天上亿条,多个团队随时来查询。有专人运维、有持续写入需求,ClickHouse 的集群化和高吞吐写入是正解。结论:ClickHouse;但如果只是一次性的历史归档分析、跑在一台大内存机器上,DuckDB 直查 Parquet 归档文件反而更省事。
场景三:主线案例本身。 一份交易明细 CSV,当天要结论,笔记本上跑。装服务太重,逐行脚本太慢,Pandas 全量读进内存又吃紧。DuckDB 直查文件、按列读取、用完即走——每个要求都踩在它的甜点区上。结论:DuckDB,这就是全书选择它的原因。
顺带补一个常被漏掉的场景四:数据本来就小,转换逻辑本来就熟。 几万行的清洗加透视,团队里人手一份现成的 Pandas 脚本,跑完只要两秒。这时候换 DuckDB 属于"为了架构洁癖引入变更"——Pandas 在它的舒适区里没有任何问题,第2章讲过的替换扫描还让两者随时可以互换。选型成熟的标志不是"新工具全面替代旧工具",而是知道替换的成本花在哪一步才回本:数据量过内存线、或查询复杂到 Pandas 写法开始绕弯时,才是迁移动作的正确触发点。
决策口诀可以压成三问:**数据活在哪里(进程内还是集群)?负载是事务还是分析?要不要数据库替你管存储?**三问之后,答案基本唯一。
它们其实是队友
真实项目里四个工具经常同框。DuckDB 甚至可以直接把 SQLite 文件挂成一个可查询的库——事务库里的数据,用 SQL 挪到分析侧做校验和报表,中间不需要导出脚本:
-- 把一个 SQLite 事务库挂载进 DuckDB 会话(需要 sqlite 扩展,会自动加载) ATTACH 'app_data.db' AS app (TYPE sqlite); -- 直接对挂载库里的表做分析查询 SELECT status, count(*) AS 笔数 FROM app.orders GROUP BY status;
类似的桥也通向另一侧:查询结果可以零拷贝地交给 Pandas 或 Arrow,被 Polars 清洗后的数据也能原地交给 DuckDB 做聚合(第5章会展开这条数据通道)。所以选型问题的终局答案常常不是一个名字,而是一段分工:事务归 SQLite,清洗归 Polars,单机分析归 DuckDB,规模化持续分析归 ClickHouse。
分工还有一个时间维度:同一份数据在不同阶段换工具是常态,不是架构债。原始接入期它是 CSV,用 DuckDB 直查;进入反复分析期它变 Parquet 或库表,工具随频次升级;规模化之后它上集群,DuckDB 退守成边缘侧的最后一公里。写选型文档时把"数据生命周期各阶段用什么"画成一条线,比画一张静态的架构图诚实得多——工具选型从来不是婚姻,是接力。
如果你想亲手验证:公平对比怎么做
口诀之外,有人总想跑分见真章——可以,但对比实验有自己的纪律,否则测出来的只是自己的偏好。三条纪律。数据要真实:随机生成的整型数据会放大哈希聚合的优势、掩盖字符串处理的差距,用你业务里真实的脏数据测。查询要有代表性:挑三条真实工作里最常跑的查询形态(一条重过滤、一条重聚合、一条重连接),别用官网示例——示例往往恰好落在某家的甜点区。计时要分冷热:第一遍是冷缓存,第二遍起是热缓存,两个数字都有意义但不可混用;多跑几遍取中位数(第7.1节的方法论在这里提前用上)。测完记住对比的目的不是选出"冠军"——是确认候选工具在你的查询形态下都没有硬伤,然后把最终裁决交给上面那三问。还有一个容易忽略的对照维度:除了快慢,把出错方式也算进对比——脏数据进来谁报错清晰、谁静默吞下,长期用起来这比峰值速度更影响心情。
本节要点回顾
- 选型看取舍不看排名:部署形态、负载类型、存储责任三问定工具,"最快"是场景属性不是工具属性。
- DuckDB 与 Polars 同象限不同物种:一个有存储有事务,一个只管内存中的变换,常做上下游。
- 三问口诀:数据活在哪里、事务还是分析、谁管存储——三问之后答案基本唯一。
- 队友剧本:挂载 SQLite 直查、与 Arrow 零拷贝交换,工具间是流水线分工而非零和竞争。