1.2 演进简史:从研究原型到1.0
1.2 演进简史:从研究原型到1.0
本节摘要:DuckDB 诞生于荷兰 CWI 研究所的数据库课题组,从研究原型到宣告格式稳定的 1.0 版本走了约六年。本节按时间线梳理它的关键节点,解释 1.0"存储格式稳定承诺"对你选型的实际意义,并给出版本升级的实操守则。
故事从一间研究所说起
上一节拆完"嵌入式分析型"这组行话,本节把时间拨回它被造出来之前。欧洲有一间老牌的数据库研究机构——位于阿姆斯特丹的 CWI 研究所,列式存储领域的许多奠基性工作都和它有关,此前的 MonetDB 系统同样出自这里。两位研究者在这个传统里提出的问题是:SQLite 证明了"嵌入式事务数据库"可以无处不在,那为什么"嵌入式分析数据库"没有对应物?分析师处理几百万行的文件,凭什么要在"装一套数据库服务"和"忍受脚本语言逐行循环"之间二选一?
这个问题催生的项目就是 DuckDB。它从一开始就带着双重身份:既是面向真实用户的开源工具,也是向量化执行与自适应策略的研究载体——核心团队把工程发现写成论文回馈学界,学界的方法又很快落进工程。这种研究与工程的短反馈回路,是它性能迭代快的历史原因。
六年时间线:节点与含义
下面的时间线标出了对使用者真正要紧的节点——不是每个版本号,而是那些改变了"你能不能放心用它"的事件。
图1-1 DuckDB 演进时间线:从研究原型到稳定承诺
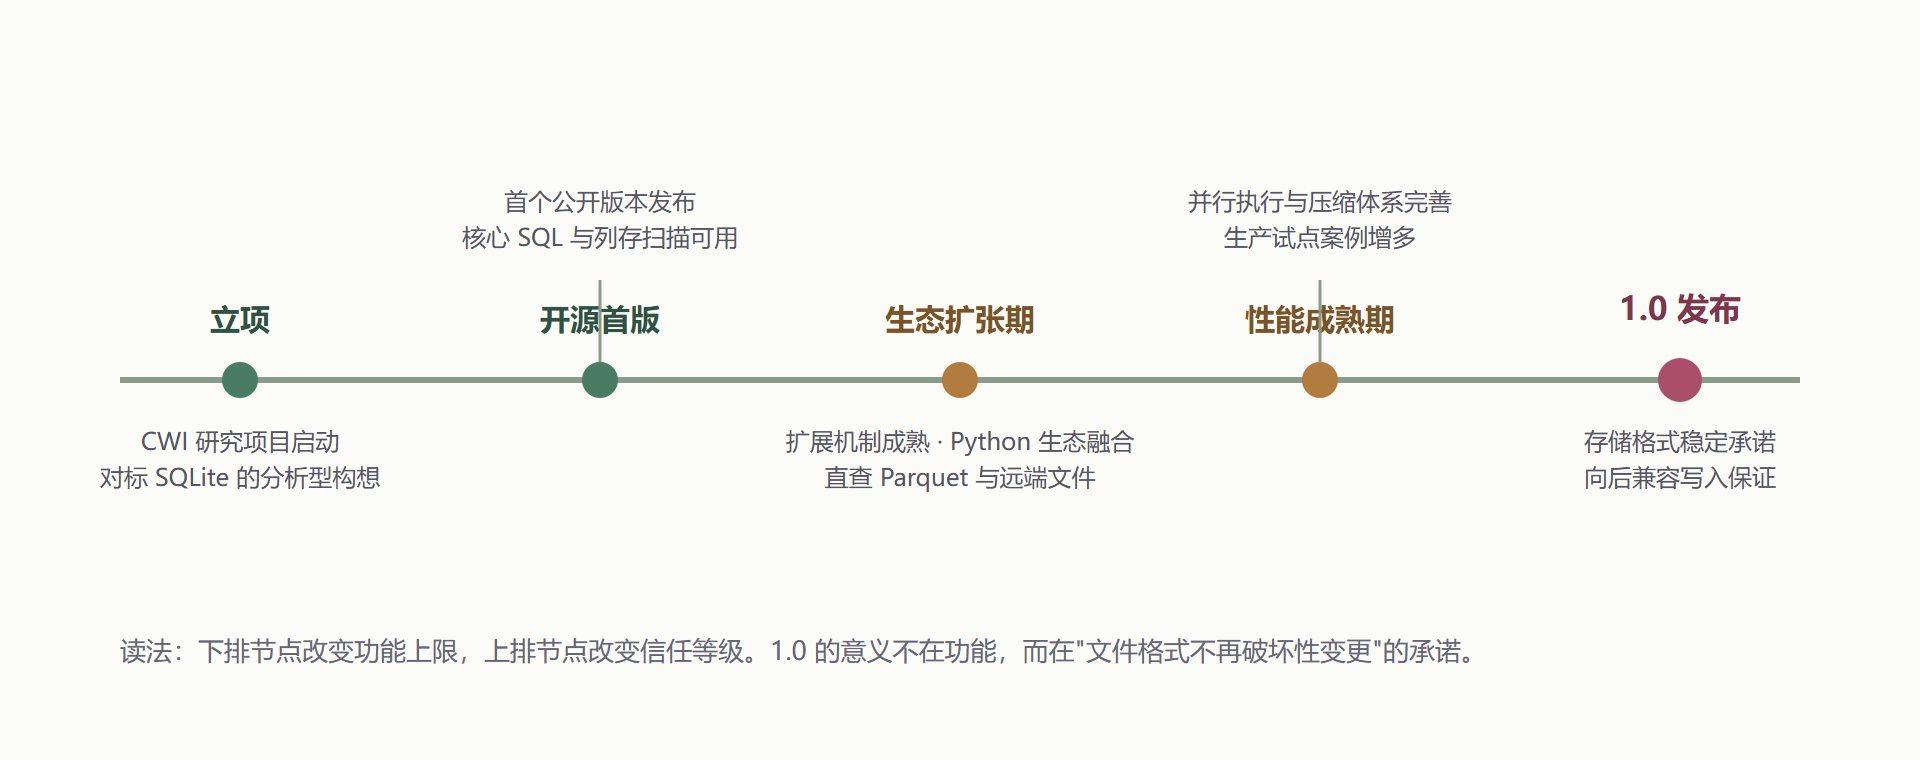
三个阶段各有各的关键词。早期验证的是可行性:核心 SQL、列存扫描、基本聚合能用;扩张期验证的是生态:扩展机制让远程文件读取、JSON 处理这类能力以插件方式接入,Python 社区开始把它当成 Pandas 的继任选项传播;成熟期验证的是工程强度:多核并行、压缩编码体系、索引机制陆续定型,生产环境的试点从"敢用在内部报表"推进到"敢用在客户项目"。
为什么是六年,而不是六年零函数
值得停下来想一个问题:核心的列存扫描原型,研究团队一两年就跑通了,那剩下那几年在磨什么?答案藏在"数据库比缓存难做"这个老命题里。并发与恢复的正确性最难:多线程写入时不丢不重、断电重启后数据完好,这些性质没法靠演示证明,只能靠持续的系统化测试堆积信心——第2.3节讲的写前日志与检查点机制,工程量远超功能本身。内存安全的全覆盖是第二座山:C++ 里一个越界就是整个进程崩溃,嵌入式形态又没有服务端那道隔离墙,于是分配器、错误路径、边界条件都要按统一规范逐处清理——这是"小团队深度优化"那个决定要付的账。第三座山最隐形:行为的可预期性。同一个查询在不同版本间的计划稳定性、报错文案的规范化、配置参数的语义冻结,每一样单看都是杂活,合起来才是"可依赖"三个字的底料。六年的大半时间花在这三座山上——理解这一点,你对"1.0 之前生产慎用"这类告诫的来龙去脉就有同理心了:不是功能不全,是正确性的证据还没攒够。
社区的形状:它是怎么长起来的
生态扩张期的另一个侧面值得单独看:DuckDB 的传播几乎不靠市场预算,靠的是"能被别的工具当成零件用"。Jupyter 社区把它 当 SQL 引擎接入笔记本;数据工程工具把它当本地转换层;可视化工具把它当嵌入式查询后端;甚至浏览器里也能跑一个精简版。每一次被集成,都是一次零成本的渠道扩张。这段历史给使用者的启示是:当你纠结某个场景合不合适时,去看看有没有主流工具已经把它内嵌为默认选项——工具作者的选型往往比论坛争论更可信,他们押上的是自己的产品体验。顺着这条线还能做一个前瞻判断:嵌入式分析的位置一旦被主流工具占住,就很难再被让出来,因为它占的不是"性能"这个可被追赶的参数,而是"形态"这个生态位——就像 SQLite 之后二十年,"进程内事务库"这个位置始终没有第二个名字。历史的读法至此闭环:一个工具从哪来,决定它现在站在哪;它被谁集成,预示它将站到哪。
1.0 到底承诺了什么
很多软件的 1.0 只是营销节点,DuckDB 的 1.0 有明确的工程含义:数据库文件的存储格式从此稳定,老版本写入的文件,新版本承诺能读;新版本对老文件的写入也保证兼容,不再出现"升级后旧库打不开"的破坏性变更。在此之前,版本升级文档里"需要先导出再导入"是常态;在此之后,文件即资产的原则第一次成立。
对选型的意义在于风险边界:1.0 之前,把 DuckDB 文件当长期存储是要小心的;1.0 之后,"单文件即备份"才真正可靠。如果你在旧资料里看到"生产慎用"的告诫,先查一下写作时间——那条告诫很可能已经过期。
-- 在你自己的环境里确认版本与库的基本情况 SELECT version() AS 当前版本; -- 查看当前连接数据库的规模信息 CALL pragma_database_size(); -- 查看某张表的物理存储细节(块数、压缩等信息按块列出) CALL pragma_storage_info('trades');
升级与支持的实操守则
版本策略上有三条朴素的守则。其一,生产环境追稳定线,不必每个版本都跟——DuckDB 的发布说明写得很细,先看变更是否踩到你在用的特性。其二,升级前做一次检查点,把预写日志收拢进主文件,升级动作就简化成"替换库文件后打开验证"。其三,重要库文件保留一份低版本可读的备份,成本只是一个文件的拷贝。三条守则共同的底色是把升级当成流程而不是动作:备份在先、验证在后、出问题有退路——数据库文件的升级不可逆风险被这三步压到接近于零。
-- 升级前的收尾动作:把写前日志合并进主文件 CHECKPOINT;
支持与社区层面,有两类资源值得知道。核心团队背后有一家专门的公司提供商业支持,企业级使用(咨询、定制、保障)可以走这条路;社区侧则有活跃的问题讨论区和公开的路线图讨论,日常问题基本都有人应答。想参与贡献的话,门槛并不神秘:文档勘误、扩展开发、性能基准复现都是被欢迎的切入点,从"用好"到"参与"的路径是连续的。
读变更说明也有一套省力法。变更条目大致分三档:行为变更(同一输入产生不同输出或报错)必读,逐条对照自己在用的查询;性能变更选读,只看与自己负载相关的算子;新功能按需读,用到再查。把"读发布说明"当成升级流程的固定工序而不是可选项,你就能避开绝大多数升级惊吓——毕竟嵌入式引擎升级只是换个包,图省事的代价是把验证责任全留给线上。
回到主线案例
主线案例的那份 CSV 与这一切有什么关系?关系在于判断:你现在知道它建立在一条"研究驱动、稳步收敛"的路线上,1.0 之后文件格式不会再翻烧饼——所以第3章把清洗结果落成 DuckDB 专有格式或 Parquet 时,你不需要为"格式将来作废"这种概率付保险费。下一节我们把镜头转向它的邻居们:同样一份分析任务,SQLite、ClickHouse、Polars 会怎么接?边界就在对比里显形。
本节要点回顾
- 出身:DuckDB 出自列式存储研究重镇 CWI,带着"让分析像 SQLite 一样随处可用"的问题意识起步。
- 三阶段:早期验证可行、中期扩张生态、后期打磨工程强度,研究与工程短反馈回路贯穿始终。
- 1.0 的实质:存储格式稳定与向后兼容承诺,使"单文件即资产"从愿望变成事实。
- 升级守则:生产追稳定线、升级前 CHECKPOINT、重要文件留低版本可读备份。