3.1 列式存储与行组结构
3.1 列式存储与行组结构
本节摘要:DuckDB 的库文件按"行组套列段"两级组织:数据按行分组成块,每组内每列各自成段连续存放,段头带统计信息。本节画出这张物理布局图,解释一次扫描如何靠它跳过无关数据,以及它对写入模式的要求。
行视角与列视角的物理学
第1章说列存让"用不上的列不读内存",本节兑现这句话的物理细节。想象磁盘上的字节布局:行式存储把第1行的所有列写在一起,接着第2行、第3行——要统计全表金额总和,磁盘臂得把每一行的全部字段都扫一遍,哪怕只需要其中一列。列式存储把同一列的所有值连续摆放——读金额列就是读一段连续字节,其他列一个字节都不碰。聚合查询的加速来自"读的量直接少了一个数量级",这是结构性红利,不依赖任何参数调优。这张图景还藏着一个容易量化的视角:宽表越宽,列存的优势越大——两百列的表只聚合三列,行式要读一百倍于列式的字节量;反过来,窄表加上"每次都全列读"的查询形态,列存的相对优势就缩水了。布局红利的大小,永远相对于你的查询形态而言。
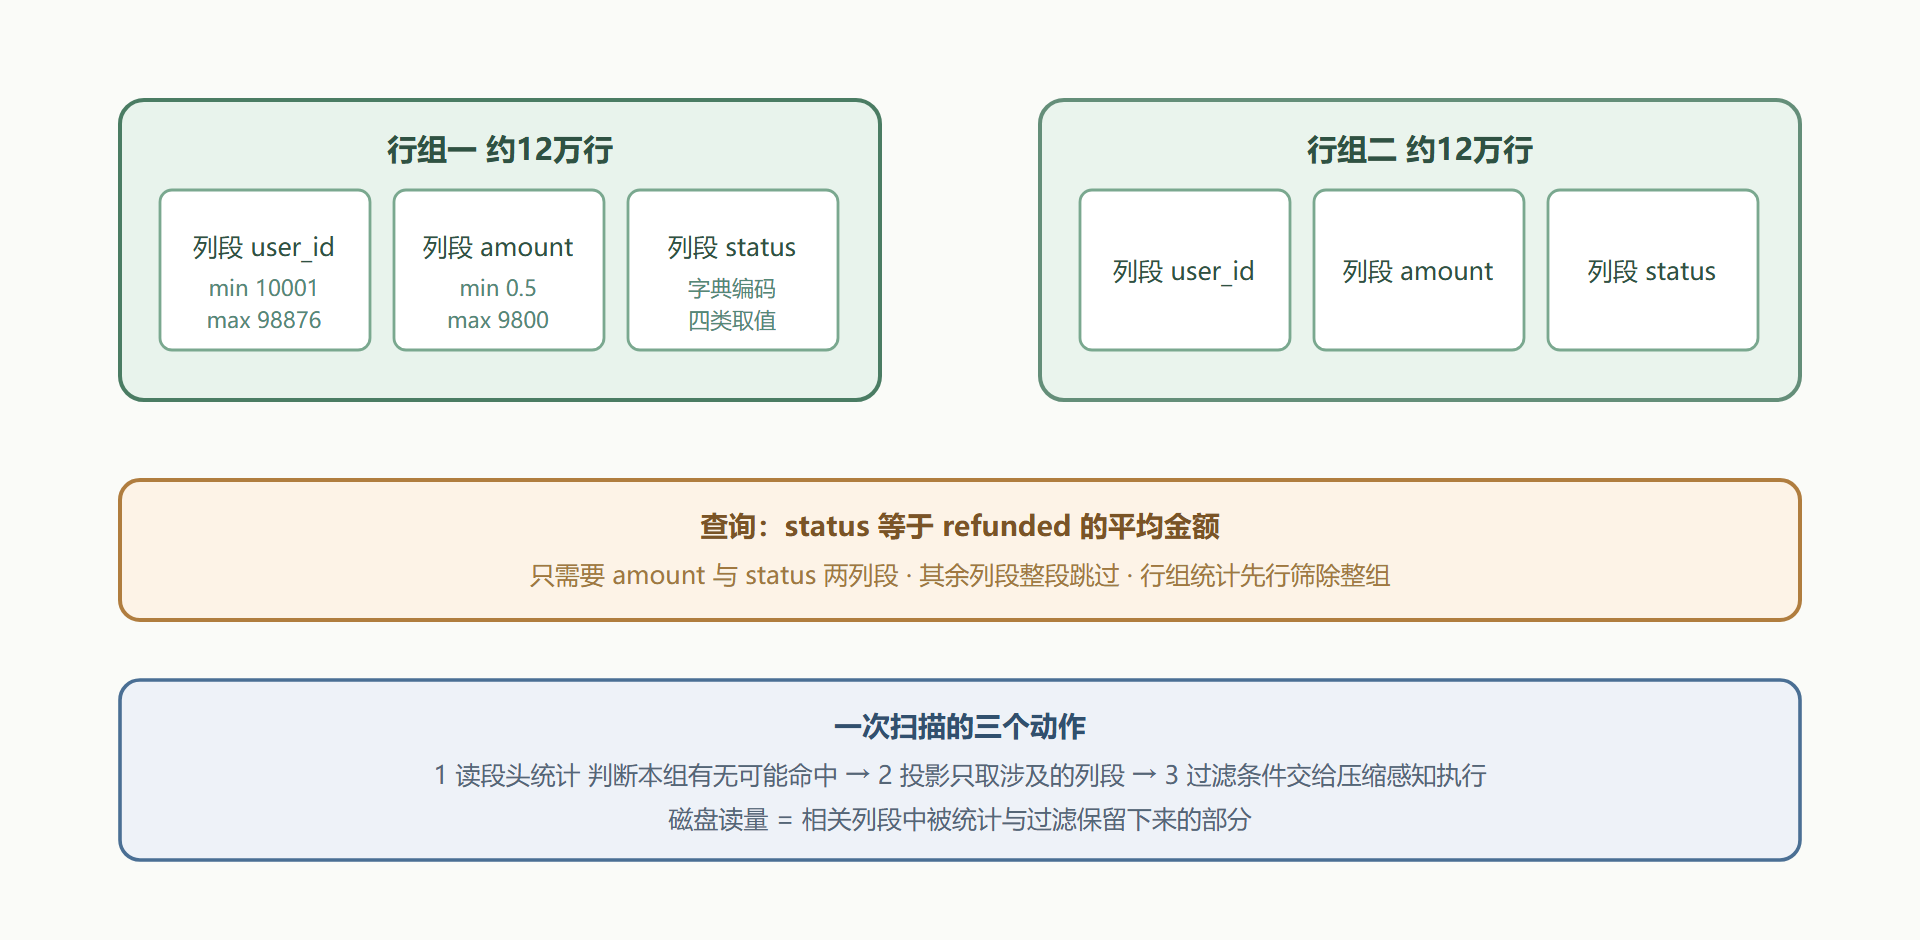
但纯列式有一个软肋:取一行要拼凑许多列段,行级点查反而慢。DuckDB 的解法不是二选一,而是分而治之:不是把整列从头到尾连成一根,而是先按行切组(行组,通常十几万行一组),组内再按列切段。这样既保留"读单列连续字节"的扫描优势,又让"取一行"只需要访问一个行组内的几个段,点查不至于是灾难。两级结构还有一层工程含义:它是"物理格式可以演进"的载体——行组是独立的物理单元,新旧行组可以并存(第3.3节的检查点更新依赖这一点),格式升级可以按组滚动进行而不是全量重写。一张布局图,既是性能的来源,也是演进能力的地基。
图3-1 行组与列段的物理布局
段头统计:扫描的地图
每个列段的头部都记录着这段数据的元信息:最小值、最大值、空值计数,以及一些编码相关信息。这些统计是扫描的地图——查询带着 amount > 5000 这样的条件进来,先看段头:这段的最大值才九百八,整段跳过,一个数据页都不用读。这就是分区剪枝的雏形(完整的索引与剪枝机制在第4.4节展开),而它不花任何额外成本,纯粹是布局设计送的。空值计数这个字段也顺带说一句:它让"这列有没有空"的判断不用读数据就能回答,空值敏感的连接与聚合在计划期就能拿到情报——统计的价值不止于范围剪枝一条。
统计还有一个容易被忽略的副产品:优化器靠它估算基数。第4章会讲,连接顺序、过滤策略这些计划决策都依赖"这一列大概有多少不同值"的估计——估计的来源就是这些段头。所以列存文件不只是数据,还随身携带了一份自我描述。
统计的第三个身份常被漏看:它自己也在被维护。每次批量写入,新行组的统计随写入同步生成;更新与删除则会让统计逐渐"说谎"——删除的行还留在段里参与 min-max 计算,最坏情况是整个行组的区间被一个早已删除的异常值撑大,剪枝力跟着衰减。这给"分析库少更新"的姿势(第2.3节)补上了存储层的理由:更新不仅留下版本链,还悄悄钝化统计的锋利度。重度更新过的表,重建一次等于给统计换新——这解释了不少人观察到的"重建后莫名变快":快的不是布局,是统计重新变准了。
写入模式与布局的约定
布局对写入有明确偏好:追加成批最合算。行组是整组填充的,批量插入能整组写满;高频小插入则会造成组内碎片,触发重整。这呼应了第2.3节的结论——分析引擎喜欢"攒一批、写一段"。如果你的上游是持续小批量到达的数据,更好的姿势是先落到外部文件,定期批量收进库。布局与排序的关系也在这条偏好里:ORDER BY 建表之所以值得,是因为它把"物理顺序"这个一次性的写入决策,兑换成了此后每一次扫描的剪枝收益——第3.1节到这里已经把"数据怎么摆"讲完了,第7.2节会把这个决策前移成建模检查单的第一行。
-- 查看一张表的物理布局:每个行组、每个列段一段记录 CALL pragma_storage_info('trades_clean'); -- 批量追加的最小单位意识:一次插入一批,而非循环单行 INSERT INTO trades_clean SELECT * FROM read_csv_auto('trades_2024q4.csv');
用存储信息命令看真实布局,你会看到每个行组每列的一行记录:压缩方式、占用块数、统计值都在。排错和容量估算时它非常有用——比如想知道"为什么这张表比原始CSV还大",往往答案就藏在某列的编码选择里,这就引出下一节。看布局记录时留意一个细节:各列段的块数差异其实是一份数据画像——文本列块多、整型列块少,差异悬殊的列就是将来压缩与裁剪的重点观察对象。
动手对比:同一条查询的两种命运
布局的价值可以一次实验验证。主线案例的全年数据,同一份内容两种存法:原始 CSV 与按时间排序后的列式表。跑同一条"统计某个月大额交易"的查询:
-- 版本一:直查 CSV(第3.4节会讲它的正确定位) SELECT count(*), sum(amount) FROM read_csv_auto('trades_full.csv') WHERE trade_time >= TIMESTAMP '2024-06-01' AND trade_time < TIMESTAMP '2024-07-01' AND amount > 5000; -- 版本二:查列式表(数据已按 trade_time 排序落库) SELECT count(*), sum(amount) FROM trades_clean WHERE trade_time >= TIMESTAMP '2024-06-01' AND trade_time < TIMESTAMP '2024-07-01' AND amount > 5000;
实测参考:CSV 版要解析全量文本、逐行判断条件,秒级到十秒级;列式表版本命中剪枝——六月之外的行组在段头统计就被跳过,实际读取的只有覆盖六月的几个行组的相关列段,毫秒级到几十毫秒。两个数量级的差距里没有任何调参,全部来自布局与排序。这个实验还埋了一条伏笔:如果列式表不排序、按原始乱序导入,剪枝的区间判断就会失灵,查询退回到"读很多行组"的平庸水平——数据摆放的细节(第7.2节的主题)从这一刻开始值得你在意。
行组大小:隐形的旋钮
行组默认十几万行,这个数字是平衡点而非玄学:组太大,点查与更新的局部性变差,块缓存也难以细粒度调度;组太小,段头统计与元数据的占比上升,剪枝一次跳过的量太少。多数人一辈子不用碰它,但两种场合值得知道它的存在。超宽表(几百列):每组列段数量爆炸,适当增大行组能摊薄元数据开销。建表参数意识:用建表语句落 Parquet 时可以显式指定行组大小——给下游的剪枝密集型查询留小一点的组,给纯扫描型负载留大一点的组。理解旋钮的存在比会拧它更重要:遇到"剪枝总跳不掉垃圾数据"的怪现象时,行组粒度是排查清单上该有的一行。
本节要点回顾
- 两级布局:行组管点查的局部性,列段管扫描的连续性,二者相加而非二选一。
- 段头统计是免费的索引:min、max、空值计数支撑整段跳过,也为优化器提供基数估计。
- 写入偏好批量追加:整组填充最合算,高频小插入制造碎片。
- 布局自描述:物理信息命令能看到每个列段的编码与统计,是容量排错的第一现场。