3.2 压缩编码与查询速度
3.2 压缩编码与查询速度
本节摘要:列存之后,同一列的数据类型一致、取值相近,压缩空间巨大;更妙的是,字典、游程这类编码让查询可以直接在压缩数据上进行——扫描读的位数变少,查询自然更快。本节过一遍主流编码的适用场景,并示范怎么给自己的表选编码。
压缩为什么是性能特性
直觉里压缩是存储问题:文件小点、盘费少点。列式引擎把这件事的收益翻了一倍,原因在于一条硬件事实:CPU 算得比内存供得快。查询的瓶颈常在数据从内存流进 CPU 的带宽上。如果数据以压缩形态参与计算,同样的缓存行装进的有效值多几倍,等于带宽凭空翻倍。所以列存引擎的目标不是"压得最狠",而是"保持可计算的同时尽量小"——能直接在压缩数据上做过滤和聚合的编码,比压缩率更高的通用算法更受欢迎。这个取舍可以用一句话记住:省下的是字节,花掉的是指令——专用编码把"解压"这道工序换成了几条廉价的比较指令,只要换算得过来就是净赚,而列式布局正是让换算恒成立的那只手。
通用压缩算法(例如 gzip 那一族)必须解压才能计算,省了盘、费了 CPU,对查询未必划算。列式引擎的思路是按列的特性挑专用编码,让"压缩态可计算"成为常态。这也是列存与压缩天然是搭档的原因:同一列里类型一致、语义相近的值排在一起,本身就是编码器最喜欢的输入——行式布局下每行杂着各种类型,专用编码无从下手。所以第3.1节的布局决定其实一直在给本节发福利:选了列存,压缩的好牌就自动到手里了。
主流编码与它们的胃口
| 编码 | 吃哪种数据 | 压缩原理 | 查询友好度 |
|---|---|---|---|
| 字典编码 | 低基数文本列,如状态、类别 | 唯一值编号,主体存编号 | 高:过滤变整数比较 |
| 游程编码 | 排过序或大量连续重复的列 | 值加连续长度成对存储 | 高:可整段跳过 |
| 位打包 | 小范围整数,如年份、小时 | 去掉高位零,按实际位宽存 | 中高:定长便于向量化 |
| 常量折叠 | 整段只有一个值的列 | 只存一个值和计数 | 极高:整列免读 |
| 字符串压缩 | 自由文本列 | 识别常见子串 | 中:多数场景需解码 |
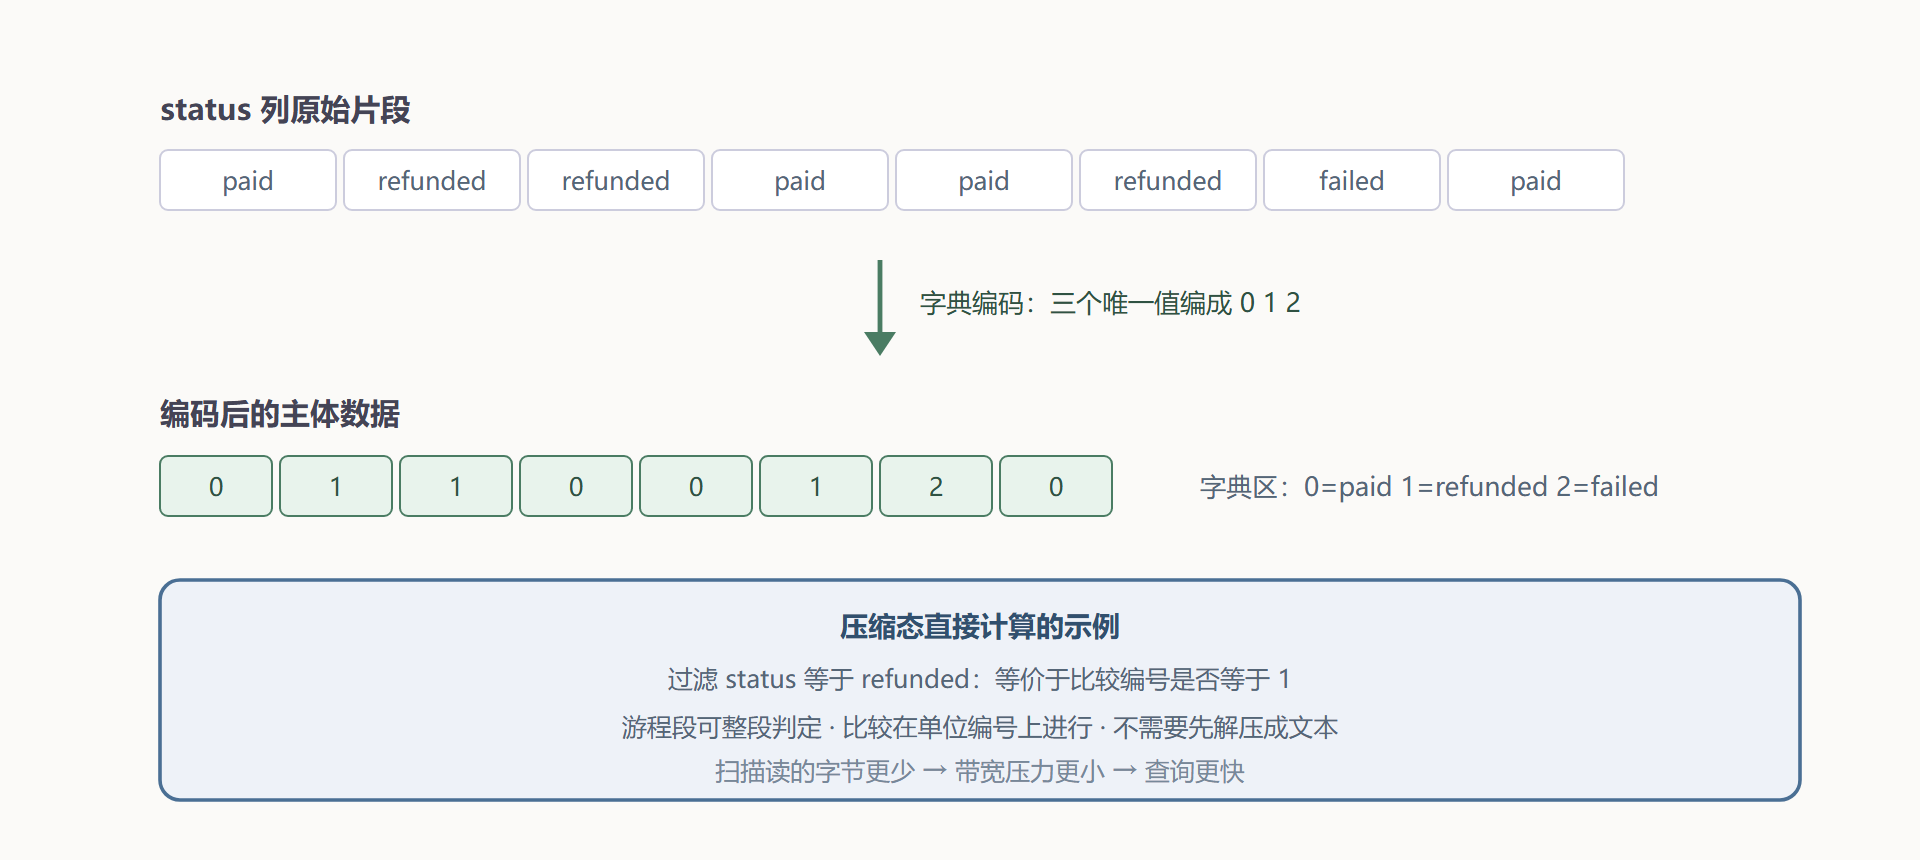
对照主线案例的列可以实际感受一遍:status 列只有寥寥几个取值,字典编码后主体数据变成单字节编号,压掉九成以上;amount 列是宽范围小数,压缩有限,但这不影响大局——它只占总字节的一小部分;trade_time 列若按时间顺序写入,相近值连片,游程或位打包都能吃下。一张表里各列编码各得其所,整文件自然瘦下来。这张逐列清单还能反过来当数据剖析工具用:哪些列压得好、哪些列压不动,一眼扫过就知道数据的"形状"——低基数列占比高说明分类信息密集,宽范围数值多说明度量信息密集,编码表读着读着就成了理解数据集的透镜。
图3-2 一列数据的编码效果对照
亲手看看自己表的编码
布局信息命令会把每列每段采用的压缩方式列出来。观察它比背编码表更有教育意义——你能看到引擎替你做的选择:
-- 每列段一行:压缩方式与占用一目了然 CALL pragma_storage_info('trades_clean');
有两个影响编码选择的使用习惯值得养成。其一,让相似的值连片:数据按某个低基数列预排序后再写入,游程编码的命中率高得多,整表体积常能再降一截。其二,低基数列用类型别撑大:状态、类别这类列,值域就那么几个,存储侧自然会走字典;但如果你把类别存成了自由文本还到处是隐藏空格,字典就失效了。清洗的价值不只在正确性,也在压缩友好度。
为什么我的压缩率和别人不一样
同一张表,你压出二比一、同事压出五比一,这类困惑的答案几乎总在三个变量里。排序与否:时间列有序写入游程编码连片命中,乱序写入则退化为位打包,差距可达数倍。值域干净度:隐藏空格、大小写变体让字典的唯一值翻倍,字典编码的主体数据从单字节涨回多字节。列构成:文本多的表天然难压,数值时间序列的表天然好压——别拿不同结构的表互相比压缩率。所以"压缩率"不是引擎的属性,是数据形态与布局共同的结果;想优化它,回到本节前半的两个习惯,而不是找隐藏参数。
主线案例的第一次"搬家"
趁热打铁,把全年 CSV 收进列式库文件,这是主线案例正式的"搬家"仪式:
-- 建库后一次性收编:扫描、清洗、落列存一气呵成 CREATE TABLE trades_clean AS SELECT * FROM read_csv_auto('trades_full.csv'); -- 搬家对账:行数必须守恒 SELECT (SELECT count(*) FROM trades_clean) AS 入库行数, (SELECT count(*) FROM read_csv_auto('trades_full.csv')) AS 原始行数;
搬家后的对比很直观:库文件体积明显小于原 CSV,按小时聚合的查询直接快了数倍。更重要的收益在第4章兑现——列式表让执行计划拥有统计信息,优化器从"盲跑"变成"看路走"。数据落定之后,还剩一个悬而未决的问题:写入靠什么保证安全?这就是持久化的话题。搬家的对账除了行数,还可以顺手比一列的校验和(金额列求和保留四位小数)——行数守恒只能证明"行都进来了",数值守恒才能证明"值都没变",多花的那几秒买的是整条后续流程的底气。
编码退化:一个真实的体检案例
编码不是一劳永逸的,数据变脏会让它悄悄退化。主线案例里就出过一单:status 列原本四个干净取值、字典编码压得很好;某次上游更新后混进了 Refunded (大写加尾随空格)这类变体,字典的唯一值从四个涨到十几个,编码效率下滑还只是小账——大账是过滤语义变了:WHERE status = 'refunded' 静默漏掉了变体行。体检方法就是本节的布局命令加一条分组核对:
-- 编码体检的孪生兄弟:值域体检 SELECT status, count(*) FROM trades_clean GROUP BY status ORDER BY 2 DESC;
分组结果里出现"长得几乎一样"的取值,就是退化信号——先清洗(统一大小写、去空格),再重建表让编码重算。这个案例的教训和第5.2节类型雷区是同一个:清洗不光是正确性工程,也是存储工程。值域干净、类型最短、低基数列成片,这三件事让编码有条件把表的体积压到位。
交换与归档:通用压缩的正当场景
本节贬了通用压缩一笔,需要把场景补全:它有专属领地。数据出口——把查询结果落成 Parquet 给别的系统消费时,选 zstd 这类带通用压缩的选项,传输与归档的收益大于解码成本,而且 Parquet 按列组织,读端照样享受列裁剪。长期归档——季度存档的文件一年不被读几次,压缩率优先、解码速度无所谓。传输通道——网络带宽比解码 CPU 贵的场合。共同点是这些场景里数据都处在"静止"状态;一旦进入"反复查询"的活跃期,就该交给引擎自己的编码体系。一句话分工:活跃数据用引擎编码,静止数据用通用压缩,Parquet 是两者之间的中转站。
本节要点回顾
- 压缩是性能特性:瓶颈常在内存到 CPU 的带宽,压缩态可计算等于带宽翻倍。
- 编码按列挑:低基数走字典、连片重复走游程、小整数走位打包,通用压缩只在归档场景用。
- 两个好习惯:相似值连片、类别列保持干净,都是给编码创造条件。
- 搬家有仪式:CSV 收编进列式表后体积与速度双赢,行数对账不可省。