4.1 查询流水线
4.1 查询流水线
本节摘要:一条 SQL 要经过解析、绑定、逻辑计划、优化、物理执行五站。本节画出这条流水线,教你按报错出现的站点给错误分类——会定位错误发生在哪一站,排错就少了一半盲目。
报错也分站点
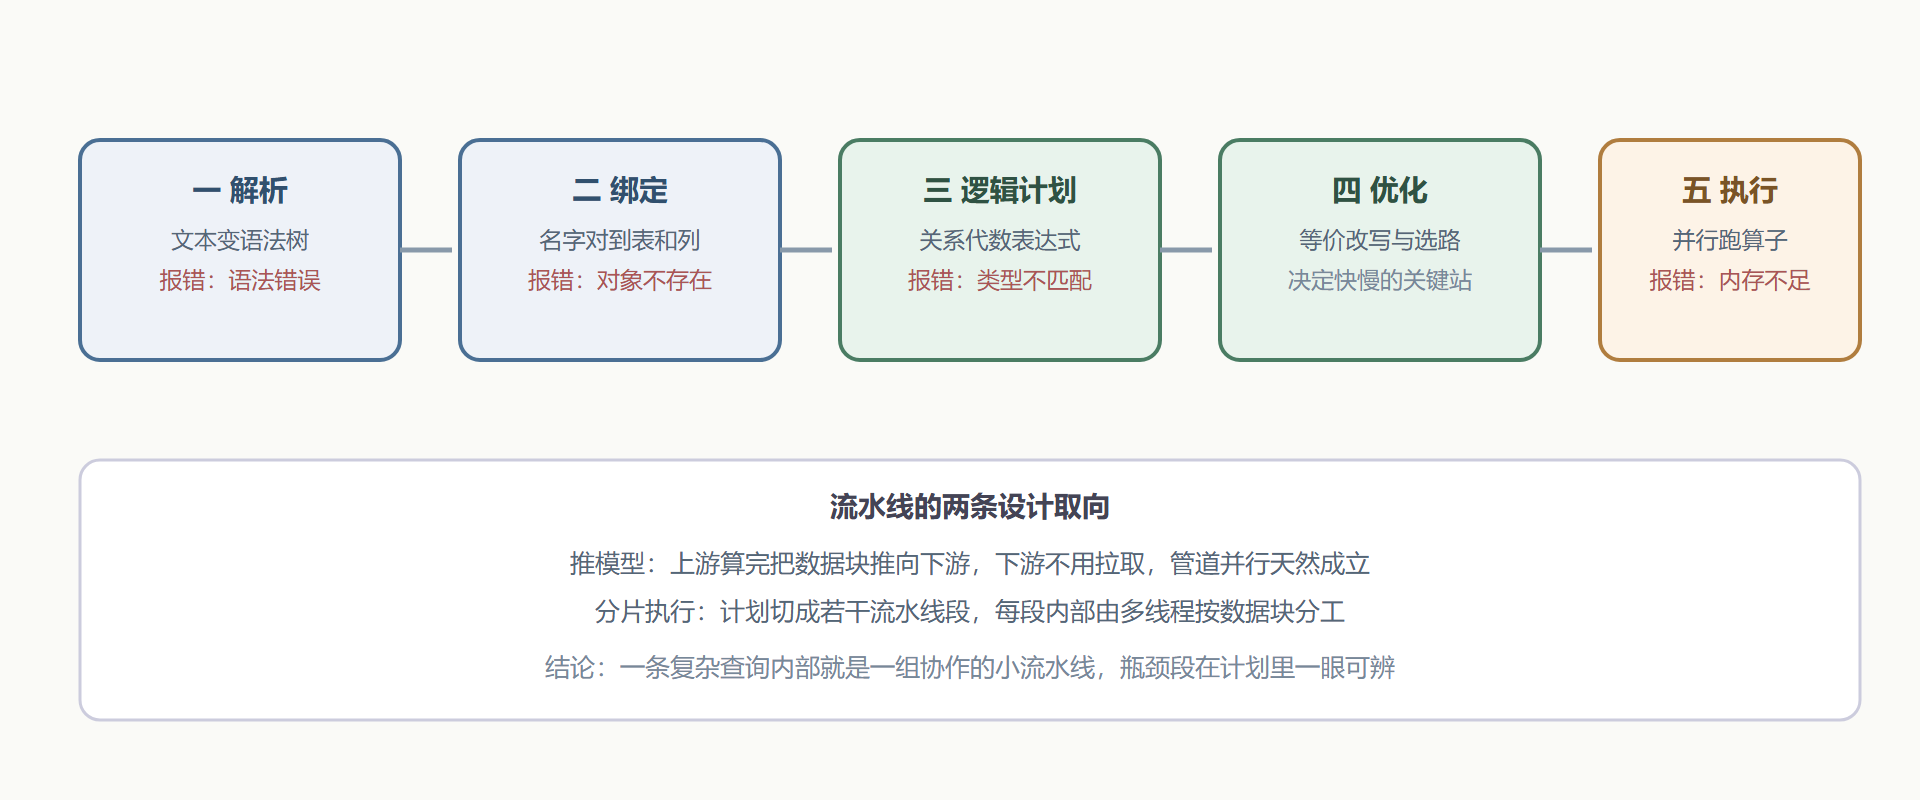
新手看 SQL 报错只有一种感觉:"坏了"。有流水线概念之后,报错可以被归位:语法错误发生在解析站,多是括号、逗号这类笔误;列不存在发生在绑定站,名字拼错或列在别的表里;类型不匹配发生在计划站,字符串和数字直接比较会被拦下;内存不足发生在执行站,算子跑起来才发现撑不住。报错文本指到哪一站,排查范围就缩到哪一站——这是本节最实用的一条产出。站点归属还能告诉你"改哪里":解析与绑定的错改 SQL 文本,计划站的错改类型声明或改写谓词,执行站的错改资源配置或查询形态——四类错对应四种修理台,别拿错工具。
图4-1 SQL 的五段旅程
五站各自在做什么
解析站把文本变成语法树,只认结构不认含义——SELCT 少个 U 在这里就被拦下。绑定站拿着语法树去目录里对名字:表存在吗、列属于哪张表、函数签名对得上吗——语义层面的合法性在这里裁决。逻辑计划站把绑定的树翻译成关系代数:扫描、过滤、连接、聚合成为一颗算子树,此时它只表达"做什么",不表达"怎么做"。优化站在这棵树上做两件事:用等价规则改写(过滤下推、列裁剪、子查询展开),再用统计信息做代价决策(连接顺序、连接算法)。执行站把优化后的物理计划切成流水线段,交给多线程跑。五站串起来其实是一条信息不断具体化的流水线:文本获得结构,结构获得含义,含义获得形状,形状获得速度——每一站都在为下一站积累"可决策的信息"。
五站里只有优化站和执行站决定快慢,前三站只决定对错。这个分工给排错提供了清晰的路标:对不对的问题往前三站找,快不快的问题往后两站找。路标还有个进阶用法:报错站点能反推查询的书写质量问题。如果一张报表的 SQL 频繁报绑定站错误(列不存在),多半是表结构变过而 SQL 在裸写字段名——视图或宏把字段依赖收口,这类报错自然绝迹;如果频繁报计划站类型错,说明上游类型不稳定,该补的是显式 CAST 而不是逐次改 WHERE。报错不只是故障信号,还是架构缺陷的探测器——这是"按站分类"这个习惯的复利。
推模型与分片:执行的两个关键词
物理执行有两个设计点值得专门讲。第一是推模型:数据从上游算子"推"向下游,而不是下游反复来拉。推的好处是管道并行天然成立——上游算完一块就往下送,各算子像流水线工位一样同时开工。第二是分片执行:一个复杂查询会被切成若干流水线段(比如"扫描加过滤"是一段,"聚合"是另一段),段与段之间是阻塞或流水的关系,段内部由线程池按数据块分工——这正是第2.1节 morsel 并行在计划层的落点。两个设计点合成一张执行图景:查询内部是一条多工位流水线,工位之间推着传送带,每个工位内部又是多线程小车间——第2章的并行与本章的流水线,至此拼成完整的一张图。
-- 用 EXPLAIN 看切好的流水线段与算子树(下一节细读输出) EXPLAIN SELECT status, count(*) FROM trades_clean WHERE trade_time >= TIMESTAMP '2024-06-01' GROUP BY status;
看一眼这份计划,你会看到优化器已经把时间过滤推到了扫描算子上、把用不到的列裁掉了——等价改写不是玄学,是看得见的计划变形。怎么从计划输出里读出瓶颈、估算是否失真,是下一节的主题。
结果的去向:一次性还是流式
旅程的终点也值得看一眼:算出来的结果怎么交给你?两种模式对应两种场景。全量模式把结果攒齐了一次性交付,适合中等结果集——拿到手里随便翻,代价是内存要装得下整个结果。流式模式按批产出、取一批算一批,适合超大结果或"只看前几行"的场景——翻到第几行算到第几行,内存占用恒定。日常的 LIMIT 预览、导出大表、往下游管道喂数据,都是流式的舞台;交互分析的最终结果通常不大,全量更顺手。理解这个分岔还有一个排错价值:一条"只取前十行"的查询如果还是很慢,说明瓶颈在产出前的算子段(排序聚合),引擎无法只算前十行就绕过它们——这不是引擎傻,是语义决定了某些算子必须见完全量。知道哪些子句能截断流水线、哪些不能,对"为什么 LIMIT 了还是慢"这类困惑就是一句话的事。
跟一条报错走三站
站点概念最好用真实报错练一遍。以下是主线案例里真实发生过的三条,盖住解释先自己判断是哪一站拦的:
-- 第一条 SELECT statu, count(*) FROM trades_clean GROUP BY statu; -- Binder Error: Column "statu" does not exist —— 绑定站:名字对不上目录 -- 第二条 SELECT * FROM trades_clean WHERE amount > '500'; -- Conversion Error: Could not convert string '500' to DECIMAL —— 计划站:类型裁决不过 -- 第三条 SELECT status FROM trades_clean WHERE trade_time >= DATE '2024-06-01' AND trade_time <= DATE '2024-06-31'; -- Conversion Error: date out of range —— 计划站:字面量本身不合法(六月只有三十天)
三条里两条出在计划站而非执行站——这提醒我们:大多数报错发生在查询跑起来之前。字段名打错、类型写歪、字面量越界,这些"编译期"问题占了日常报错的大头;真正到执行站才炸的,主要是资源类问题(内存、溢出)。所以排错的节奏应该是:先读站点、再读正文、最后才动手改——三步里前两步不花时间,却能把"乱试一通"变成"定点修复"。
一条复杂查询的旅程实录
单表聚合的旅程太短,看不清全貌。换成主线案例里那条会诊过的业务查询(按周统计大额退款里 VIP 用户的走势):它有两张表、一个连接、两个过滤条件、一个聚合。旅程从文本进站开始:解析站把它变成语法树;绑定站把 trades_clean、users 对到目录里的实体,把 vip_level 归属到用户表;逻辑计划站搭出算子树——两个扫描、一个连接、一个聚合、一个排序;优化站开始动手术——时间与金额的过滤条件被下推到交易表扫描内部,用户表只保留两个列(连接键与等级),连接顺序按估算行数定为"小的用户表做构建侧";执行站把计划切成几段流水线:扫描过滤是一段,连接是一段,聚合与排序是一段,段内 morsel 并行开跑。
把这段旅程对着第4.5节的会诊过程回看会有新收获:会诊第二步"过滤前置"改写之所以有效,正是因为它在源头上给优化站提供了更聪明的下推素材;第三步"重排布局"则改变了执行站扫描段的跳过量。一条查询的每个站点,都对应一种优化手段——这个对应关系是本章五节知识的总纲。
本节要点回顾
- 报错分站点:语法在解析、名字在绑定、类型在计划、资源在执行,站点即排查范围。
- 前三站管对错,后两站管快慢:性能问题只在优化与执行两站解决。
- 推模型让管道并行成立:数据块上游推下游,算子同工位协作。
- 计划被切成流水线段:段内多线程按块分工,EXPLAIN 能看到切分结果。