4.2 优化器与执行计划
4.2 优化器与执行计划
本节摘要:优化器的工作是把"结果正确的计划"换成"速度更好的等价计划":规则改写负责确定性的收益,代价估算负责两难时的选路。本节讲清这两类决策,并给出读懂 EXPLAIN 输出的系统方法——这是性能排错的核心技能。
同一条SQL,无数个计划
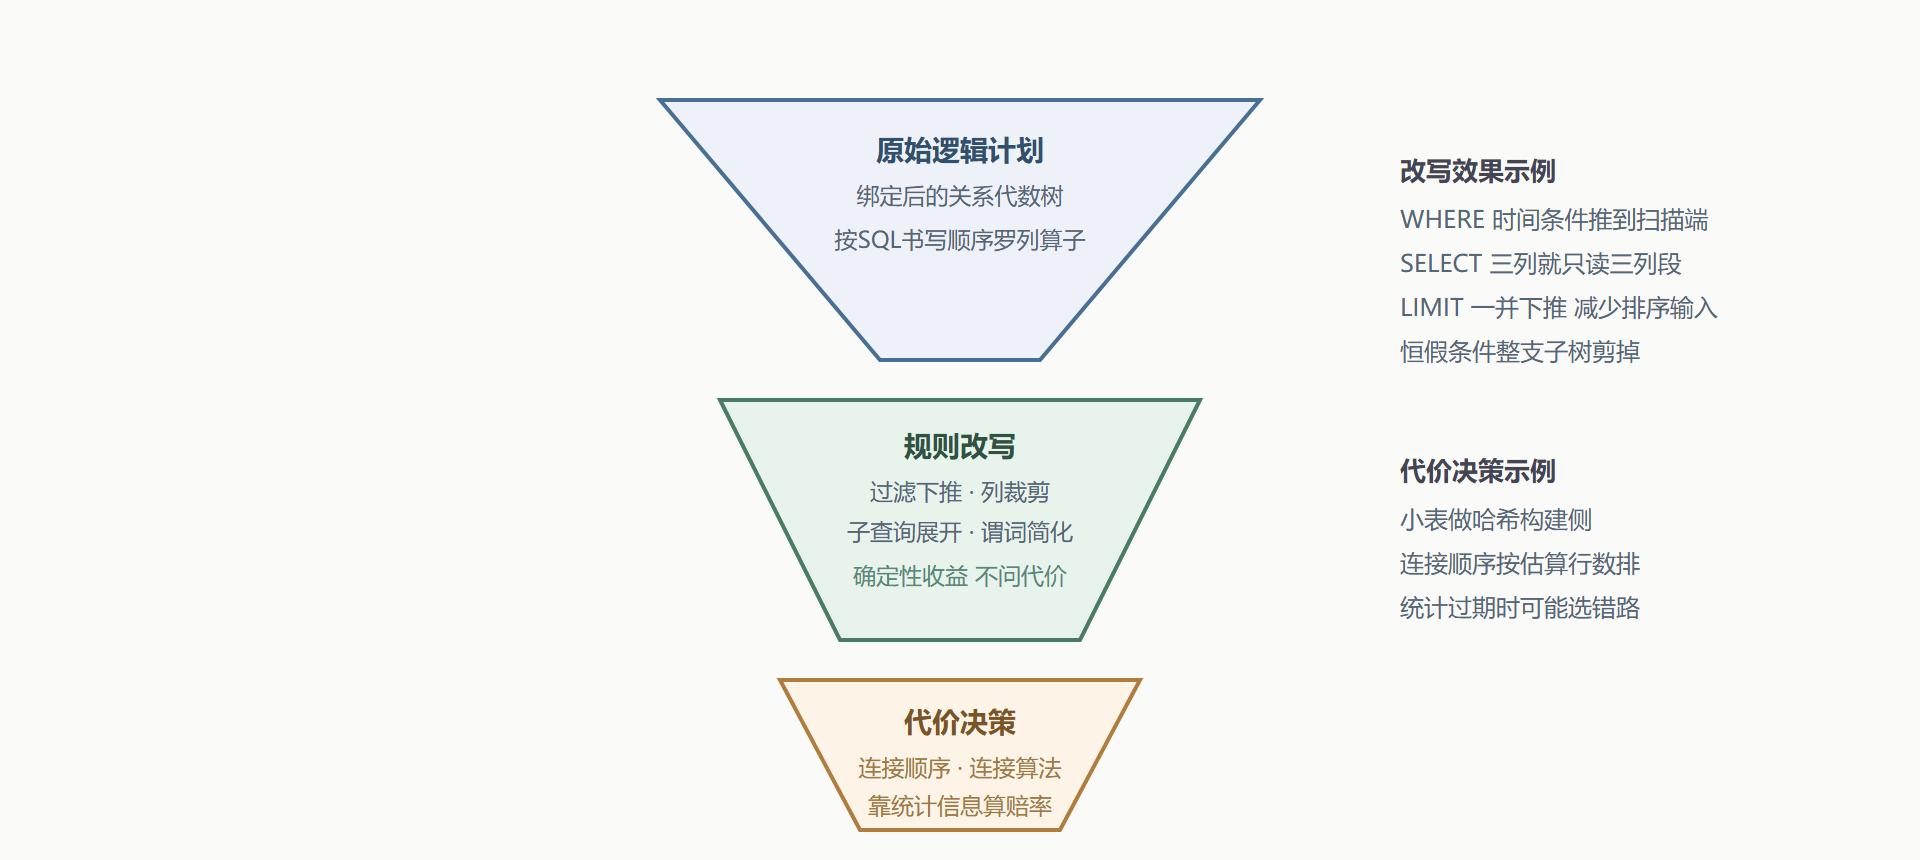
一句带连接、过滤、聚合的 SQL,对应的合法执行计划成千上万:先连接哪两张表、用哈希还是用归并、过滤放在扫描前还是聚合后——结果都一样,速度天差地别。优化器的存在就是替你搜索这些等价方案。它的工具箱分两层:规则改写是确定赢的棋(把过滤条件推到扫描端,读的数据只会更少),不问代价直接做;代价决策是博弈棋(小表连大表谁做构建侧),要靠统计信息算赔率再下注。两层分工会帮你在读计划时辨方向:看到"没做"的确定收益(过滤没下推),那是引擎的锅或写法阻碍了它;看到"选错"的博弈决策(构建侧选大),那多半是统计骗了它——两类问题的修法完全不同,前者改写法,后者刷统计。
两类决策的原料都是统计:每列的值分布、不同值个数、最小最大值。第3章说过这些统计就存在列段头部——所以"数据收进列式表"的收益不止扫描快,还包括优化器从盲跑变成看路走。CSV 直查时优化器能做的决策少得多,这也是直查慢的隐性原因之一。顺这条线还能解释一个现象:同一条查询,跑在列式表上与跑在 CSV 上,计划形状可能都不一样——不是引擎偏心,是它手上的情报量级不同,聪明的决策从来只属于有情报的一方。
图4-2 优化漏斗:从原始计划到物理计划
EXPLAIN 的读法:四步固定动作
看懂计划是排错的核心技能,读法可以固定成四步。第一步看树形:从最缩进的叶子算子读起,顺着缩进往外走,最外层是结果出口。第二步找大头:EXPLAIN ANALYZE 会标注每个算子的实际耗时与行数,占比最高的那个就是主嫌。第三步对账:把"估算行数"和"实际行数"对比,差一两个量级说明统计失真,优化器的选路不可信——常见的解法是 ANALYZE 一下表或重跑检查点让统计刷新。第四步查下推:确认过滤条件真的下推到了扫描端、用到的列真的被裁剪过;如果计划里是"全表扫描后置过滤",红利就被浪费了。四步的顺序有讲究:前两步定位病灶,后两步体检病因来源——顺序反了容易拿着表象当根因。
-- 估算计划:只看结构不执行 EXPLAIN SELECT status, count(*) FROM trades_clean GROUP BY status; -- 带实测的计划:每个算子标注实际耗时与行数,排错主力 EXPLAIN ANALYZE SELECT t.user_id, u.vip_level, sum(t.amount) FROM trades_clean t JOIN users u ON t.user_id = u.id WHERE t.status = 'refunded' GROUP BY t.user_id, u.vip_level;
上面第二条查询是会诊的预备练习:连接与聚合同场,计划里能同时看到连接的构建侧选了哪张表、聚合的中间行数有多大。第4.5节的实战就从读懂一份这样的计划开始。读计划最后补充一个效率习惯:把重要的计划存档。EXPLAIN 的输出是文本,随查询一起进版本库或工单——半年后同样的查询变慢,拿新旧两份计划一对照,是统计变了、数据变了还是引擎变了,一眼分明。计划就是查询的心电图,心电图不留底,复查全靠猜。
帮优化器做对的三个习惯
优化器不是万能的,三个使用习惯能显著提高它的命中率。其一,过滤条件尽量显式、可计算:对列套一层函数再比较,很多下推机会就没了;写 trade_time >= 某时刻 就比 date_trunc('day', trade_time) = 某日 更容易被推到扫描端。其二,别抢优化器的活:手工写的子查询嵌套和强制连接提示,往往把简单问题复杂化;先给优化器机会,确认它选错了再干预。其三,让统计保持新鲜:大批量导入后跑一次检查点或分析,统计跟上现实,代价决策才有依据。
还有一个心理提示:优化器的输出是"基于信息的最佳猜测",不是真理。同样的查询在不同数据分布下计划不同,是正常现象而非不稳定。会诊时始终以 ANALYZE 的实测数字为准,估算只用来找疑点。
一份计划的对账实战
读法固定成四步了,用主线案例的预备查询走一遍全程。计划输出(简化了细节,保留信号)大致如下:
│ HASH_GROUP_BY 约3万组 耗时占比 18% │ └ HASH_JOIN 实际112万行 │ ├ SEQ_SCAN users 实际8万行 列裁剪后只读2列 │ └ SEQ_SCAN trades 实际690万行 过滤已下推 行组剪枝生效
四步走一遍。看树形:两个扫描是叶子,连接在中间,聚合在出口。找大头:连接占比最高(约六成)——它是本计划的主嫌。对账:扫描的估算与实际在同一量级,统计健康;连接的估算行数与实际也接近。查下推:交易表扫描旁标注了过滤下推与剪枝,红利兑现。结论:这条查询的瓶颈不在扫描(已经足够快),在连接本身——输入量六百九十万对八万,探测端的体量决定了下限。这个结论直接指向会诊方向(第4.5节):要么让探测端更瘦(过滤前置),要么让连接干脆发生在更小的数据上(预聚合)。你看,读计划四步走完,优化动作已经自己浮出来了——这正是"读懂计划"四个字的含金量。还剩最后一个习惯动作:把结论写成一句话存档——"本计划瓶颈在连接探测端,方向是过滤前置或预聚合"。一句话结论在下次对照时就是最锋利的参照物,比翻旧计划逐行比对快得多。
估算为什么会失真
第三步"对账"值得单独展开,因为估算失真是计划翻车的头号原因。优化器的估算建立在统计快照上,而现实有三种方式让它过期:大批量导入后没刷新——表从十万行变千万行,统计还停在十万行的时代;数据分布突变——某列原本均匀,业务改版后严重倾斜,均匀假设下的选路全错;复杂表达式的基数猜测——表达式组合的中间结果规模最难估,误差天然偏大。失真的后果不是报错,是静默选错路:该小表构建的选了大表,该下推的没推。所以排错纪律里"估算与实际对账"永远排在"怀疑优化器"前面——先确认它拿到的是真实情报,再批评它的决策。
优化器不替你做的三件事
给优化器画完像,把它的职责边界也画清——三件事它明确不管。不管数据倾斜:估算基于分布快照,键值严重倾斜的连接,它按平均数下的注解照旧失真,倾斜治理靠布局与预聚合(第7.2节)。不管业务语义:金额过滤的边界写零还是写一分钱,在它眼里都是合法谓词,哪个符合业务只有你知道——语义错的结果再快也是错的。不管跨语句的全局:每条查询独立优化,"先物化再查"还是"一条巨型公用表表达式跑到底"的取舍在语句之外,那是你的架构决策(第4.5节物化、第7.2节粒度两节都在回答它)。划清这三条边界,你对优化器的期待就摆正了:它是同一语句内的等价变换高手,不是帮你设计数据架构的顾问。
本节要点回顾
- 优化器两层决策:规则改写做确定赢的棋,代价决策靠统计下注。
- 统计是决策原料:列存表自带统计,CSV 直查时优化器先天信息不足。
- 读计划四步:看树形、找大头、对账估算与实际、查下推是否到位。
- 三个好习惯:条件可计算、不抢优化器的活、批量导入后刷新统计。