5.3 生态集成:Pandas、Arrow与BI
5.3 生态集成:Pandas、Arrow与BI
本节摘要:数据在工具之间流动的成本,取决于通道的设计。Pandas 走替换扫描零配置可达,Arrow 是真正的零拷贝枢纽,BI 工具经 ODBC 桥接。本节讲清三条通道的机理与取舍,让"工具间倒数据"不再是分析工作流的隐性税。
一条数据通道的成本账
传统工作流里,数据每进出一个工具都要过一次序列化:查询结果转成 CSV 再读进 Pandas,DataFrame 转 JSON 再喂给前端——每次转手都付一遍编解码、内存翻倍的代价。DuckDB 的集成设计把这笔账压到接近零:进程内工具共享同一块内存的格式约定,传递的是指针而不是副本。理解三条通道的机理,你才能在大数据量场景下选对路径。成本账还有个隐性科目常被漏记:序列化不只是慢,还是类型失真的高发点——文本格式里的日期变字符串、整数变浮点,都发生在转手的那一刻;零拷贝通道顺便把这类静默变形也堵掉了,省下的是排错时间。
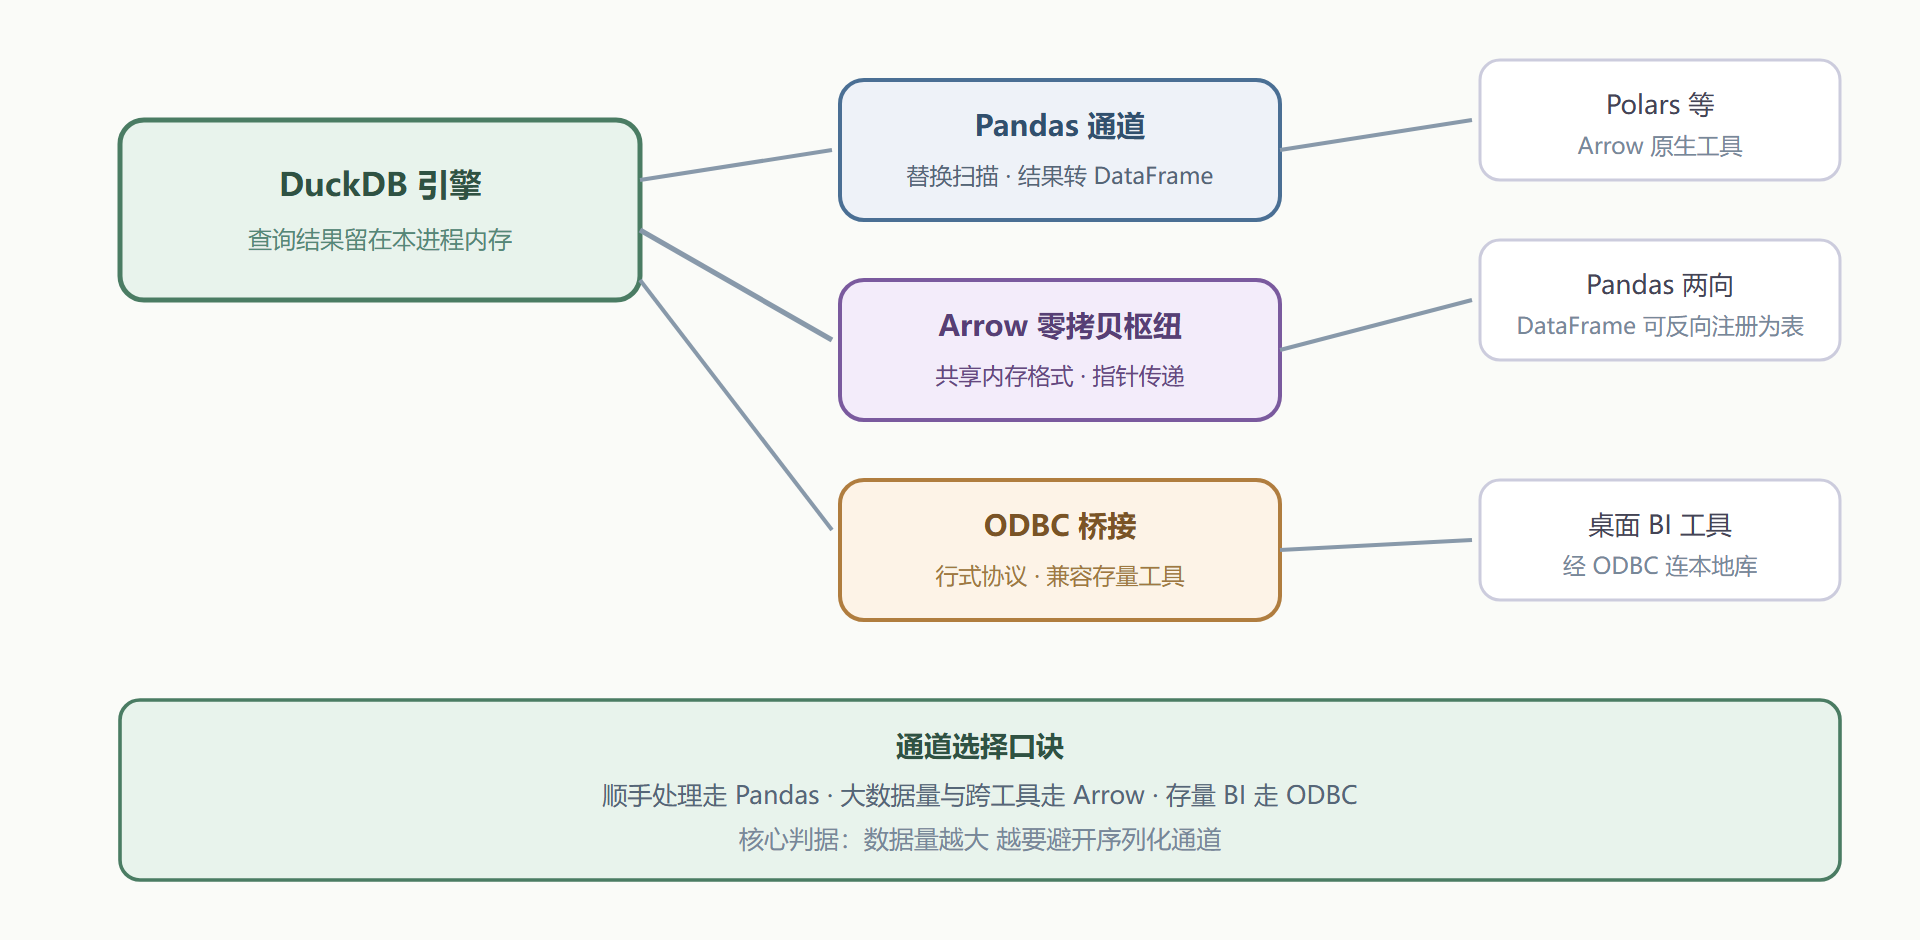
图5-1 三条数据通道的拓扑
Pandas 通道:顺手优先
Pandas 通道的便利性拉满:查询结果一行代码转 DataFrame;反向更有趣——把 DataFrame 直接写进 SQL 的 FROM 位置,替换扫描机制按名字自动识别。笔记本里的混合分析大多走这条道:
import duckdb, pandas as pd df = pd.read_parquet("recent_trades.parquet") # DataFrame 直接当表用 out = duckdb.sql(""" SELECT status, sum(amount) AS 金额 FROM df GROUP BY status """).df() # 结果再转回 DataFrame # 反向:查询结果落成持久表 duckdb.sql("CREATE TABLE recent AS SELECT * FROM df")
它的局限也来自便利:DataFrame 是 Pandas 自己的内存格式,传递时可能发生一次类型映射与拷贝;几GB以上的数据反复转换,内存会翻着倍地涨。所以量小随手用 Pandas 通道,量大了换下一站。
Arrow 通道:真正的零拷贝
Arrow 是为"进程间零拷贝交换"设计的列式内存格式——它是开放标准,Pandas 之外的计算工具(Polars 等)原生吃它。DuckDB 的结果可以直接取成 Arrow 表,内存不复制、格式不转换;反过来 Arrow 数据也能原地当表查询。大数据量场景下,"查询出 Arrow、Polars 接力加工、再回 DuckDB 聚合"整条链不发生一次全量拷贝:
import duckdb, polars as pl # 查询出 Arrow,交给 Polars 加工,再回来入库 tbl = duckdb.sql("SELECT * FROM trades_clean WHERE status = 'refunded'").arrow() polished = pl.from_arrow(tbl).with_columns( (pl.col("amount") * 100).alias("amount_cents") ) duckdb.register("polished_view", polished.to_arrow()) duckdb.sql("CREATE TABLE polished AS SELECT * FROM polished_view")
选型口诀随之清晰:顺手处理走 Pandas,大数据量与跨工具走 Arrow。两者不冲突,同一条流水线里按段选用。
BI 与存量工具:ODBC 桥
桌面 BI 工具大多只讲数据库方言,桥接靠 ODBC:装上驱动后,BI 工具把本地库文件当成一个数据库服务连接,拖表出图。这里有个务实建议——BI 直连时把库文件设为只读:BI 工具的连接行为不可控,避免它意外触发写入或锁冲突(呼应第2.3节单写者原则)。另外,复杂聚合别指望 BI 端的查询引擎:让 DuckDB 先把数据聚合成小表(第4.5节的物化),BI 只做可视化,各用各的长处。这个分工还能反向利用:BI 的字段拖拽最终翻译成的 SQL 形态往往笨拙,先物化到"BI 友好"的粒度(每行一个可拖拽的事实、维度列齐全),拖拽体验会流畅一个档次——给 BI 喂什么形状的数据,决定了它在用户手里像不像样。
浏览器场景补一句:DuckDB 还有可编译到 Wasm 的版本,数据不出浏览器就能做分析——适合隐私敏感的交互式报表场景,算生态的一个特殊分支。
一个让通道更稳的习惯:先小后大
三条通道的用法都讲完了,补一条横跨所有通道的工程习惯:任何新的通道组合,先跑小样本再上全量。步骤廉价得不像工程规范:把全量查询加个 LIMIT 一千,走一遍完整的"查询、转换、落地"链路,看三样东西——类型映射有没有失真(上一节的三类现场)、结果行数对不对、耗时随行数怎么涨。小样本通过后再放全量,90% 的集成意外会在这一步现形,而它们的修复成本还停留在"改一行"的量级。这条习惯的本质是把集成验证从"上线后救火"前移到"接通时体检"——它没有用到任何高深机制,纯粹是顺序智慧,跟第5.4节实录里"先对账再深挖"是同一个思想在不同环节的化身。
类型保真:跨工具翻车的头号现场
通道讲完,要揭它最容易翻车的地方:类型映射。零拷贝省的是搬运,可类型系统之间的差异不会消失——Pandas 的缺失值语义、时间戳精度、整数位宽各有各的默认,转换处就是事故高发区。三类高频现场:时间戳精度——纳秒精度的时间列转进默认配置的 DataFrame 可能降级,细粒度时序分析悄悄失真;整数列的空值——SQL 的 NULL 列转成 Pandas 整数列时会被提升成浮点,id 列出现 884213.0 这种碍眼又危险的形态;字符串类别——字典编码的类别列展开成对象数组,内存占用翻几倍。
防线不是不用通道,而是过通道后验一次类型:
tbl = duckdb.sql("SELECT * FROM trades_clean LIMIT 5").arrow() print(tbl.schema) # 先看 Arrow 侧的类型契约 print(df.dtypes) # 再对照 DataFrame 侧的实际形态
schema 对照三十秒,能拦下绝大多数静默失真。这个习惯与第3.4节的"嗅探过目"、第7.3节的"类型显式"是同一条纪律的三个切面——数据每跨一次边界,类型就核对一次。
主线案例的通道组合
主线案例里三条通道都用过,组合方式值得复盘。日常探索走 Pandas 通道——清洗结果几十万行,便利优先;季度对账走 Arrow 通道——全量数据跨 Pandas 与 Polars 两个工具,零拷贝省下的内存翻倍是实打实的;月底给管理层出报表走 ODBC 桥——BI 工具连只读库文件,底层数据是第4.5节物化的周度小表,拖拽出图毫无压力。三种通道各司其职的背后是同一条成本意识:通道的切换成本几乎为零,选错通道的内存账单却很贵。工具之间不该有站队,数据在哪儿算得最顺,通道就往哪儿架。
本节要点回顾
- 成本账决定通道:数据量越大,越要避开序列化与全量拷贝。
- Pandas 通道顺手:替换扫描双向可达,适合中小数据量的混合分析。
- Arrow 是零拷贝枢纽:开放标准、指针传递,大数据量跨工具的默认选择。
- BI 走 ODBC 只读连:聚合在 DuckDB 侧物化,BI 只管可视化。