5.4 Jupyter工作流实录
5.4 Jupyter工作流实录
本节摘要:前面三节把接口、方言、集成逐个讲完,本节把它们串成一条真实的时间线——一个分析员用 Jupyter 加 DuckDB 从一份原始 CSV 走到可交付结论的一整天。实录的价值不在某个单点技巧,而在"每一步用哪个出口、何时落盘、何时对账"这些顺序决策。
把笔记本变成分析台
第5.1节说过,Python 通道适合自动化与集成;第5.3节把 Arrow 枢纽架好了;本节是这三样东西在真实工作节奏里的样子。主线案例推进到这一步:业务方要的周度退款走势报表已经会诊完毕(第4.5节),但新一季度的数据到了,需要从头再跑一遍流程——正好借这个机会,把散落前文的工作步骤排成一天的日程。
开工前把环境备齐:笔记本里装好 DuckDB 的 Python 包,加载官方提供的 SQL 单元魔法,再把上一季的库文件挂上。之后的每个单元格都能直接写 SQL,结果默认回成 DataFrame:
import duckdb con = duckdb.connect("analytics_q3.duckdb") # 本季分析库 # 加载单元魔法后,单元格内可直接写 SQL,%%sql 输出自动成为 DataFrame %load_ext duckdb.dbmagic
准备工作只有一件事值得强调:库文件按季度分开。Q2 的产物留在 Q2 的库里,Q3 从空库开始——嵌入式数据库建库零成本,按项目开库比在一个大库里堆历史干净得多。
上午:接住文件并摸底
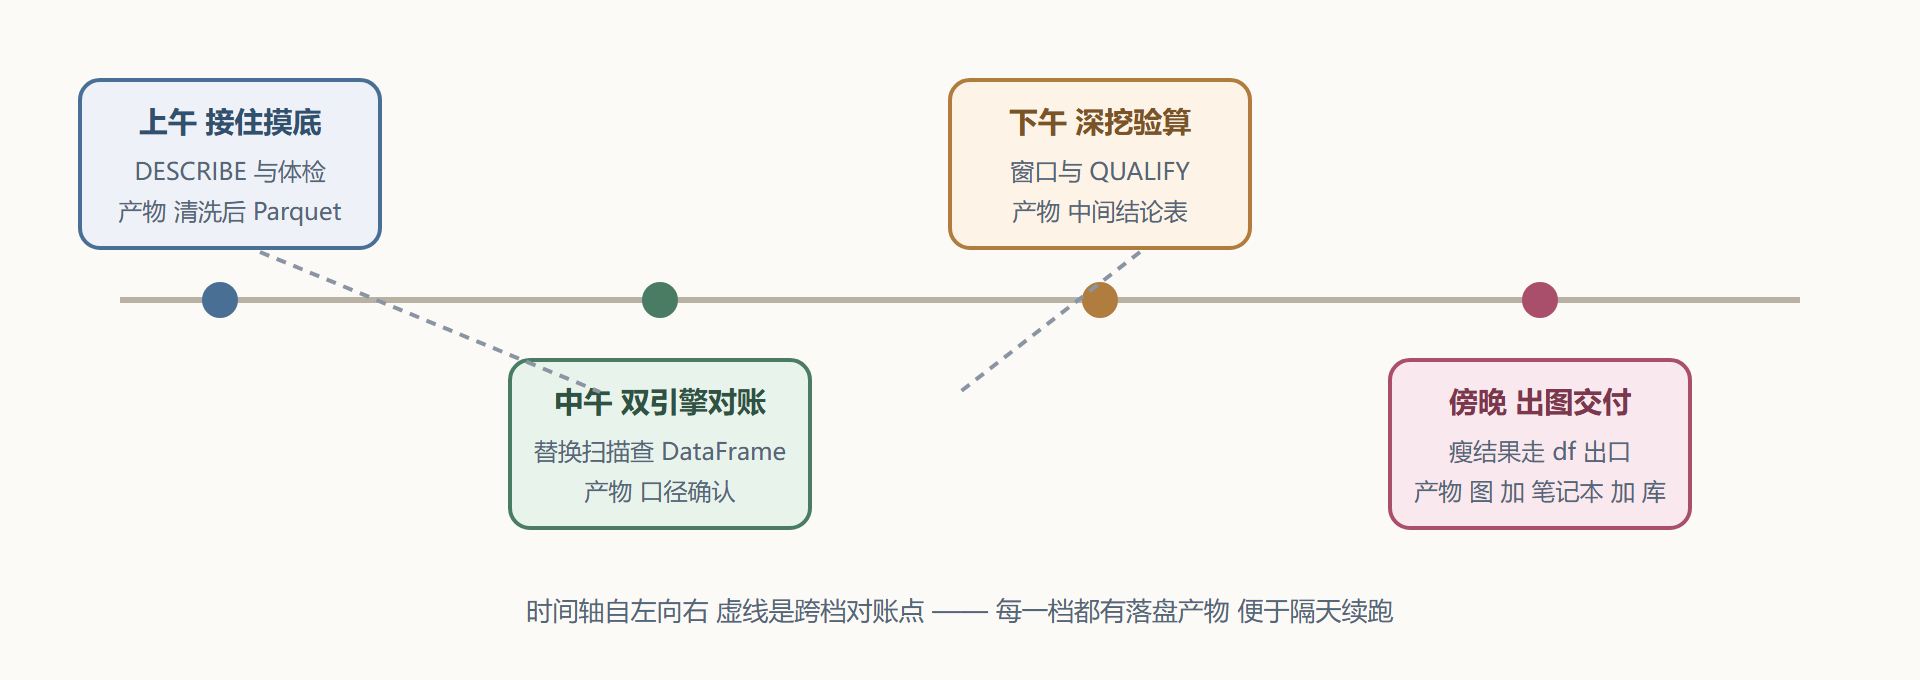
九点半,原始交易明细到手,一份四个多 GB 的 CSV。第一件事不是写清洗逻辑,而是摸底:列有哪些、类型推断成了什么、各列长什么样。DESCRIBE 与 summary 两个语句专干这个:
-- 类型嗅探结果先过目,重点看日期与金额列有没有被读歪 DESCRIBE SELECT * FROM read_csv_auto('trades_2024q3.csv'); -- 数值列的分布一屏看完:min、max、均值、分位数 SUMMARIZE SELECT trade_time, amount, status FROM read_csv_auto('trades_2024q3.csv');
摸底立刻发现两个问题:金额列混进了少量带千分位符的脏值,嗅探降级成了 VARCHAR;status 列有三种拼写变体(refunded、Refunded、REFUND)。清洗方案照抄上一季:显式 CAST 收编金额,统一小写归一状态,然后落成按时间排序的 Parquet——排序这一步是给第4.4节的 Zone Maps 剪枝留的钩子,第3.1节讲过原理:
CREATE TABLE trades_clean AS SELECT trade_time, CAST(amount AS DECIMAL(12,2)) AS amount, lower(trim(status)) AS status, user_id, channel FROM read_csv_auto('trades_2024q3.csv') ORDER BY trade_time; COPY (SELECT * FROM trades_clean) TO 'trades_2024q3.parquet' (FORMAT parquet, COMPRESSION zstd);
清洗完顺手做体检:行数对不对、金额总和有没有因为类型转换漂移。这一步花两分钟,能省掉下午的两小时排错——交付事故里最尴尬的一种,就是结论没错但口径悄悄变了。
下午:对账、深挖与验算
对账是实录里最值得学的一段。同样的聚合,用 DuckDB 与 Pandas 各算一遍,两边数字对上了才继续往前走。替换扫描让这件事几乎没有仪式感——DataFrame 直接写进 FROM,两种工具在同一条 SQL 里碰头:
import pandas as pd # Pandas 惯用写法算一份 df_pd = pd.read_parquet("trades_2024q3.parquet") pd_refund = df_pd[df_pd.status == "refunded"].groupby(df_pd.trade_time.dt.weekday)["amount"].sum() # DuckDB 直接查那个 DataFrame(替换扫描),零拷贝 duck_refund = con.sql(""" SELECT weekday(trade_time) AS wd, sum(amount) AS amt FROM df_pd WHERE status = 'refunded' GROUP BY wd ORDER BY wd """).df() pd.testing.assert_series_equal( pd_refund.sort_index(), duck_refund.set_index("wd")["amt"], check_names=False )
两个引擎对不上号时,九成是空值语义或类型宽度的差异——Pandas 的 NaN 与 SQL 的 NULL 在聚合里表现并不总是一致,这正是第5.3节强调类型保真的原因。对上号之后,下午的深挖就放开了跑:窗口函数算每个用户的退款间隔,QUALIFY 直接取每组前三,方言糖在第5.2节都铺过了。
深挖中间还有一个习惯动作:每条超过一秒的查询看一眼计划。EXPLAIN ANALYZE 的输出在笔记本里读起来和命令行没有区别,第4.2节的读法原样适用。一整天的探索里,唯一一次超时是窗口函数没写分区键导致的,改一行就好。
出图与交付:出口怎么选
到出图这一步,数据已经很瘦了——周度聚合结果不过几十行。这时出口怎么选又变成了一个有意识的决定:小结果直接 .df() 喂给画图库;要存档或给下游复用的,写成 Parquet;要在另一个工具里继续用的,Arrow 出口保真度最高(第5.3节)。
import matplotlib.pyplot as plt weekly = con.sql(""" SELECT date_trunc('week', trade_time) AS 周, sum(amount) AS 退款金额 FROM trades_clean WHERE status = 'refunded' GROUP BY 周 ORDER BY 周 """).df() fig, ax = plt.subplots(figsize=(9, 3.5)) ax.bar(weekly["周"], weekly["退款金额"], color="#4a7c63") ax.set_title("2024Q3 周度退款金额") fig.savefig("q3_refund_weekly.png", dpi=150, bbox_inches="tight")
交付物是四样:结论文字(周五退款集中在下午三点到五点,环比上季抬升约一成半)、一张图、一份可复跑的笔记本、一个落盘的 Parquet。把笔记本里的探索性单元格折叠或删掉,留下从清洗到出图的干净主线——交付的不是你的思考过程,而是一条别人也能跑通的路。
图5-4 一天工作流的时间线与产物
收工清单与变式
实录收尾,把一天的动作压成一张可复用的清单:开工先分库、摸底先 DESCRIBE、清洗必落 Parquet 且按过滤列排序、跨引擎结论先对账、大查询看计划、交付留干净主线。这张清单不需要记住原理——原理在前六章里,清单只负责让手指少走弯路。
两个常见变式。其一,团队协作形态:把清洗与聚合固化成脚本跑批,笔记本只承担探索与出图,库文件放共享存储供多人只读——注意第2.3节的约束,并发写仍然要收拢到单进程。其二,定时报表形态:把下午的深挖 SQL 存成视图、结果表按周刷新,就是第4.5节物化思路的日常版。变式再多,骨架不变:嵌入式引擎的价值,是把"数据进结论"的整条路装进一个进程,而笔记本只是这条路的驾驶舱。
往下走:工具链到本节全部配齐。第6章补上能力外延与安全边界——扩展机制让你按需加载新本事,也让你看清读不可信文件时的信任从哪来。
本节要点回顾
- 按季分库:嵌入式建库零成本,项目隔离比单库堆历史干净。
- 摸底两件套:DESCRIBE 看类型嗅探,SUMMARIZE 看数值分布,先摸底再清洗。
- 对账是保险丝:双引擎同题对数,对上才走;对不上先查空值与类型宽度。
- 出口有讲究:小结果 df 出图、存档走 Parquet、跨工具走 Arrow。
- 交付给路线不给过程:干净主线加产物文件,别人跑得通才算交付完成。