1.3 内存布局与刚体数组
1.3 内存布局与刚体数组
本节摘要:求解器是热循环,它按接触扫刚体的速度和质量倒数。把这些字段拆成并行数组,缓存命中率和 SIMD 才有着落;面向对象的“每个刚体一个堆对象”会把时间耗在指针追逐上。本节给出最小 SoA 布局、句柄与世代、静态/动态分表,以及什么数据不要塞进热路径。
你能学到什么
阅读完本节,你应当能够:
- 画出刚体热数据和冷数据的分家方案
- 用句柄加世代避免悬空指针
- 解释为什么接触求解阶段不要去碰形状网格
- 为第 6 章的 SIMD 预留数组对齐,而不过早写向量化代码
一、求解器要扫的是速度,不是“物体对象”
写完弹跳球,第一反应往往是 class RigidBody,里面塞位置、速度、网格指针、材质名字、脚本回调。宽相还能忍,到了顺序冲量阶段,每个接触要读两个质量倒数、两个速度、写回两个速度,循环几千次。若每次都经由对象指针跳到堆上另一处,L1 缓存形同虚设。物理引擎的性能故事,一大半是“热数据有没有排成一条直线”。
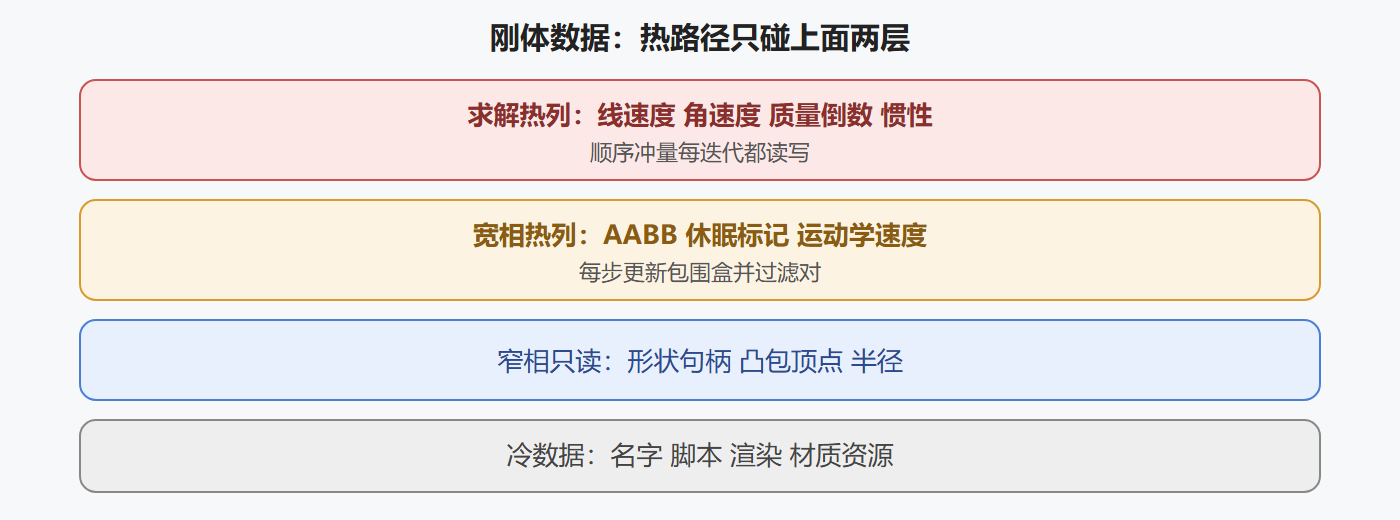
货仓里盘点库存,不会每问一个货位就跑一趟办公室查合同。合同是冷的,货位上的数量是热的。刚体也一样:求解器要的是速度、角速度、质量倒数、惯性、是否休眠;网格、名字、渲染句柄整帧可能只用一次。
结构体数组(AoS)把一个刚体的所有字段捆在一起,写着舒服,扫速度时却把网格指针一起拖进缓存行。数组结构(SoA)把所有速度放一张表、所有位置放一张表。求解器只绑速度表和质量表。宽相只绑包围盒表。各取所需。
BodyHot: pos[] # vec3 linVel[] # vec3 angVel[] # vec3 invMass[] # float invInertia[] # 对角或 3x3 flags[] # 休眠、运动学、已岛分 BodyCold: shapeHandle[] friction[] restitution[] userPtr[]
二维原型可以更狠:位置用两个 float 数组 x[] y[],方便后面 SIMD 一次处理四个物体。三维先 vec3 紧排,注意对齐,避免编译器为对齐插入洞还自以为 SoA。
| 布局 | 写法 | 单次读速度 | 加字段 | 适用 |
|---|---|---|---|---|
| 对象堆 | new Body | 指针跳 | 容易 | 教学、物体小于几十 |
| AoS 紧数组 | Body bodies[] | 带上邻居字段 | 改结构体 | 中等规模 |
| SoA | 分列数组 | 最干净 | 加一列 | 求解器热路径 |
| 混合 | 热 SoA 冷 AoS | 热路径干净 | 两套索引 | 产品引擎常见 |
我更倾向混合:热 SoA,冷可以是带句柄的结构体。不要在物体少于 20 的作业里过早上 ECS 框架,那是用仪式代替布局。先把数组写对。
二、句柄、世代与删除
宽相、接触、关节都要引用刚体。存裸指针或裸下标,删物体后会指到新搬来的家伙,箱子突然接到一根不属于它的弹簧,现场非常鬼畜。句柄做成 index + generation:删除时世代加一,槽位可复用,持有旧世代的接触在取用时校验失败就丢弃。
function getBody(handle): i = handle.index if slot[i].gen != handle.gen: return 空 return i
删除策略有两种。交换删除:把最后一个活体搬到空洞,更新它的句柄映射。数组紧凑,利于遍历,但所有指向“最后一个”的句柄要改 index。世代句柄下,映射表 handleToIndex 可以改,外部只持有 handle。标记删除:数组留洞,遍历时跳过空洞,实现简单,缓存差一些。动态物体频繁进出用交换删除;静态关卡几何几乎不删,用大数组加标记即可。
静态体不要和动态体坐同一张热表。静态速度恒 0、质量倒数恒 0,放进去只会让求解器多做分支。静态碰撞走单独宽相,接触的 bodyB 可以是“静态表下标 + 高位标记”。运动学体速度由动画写,但仍要出现在动态表,因为别的物体要读它的速度来算相对速度。
包围盒是热的还是冷的?宽相每帧要扫,算热。但它由位置和形状半径推出,可以每帧重建,也可以脏标记更新。高频移动的物体每帧重建 AABB 往往比维护树更便宜——第 3 章会比较。布局上 AABB 做成独立数组,和刚体下标对齐,宽相函数签名里不要出现 RigidBody。
💡 关键直觉:模块边界应该按“扫哪几列”来划,不按 UML 类图划。能只传速度列和下标数组的函数,不要传“世界对象”。
形状数据(凸包顶点、网格三角形)是冷的,窄相才碰。窄相结果要写成接触点坐标、法向、深度,这些接触是下一阶段的热数据。不要让求解器回头去问“这个接触对应凸包哪条边”。问了就说明接触生成没把账算完。
三、为并行和 SIMD 留的洞,现在先别填满
第 6 章会讲 16 字节对齐、AoSoA、按岛拆分线程。现在只做三件小事,避免返工:
- 动态体下标从 0 连续到 n-1,休眠体可以仍留在表内用 flag 跳过,或定期压缩。频繁压缩会打乱岛缓存,先 flag。
- 接触数组也 SoA:
normalX[] normalY[] ... lambda[]。顺序冲量按接触迭代,这是第二热循环。 - 不要在 step 里 malloc。接触、岛、临时速度用容量预留的向量,超出再扩一次并打日志。实时循环里的隐式分配是卡顿的老朋友。
图 热冷数据分层
假共享是多线程以后的坑,但布局现在就能避免:不要把两个线程写的计数器放相邻字节。岛分割后每个岛写自己的速度区间,区间按缓存行对齐。单线程阶段把动态体连续存放,已经帮了未来的你。
用户回调(破碎、触发器)不要插在冲量循环里。求解器迭代 10 次,回调 10 次会重新进入脚本,缓存和确定性一起死。标记“本步触发的触发器对”,step 末尾再发事件。布局上触发器形状甚至可以不进动态热表。
双缓冲状态给插值用:pos0 上一逻辑态,pos1 当前逻辑态。渲染读这两列做 lerp。不要让渲染读到 step 进行到一半的 pos1,否则箱子会撕裂。单线程简单:step 全部完成再渲染。多线程物理需要三缓冲或读写锁,第 6 章再展开。现在先保证 step 是原子的:要么完整一步,要么看不见。
⚠️ 常见坑:在 Lua/C# 侧保存刚体下标当 ID,跨帧删除后下标复用,脚本把冲量加到新物体上。对外只暴露世代句柄,下标留在引擎内部。
度量比猜测重要。写一个 5000 个球的自由落体,只积分不碰撞,看你是内存带宽墙还是计算墙。若对象堆版本比 SoA 慢几倍,布局目标就达成了,不必再为 20 个箱子的场景过早向量化。过早 SIMD 会把调试变地狱,而布局是几乎不增加复杂度的胜负手。
把 1.1 的结构体拆列时,保持下标即身份的幻觉到函数内部,外部仍用句柄。测试可以写:删除中间一个球,剩余球的速度数组仍然紧凑,旧句柄取不到。这样 1.3 才算落地,而不是“我们改用了 SoA”的口头禅。
对齐和填充再补一句。三维 vec3 若按 12 字节紧排,SIMD 一次读 16 字节会跨两条缓存行。有人用 vec4 浪费一个 float 换对齐,有人接受紧排在标量循环里反而更省带宽。弹跳球和堆箱子阶段用紧排没问题;真要 SSE 一次处理四个物体,再考虑 AoSoA:四个 x、四个 y、四个 z 一组。现在把注释留在数组定义旁,比先写一堆 permute 有用。
冷热分家之后,序列化也变简单:存盘只需要热列加形状句柄,脚本指针本来就不该进存档。这是布局带来的附赠,不是设计目标,但能避免“整个对象图一起 dump”的灾难。
四、句柄表、序列化与常见翻车现场
句柄映射表本身也要预留。删除频繁时,空闲槽栈比扫描找洞快。空闲栈弹出的槽必须升世代,升完才能把下标交给新物体。测试:循环创建删除一万次,外部持有的第一批句柄必须全部失效,不能“碰巧”指到新物体。这个测试失败的引擎,脚本系统以后会随机给错物体加力,现场像闹鬼。
序列化只存热列加形状句柄加世代。指针、脚本对象、调试颜色不要进存档。读档后重建映射表,接触缓存清空或按特征 id 尝试恢复。第一版清空更安全:读档后第一帧堆叠可能抖一下,总比冲量打到错误物体上好。
多线程预告:速度列按岛切片后,切片边界对齐缓存行。现在单线程可以把动态体按下标连续排,删除时交换压缩会打乱岛的下标局部性。睡眠压缩可以低频做:每秒一次把睡着的挪到表尾,减少宽相扫描。低频压缩要更新所有句柄映射,别在接触迭代中途做。
翻车现场一:C# 或脚本侧缓存了下标,引擎交换删除后下标指向另一个箱子,玩家技能打错人。对外 API 只给句柄。翻车现场二:冷数据里的网格指针在热循环里被解引用做包围盒,缓存没命中,分析器显示时间在“碰撞”其实在追指针。包围盒必须是热列。翻车现场三:接触数组每年帧 clear 再 push,分配器打满。改为 count=0 复用容量。
给刚体加“层”字段放热还是冷?宽相每帧读,放热或单独一层列。材质摩擦放冷,只在生成接触时读一次拷到接触上。接触上的摩擦不要每迭代回读冷表。拷一次,求解器只看接触。这是数据流,不是风格问题。
实践问答
交换删除时渲染那边怎么办?
渲染只持句柄。每帧用句柄取下标,取失败就跳过绘制。不要缓存下标跨帧。粒子拖尾若存下标,删除后会跟错物体。
热列要对齐到缓存行吗?
起始地址对齐 16 或 32 字节即可。每个 vec3 改 vec4 可能更慢。先测带宽。岛切片边界再谈 padding 防假共享。
接触 SoA 和刚体 SoA 谁先做?
刚体先做,因为积分和宽相都扫刚体。接触在第 4 章求解热起来再拆。不要一天改完所有布局,对照基准会丢。
本节速览
- 按扫描列分模块:求解器碰速度和质量,宽相碰 AABB,窄相碰形状,脚本碰冷数据。
- 混合布局够用:热 SoA,冷结构体;物体少时不要上完整 ECS。
- 对外句柄带世代,对内下标连续;删除用交换压缩或标记空洞。
- 静态体分表,运动学体留在动态表以便提供速度。
- step 内不分配,接触和岛用预留容量。
- 回调放步末,别插进冲量迭代。
- 先度量再 SIMD:布局是现在就能做的优化,向量化留给第 6 章。
下一章进入积分器。时钟和数组都就绪了,可以公平地看欧拉为什么把弹簧送上天。