6.3 产业链协同:一台EUV之外的系统工程
6.3 产业链协同:一台 EUV 之外的系统工程
舆论喜欢把先进工艺简化成光刻机竞赛:一台两亿美元的 EUV,十几万个零件,全球独一份的供应商。 但一颗先进节点芯片的真实开发周期是十八到二十四个月、流片费以亿计,光刻只是几十个环节里最贵的一件乐器。真正决定流片日期的,往往不是任何单点技术,而是协同接口上的失误:PDK 模型漏掉一项物理效应、IP 迁移没适配鳍配置、量测数据没有回流到模型——每一件都能让整个项目趴窝数周。本节铺开这条产业链的分工版图,拆解 PDK 这份"设计与工艺之间的合同",再讲 IP 迁移的三重适配与数据闭环怎么运转。
分工版图:一颗芯片背后的七方角色
先把棋盘摆开。一颗先进节点芯片从需求到量产,大致经过这样一条链:
| 环节 | 关键角色 | 交付物 | 典型卡点 |
|---|---|---|---|
| 设备 | 光刻、刻蚀、沉积、量测厂商 | 机台与工艺配方 | 新结构需要新腔体,交付周期以年计 |
| 材料 | 晶圆、光刻胶、前驱体、靶材 | 稳定批次的原材料 | 批次间涨落直接进器件参数 |
| 晶圆代工 | Foundry 工艺整合团队 | 工艺平台与 PDK | 良率爬坡,缺陷密度收敛 |
| EDA | 仿真、综合、物理验证、签核工具 | 工具链与模型接口 | 三维效应让旧工具精度失守 |
| IP/库 | 标准单元库、处理器核、接口 PHY | 可复用设计模块 | 跨节点迁移需要重新适配 |
| 芯片设计 | Fabless / 系统厂 | 网表与版图 | 时序、功耗、良率的签核收敛 |
| 封装测试 | OSAT | 成品芯片 | 热与应力反噬前端设计余量 |
这张表的关键不在角色本身,而在角色之间的接口。平面时代,设计与制造之间是松耦合:"我画版图,你照做",PDK 是一份参数表加规则文件,器件行为可以线性外推,出了偏差后期修补。FinFET 把这份默契撕了:鳍间隔离氧化层零点几纳米的波动就能造成几十毫伏的阈值漂移,接触孔偏离鳍顶不到一纳米、接触电阻就阶跃式恶化——设计端不能再把制造当黑箱,制造端也不能把设计当理想输入。协同从此升维:所有环节必须共享同一套"什么才是真实的器件"的定义——同一套形貌数据、同一套统计涨落模型、同一条从版图几何到电学特性的因果链。
PDK:设计与工艺之间的合同
PDK(工艺设计套件)是这条因果链的物理载体。一份先进节点的 PDK 通常包含:器件紧凑模型(FinFET 时代以 BSIM-CMG 为公共语言)、设计规则检查与版图原理图一致性检查规则、寄生参数提取规则、参数化单元、以及覆盖不同工艺涨落方向的工艺角模型。
工艺角的爆炸值得一算。平面时代经典五角——快快、慢慢、快慢、慢快、典型——再加温度电压组合,几十个仿真条件足够签核。FinFET 时代,全局涨落之外必须叠加局部涨落(逐器件失配)、鳍数相关的统计模型、以及自热效应引入的结温维度:
# 工艺角矩阵的规模演算:为什么先进节点的签核成本指数级上升 base_corners = ["SS", "TT", "FF", "SF", "FS"] # 全局工艺角 temps = ["-40C", "25C", "85C", "125C"] # 温度点 volts = ["0.63V", "0.70V", "0.77V"] # 电压点(含降频档) for label, extra in [("平面时代(全局角即可)", 1), ("FinFET 时代(叠加局部失配 3 档)", 3), ("再叠加自热结温 2 档", 6)]: n = len(base_corners) * len(temps) * len(volts) * extra print(f"{label}: 签核条件组合 ≈ {n} 组") # 输出:平面 60 组 → FinFET 180 组 → 含自热 360 组 # 结论:签核不是跑一次仿真,是在超算上把一颗芯片的"所有平行宇宙"各跑一遍
比规模更要命的是模型的忠实度。PDK 模型是对硅片行为的压缩表示,压缩必然丢信息——丢掉哪一项,哪一项就会在某个设计里变成事故。一个反复被业界引用的教训形态:仿真显示模数转换器的积分非线性正负零点六个最低有效位,流片实测却是正负三点二个——排查数周,根因是模型把鳍侧壁粗糙度对迁移率的影响固化成了一个常数,而它实际随鳍高变化。教训的通用形式是:仿真精度不等于硅片精度,模型的适用边界必须与设计的工作区间核对。这也是先进节点形成"三级验证"惯例的原因:用测试芯片数据反向校准模型、在带真实版图寄生的网表上做统计仿真、流片后用实测数据再重构模型参数——每一级都在缩小"平行宇宙"与"真实宇宙"的偏差。
IP 与库:另一条生态轴
标准单元库是 FinFET 生态里最紧的耦合点——它根本不是"迁移"出来的,而是 foundry 与 EDA、库厂商共同设计出来的。第 5 章讲过,先进节点的密度收益一半来自设计工艺协同优化(DTCO):单元高度几轨、每轨几鳍、哪些层走信号、供电怎么上——这些决策同时改写工艺窗口与库架构,只能坐在一起定。
对采购第三方 IP 的设计公司,跨节点迁移要过三重适配关。几何适配:IP 内部的鳍堆叠密度必须匹配目标节点的鳍节距与规则,曾有大型 IP 迁移时没重估鳍配置,一次设计规则检查爆出两万多处违例,修复耗掉两周窗口。电气适配:时序库必须覆盖目标节点的多角模型,且各角之间要满足物理一致性——快角与慢角的延迟比违背载流子饱和速度的上限,时序分析就会出现"虚假收敛"。系统适配:芯片普遍转向芯粒(chiplet)架构后,IP 可能落在不同工艺、不同电压域、不同热环境的不同芯粒里,功耗模型从二维表变成温度电压频率三维查表。三关都过,IP 才算在新节点"落户"。
数据闭环:从晶圆量测回到模型
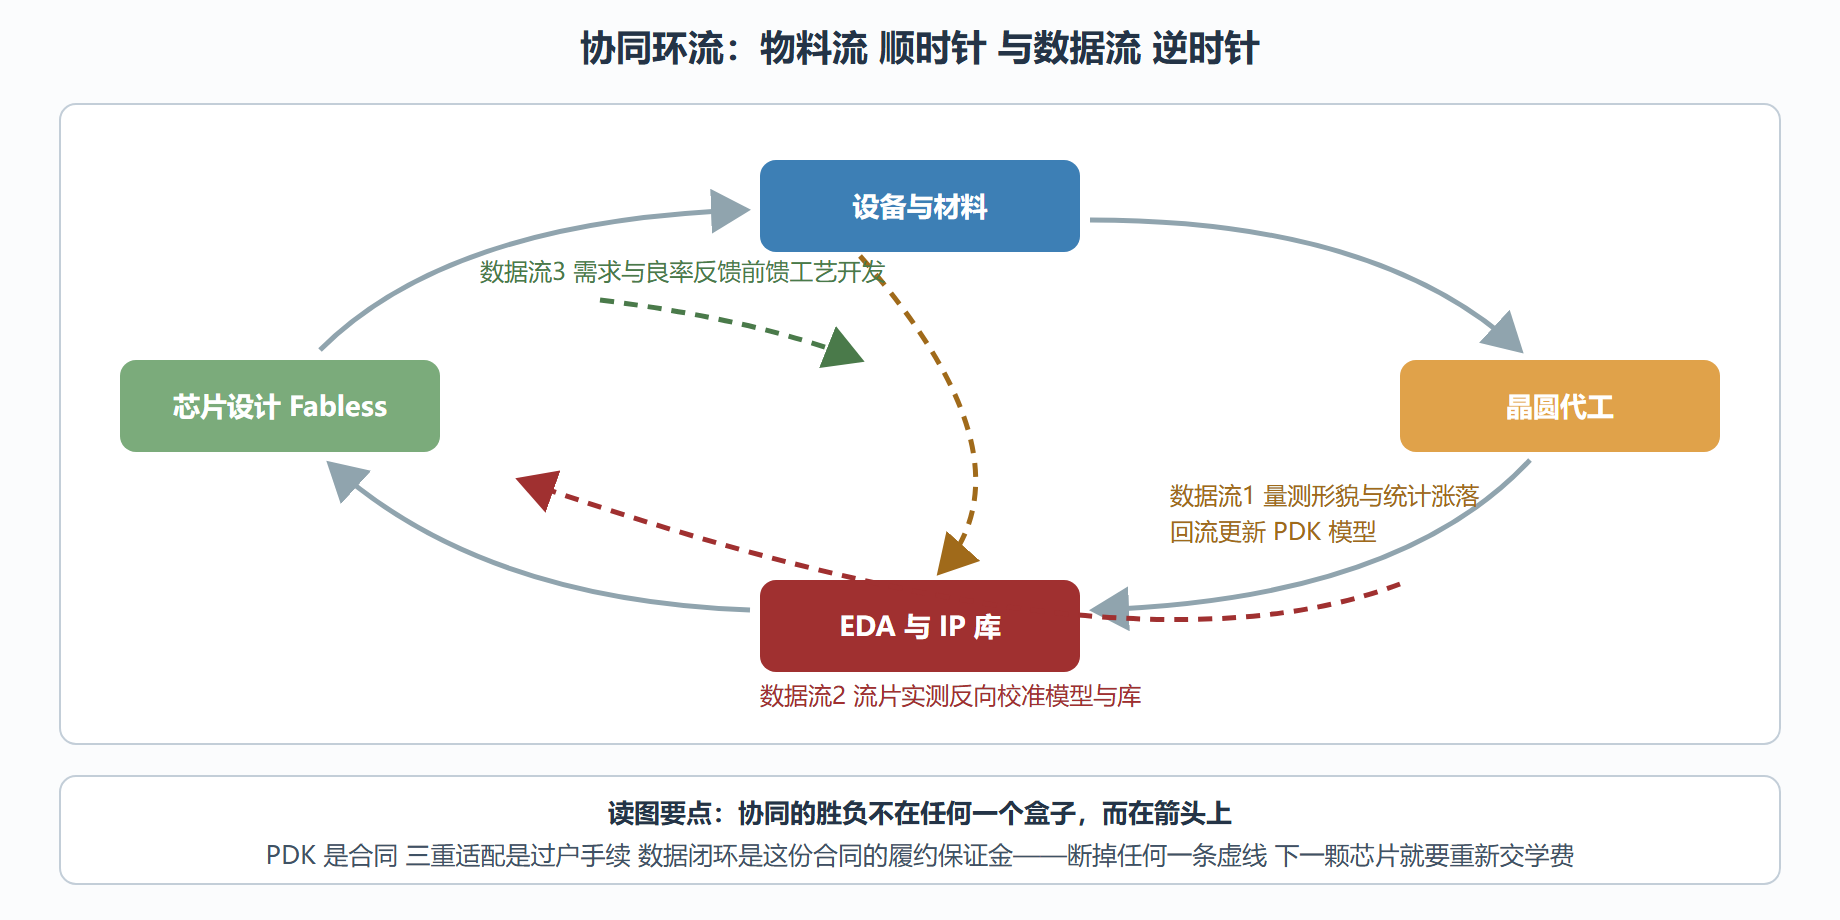
把前面三节串起来的,是一条数据环流。测试芯片与在线量测产出器件的真实统计(形貌、阈值、失配谱)→ 建模团队把它压缩进新的 PDK 版本 → 设计端用新模型签核 → 流片后的实测再回流校验模型——一圈一圈,工艺与设计的共识越来越细。业界甚至开始用"数字孪生"来描述这条环流的终态:每一根鳍都有一份带几何定义、材料属性、涨落谱的数字档案,EDA 工具查询的是这份档案,量测系统更新的是这份档案。到那时,"Fin"才真正从一个版图名词变成产业链各环节共用的一等公民。
图 6-3 产业链协同环流:七方角色与三条数据流
本节要点回顾
- 光刻机只是最贵的一件乐器:先进工艺是七方角色(设备、材料、代工、EDA、IP、设计、封测)的长链协作,卡点常在接口而非单点。
- FinFET 撕碎了松耦合默契:零点几纳米的制造波动就能造成几十毫伏阈值漂移,所有环节必须共享同一套器件真实性的定义与因果链。
- PDK 是设计与工艺的合同:模型忠实度决定合同的有效范围——仿真精度不等于硅片精度,三级验证(测试芯片校准、带寄生统计仿真、流片后重构)是缩小两个宇宙差距的常规军备。
- 工艺角在爆炸:全局角叠局部失配叠自热结温,签核条件从平面时代的几十组涨到几百组——签核是把所有平行宇宙各跑一遍。
- IP 迁移要过三重适配:几何(鳍配置)、电气(多角一致性)、系统(芯粒与三维功耗模型),一关不过就是数以万计的违例或虚假收敛。
- 数据闭环是履约保证:量测统计回流模型、实测回流校准、需求前馈工艺开发——数字孪生是这条环流的终态想象。
器件、电路、产业三个尺度的账都摆完了。第 7 章回到最初的那个问题:这条协同链倾尽全力,FinFET 自己还能走多远——以及谁来接班。