2.1 向量嵌入生成原理
2.1 向量嵌入生成原理
第一章说过"嵌入模型把内容变成向量",但没有打开黑盒。本节站在表示层的入口:承接 1.1 的嵌入定义,讲清模型怎么把变长的内容压成定长向量、维度与成本怎么权衡,以及批量生成时的工程要点——通往 2.2,因为只有先有了向量,才谈得上怎么比远近。
从模型到向量:编码与池化
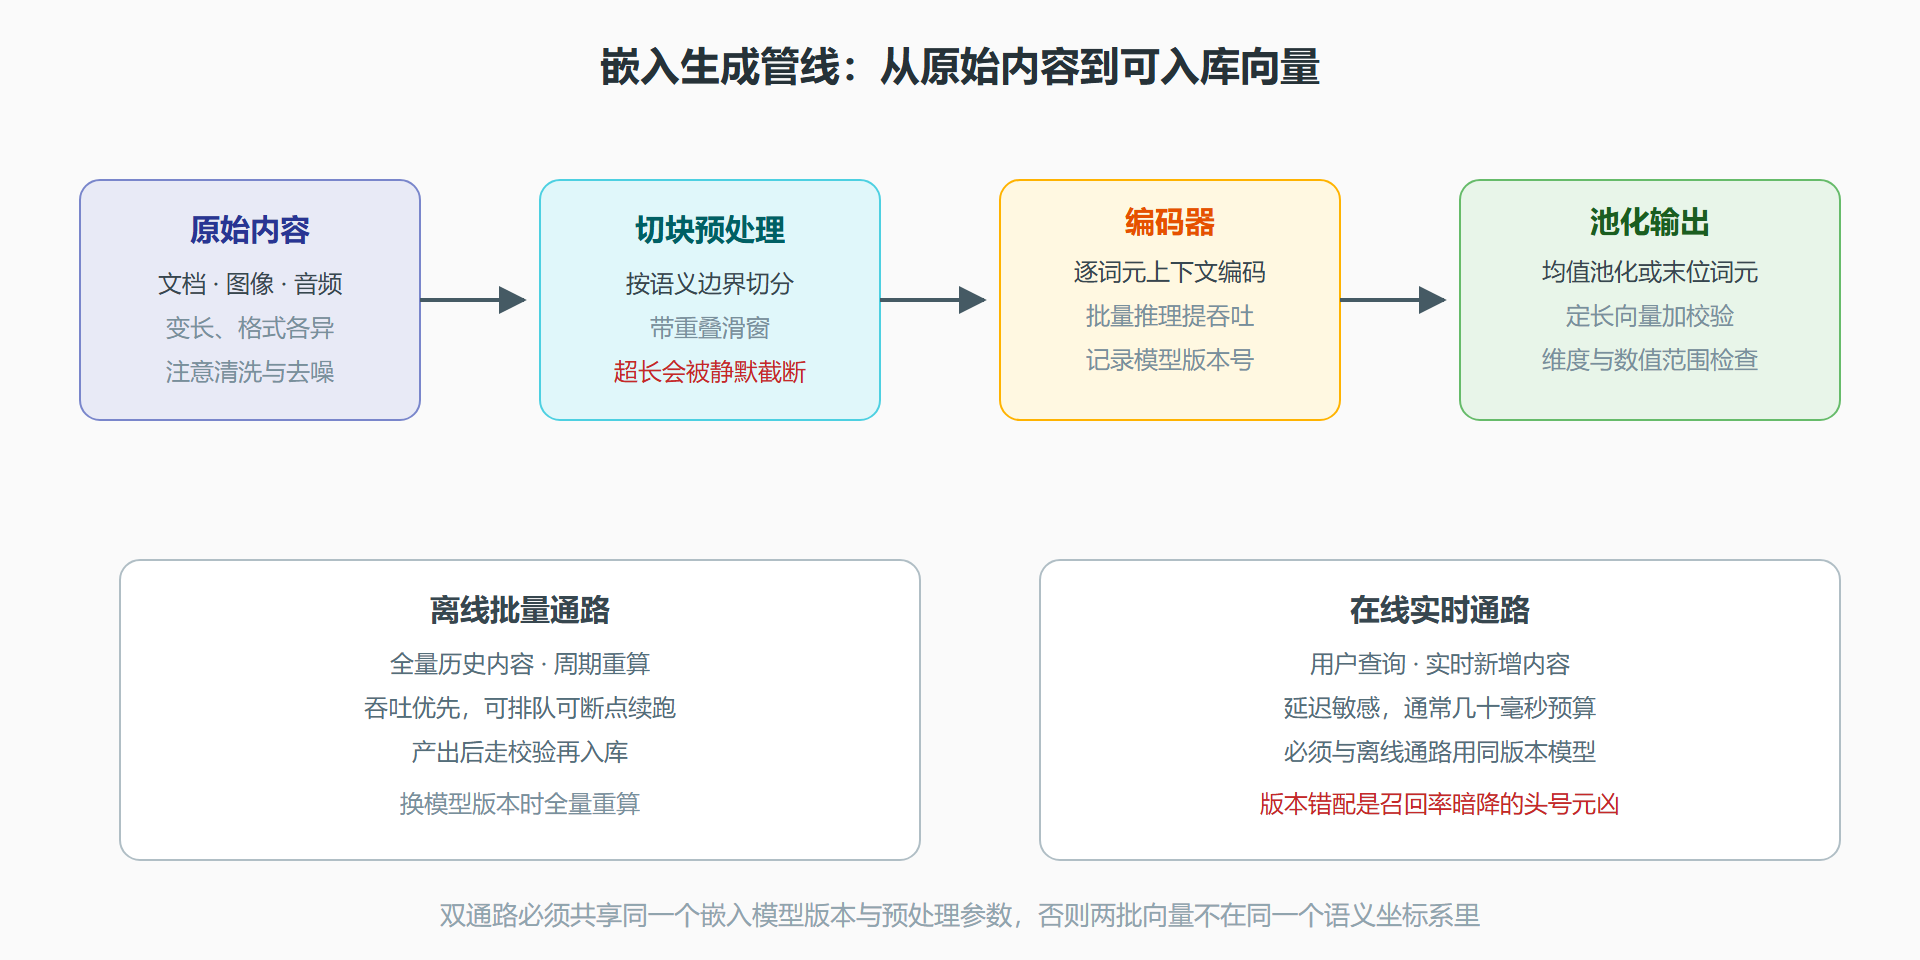
现代文本嵌入模型大多以 Transformer 为骨干。一段文本先被切成词元,每个词元经多层注意力编码成一个上下文相关的表示;但数据库要的是"一条内容一个向量",于是需要一个池化步骤把词元序列压成定长:取末位特殊词元的表示,或对所有词元做平均,或对每维取最大值。不同池化策略对检索效果的影响可以很大,选型时要看模型文档给出的推荐用法——用错池化方式的向量,就像把两张不同的照片各拍了一半再拼起来,勉强能看但信息是错的。
图像与音频模型结构不同,但接口是同构的:输入变长的原始信号,输出定长向量。特别值得关注的是双塔结构:图像塔与文本塔各自编码,通过对比学习训练,让"图片和它的描述"在共享空间里彼此靠近。这正是多模态检索的基础——同一个空间里,文字查询和图片库、图片查询和文字库都能直接比距离,7.1 节会回到这个结构。
图 2-1 嵌入生成管线示意
维度、成本与模型选型
嵌入维度是第一个要拍板的参数。高维通常意味着更强的表达能力,但内存与距离计算成本随维度线性增长:768 维比 384 维贵一倍。选型时按这个顺序自查:语言与领域覆盖是否够;最大输入长度是否容得下你的切块粒度;维度与延迟预算是否匹配;模型更新频率如何——更新越频繁,全量重算的成本越高,模型版本治理就越重要。一个务实的原则是先用维度较低的通用模型把整条链路跑通,把召回基线量出来,再评估换更大模型值不值。
双塔对比结构还带来一个常被忽略的推论:查询向量与文档向量虽然出自同一个模型,但角色不同(查询侧通常有独立的编码前缀)。这意味着查询端和文档端的预处理必须严格对称——哪边多了或少了归一化、切块粒度不一致,都会把两侧推离同一分布。
一个批量编码的完整会话
下面用通用伪 API 展示一次规范的批量编码流程,重点是切块、校验与版本标记三件事:
# 一次批量嵌入会话的关键步骤(伪代码,思路适配任意嵌入服务) MODEL = "text-embedding-demo-v2" # 版本必须记录,换版本需全量重算 MAX_CHARS = 480 # 留出余量,避免逼近截断上限 def chunk(text, size=MAX_CHARS, overlap=50): """带重叠的滑窗切块,尽量落在句子边界""" chunks, start = [], 0 while start < len(text): end = min(start + size, len(text)) cut = text.rfind("。", start, end) # 尝试在句号处断开 end = cut + 1 if cut > start + size // 2 else end chunks.append(text[start:end]) if end >= len(text): break start = end - overlap return chunks def embed_batch(texts): resp = embedding_client.create(model=MODEL, inputs=texts) vecs = [np.asarray(v, dtype=np.float32) for v in resp.vectors] # 入库前三道校验 assert all(v.shape == (768,) for v in vecs), "维度不一致" assert all(np.isfinite(v).all() for v in vecs), "存在非有限值" return vecs # 使用:切块 -> 批量编码 -> 标记来源与版本 for doc in corpus: pieces = chunk(doc.text) vectors = embed_batch(pieces) rows = [(doc.id, i, v, MODEL) for i, v in enumerate(vectors)] collection.insert(rows) # 片段序号 i 便于还原上下文
这段会话里最有工程价值的是三道校验:维度断言能立刻抓住"换了模型忘了改维度配置"这类事故;非有限值检查能拦住数值溢出与空输入;版本标记则在数据层面为将来的模型升级留好账本——哪些向量是哪个版本生成的,重算范围就一目了然。
嵌入质量的快速自检
模型选型的最终裁判是嵌入质量,而质量的粗检不需要标注团队,一小段脚本就能给出方向性结论:从业务里挑一组查询,为每条查询手工指定一条"正确答案"和几条"明显无关"的内容,比较它们的距离——正确答案的距离应显著小于无关项。这个自检的价值在于把"模型好不好"从感觉变成数字,几分钟就能跑完一轮:
import numpy as np def embedding_margin(embed, query, positive, negatives): """正确答案与无关项之间的距离差,越大说明模型对该场景区分度越好""" qv = np.asarray(embed(query)) pos = np.asarray(embed(positive)) negs = [np.asarray(embed(n)) for n in negatives] d_pos = np.linalg.norm(qv - pos) d_neg = min(np.linalg.norm(qv - n) for n in negs) return d_neg - d_pos # 例:售后工单场景的区分度抽查 queries = [ ("退款什么时候到账", "退款将在审核通过后三个工作日内原路退回", ["发票抬头怎么改", "如何修改收货地址"]), ("东西坏了怎么修", "商品在保修期内可申请免费维修", ["怎么开发票", "会员积分怎么用"]), ] for q, pos, negs in queries: print(q, "区分度:", round(embedding_margin(embed, q, pos, negs), 3))
区分度抽查的意义在于早失败:如果连人工指定的正负样本都拉不开距离,说明模型对这个领域的语义不敏感,换模型或补领域微调要发生在建库之前,而不是召回率出问题之后。工程上常见的合格线是正样本距离比最近负样本至少近一个可观比例,具体阈值随业务调整,但趋势不对就足够一票否决。
本节要点回顾
- 池化方式决定定长向量怎么从词元序列压出来,必须按模型推荐使用。
- 双塔对比结构让文本与图像落进同一空间,是多模态检索的基石。
- 维度选型按覆盖、输入长度、成本、更新频率四项排序自查。
- 批量编码的三道校验:维度一致、数值有限、版本标记。
- 查询端与文档端预处理必须严格对称,模型版本必须统一。
向量有了,下一节回答"拿什么尺子比远近":三种度量的完整手算、它们何时一致何时分歧,以及选型表。