2.2 相似性度量方法
2.2 相似性度量方法
向量已经生成,接下来是表示层最关键的一次拍板:用什么口径比较两个向量的远近。本节承接 2.1 的嵌入产出,把内积、欧氏距离、余弦相似度这三个公式用同一组数字完整手算一遍,看它们何时给出一致的排序、何时彻底翻脸,最后落到一张选型表上——这个选择会一路传导到第三章的索引类型和第五章的评估基线。
三种度量的完整手算
设查询向量为 q,候选向量为 a、b、c,取最简单的二维情形便于验算:
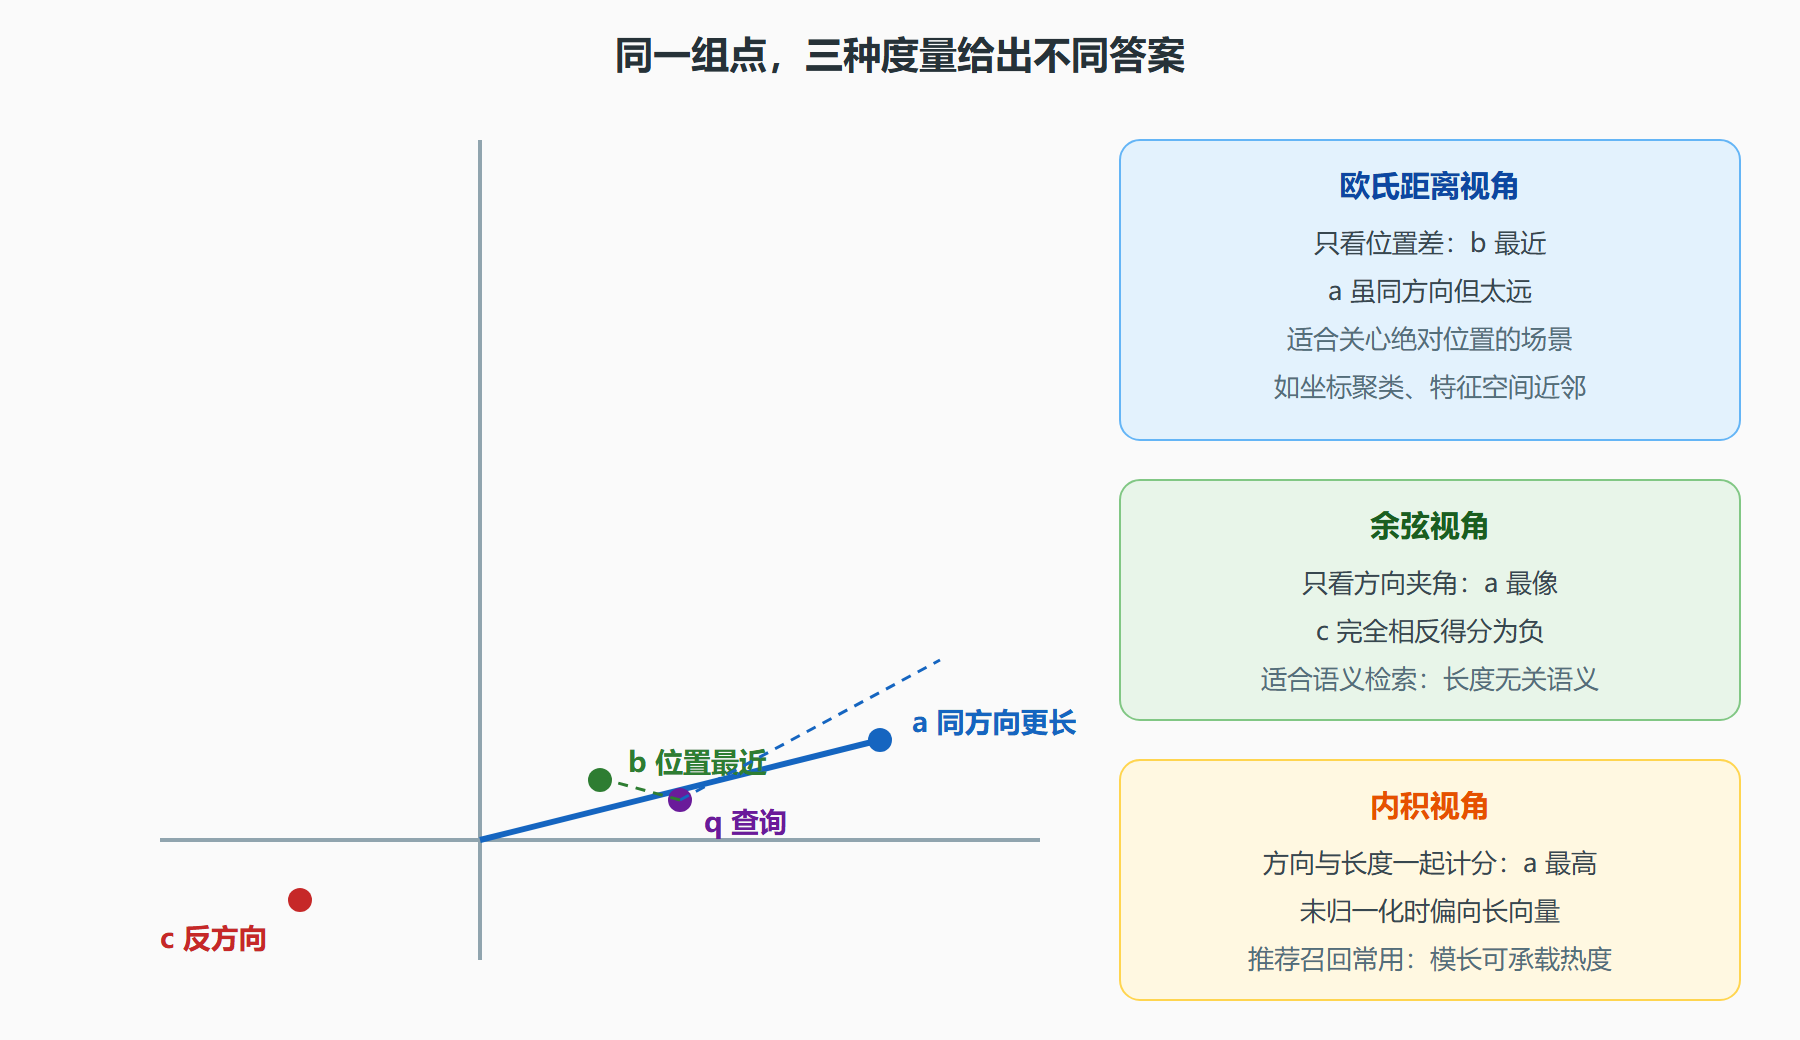
- q = (2, 1),a = (4, 2)(与 q 同方向但更长),b = (1, 2)(方向不同),c = (-2, -1)(与 q 反方向)。
内积是逐项相乘再求和:q·a = 2×4 + 1×2 = 10;q·b = 2×1 + 1×2 = 4;q·c = 2×(-2) + 1×(-1) = -5。欧氏距离是坐标差平方和的开方:d(q,a) = √((4-2)² + (2-1)²) = √5 ≈ 2.24;d(q,b) = √(1+1) = √2 ≈ 1.41;d(q,c) = √(16+4) = √20 ≈ 4.47。余弦相似度用内积除以两个模长:|q| = √5,|a| = √20 = 2√5,于是 cos(q,a) = 10 ÷ 10 = 1.0,说明方向完全一致;cos(q,b) = 4 ÷ 5 = 0.8;cos(q,c) = -5 ÷ 5 = -1.0,方向完全相反。
把三组结果并排看:欧氏距离口径下 b 最近(1.41 < 2.24),因为它离 q 的位置最近;内积与余弦口径下 a 都排第一,因为 a 和 q 同方向。位置最近的点和方向最像的点不是同一个点——这就是三种度量最浓缩的分歧。
再叠一层关系:当所有向量都归一化(模长为 1)时,内积、余弦、欧氏距离给出完全一致的排序,因为此时平方欧氏距离等于常数减去两倍内积。2.3 节会专门讲怎么利用这条性质。
图 2-2 三种度量视角下的同一组点
用代码把分歧跑出来
手算之外,用一段可复现的代码展示内积与余弦"翻脸"的经典情形:
import numpy as np q = np.array([1.0, 0.0]) # 查询 b1 = np.array([0.9, 0.0]) # 短,与 q 同方向 b2 = np.array([3.0, 4.0]) # 长,方向偏离约 53 度 def ip(x, y): return float(x @ y) def cos(x, y): return float(x @ y / (np.linalg.norm(x) * np.linalg.norm(y))) def l2(x, y): return float(np.linalg.norm(x - y)) for name, v in [("b1 短而同向", b1), ("b2 长而偏斜", b2)]: print(f"{name}: 内积={ip(q,v):.2f} 余弦={cos(q,v):.3f} 欧氏={l2(q,v):.2f}") # 输出: # b1 短而同向: 内积=0.90 余弦=1.000 欧氏=0.10 # b2 长而偏斜: 内积=3.00 余弦=0.600 欧氏=5.00 # 内积把 b2 排第一,余弦把 b1 排第一,结论完全相反
分歧的根源在于内积把向量长度也计入了分数。这在某些业务里恰恰是想要的:推荐召回里向量模长可以承载物品热度,热门内容天然排前;但在语义检索里,长度往往只是文本长短的副产品,把长度计入分数会引入系统性偏差——这就是为什么文档检索普遍用余弦,而推荐召回偏爱内积。
选型表与工程细节
| 场景特征 | 推荐度量 | 理由 |
|---|---|---|
| 语义检索、文档问答 | 余弦或归一化后内积 | 长度是噪声,方向承载语义 |
| 推荐召回、广告 | 内积 | 模长承载热度或置信度,可被排序利用 |
| 图像特征匹配 | 欧氏距离或归一化内积 | 主流视觉特征习惯欧氏口径 |
| 归一化向量(统一处理后) | 内积 | 与余弦序完全等价,计算更快 |
三个工程细节值得记住。其一,距离与相似度要换算统一:很多系统内部存距离、对外暴露相似度,换算公式是相似度等于一减去归一化距离,阈值配置时搞混方向是高频事故。其二,精度用单精度浮点足够:嵌入向量的区分度远大于半精度带来的误差,量化压缩是第三章的另一回事,但库内存储统一类型能避免隐式转换的性能损耗。其三,换度量等于重建索引:索引结构与度量方式绑定,中途换口径意味着全量重建,上线前务必定死。
阈值设定:分数的另一半工程
选定了度量,第二个拍板项是相似度阈值——低于多少算"不相关"。阈值工程有三个实践要点。第一,分数分布要用真实数据量出来:同一个模型,不同领域查询的余弦分数分布差异很大,把阈值定为某个想当然的数值(比如零点八)经常要么全放行要么全拦死。正确做法是拿一批已知相关与已知不相关的查询对,画出两组分数的分布,在两峰之间的谷地选阈值。第二,返回排序加阈值双保险:阈值负责拦垃圾,排序负责定先后,两者独立调;只设阈值不设 K 会遇到"这一批全都过线"的放行风暴,只设 K 不设阈值会遭遇"凑不满也要凑"的垃圾填充。第三,阈值跟着模型与数据版本走:换嵌入模型或数据分布漂移后,分数分布整体移动,阈值必须重新标定——把阈值当作配置纳入版本管理,与模型版本绑定。
# 用真实查询对标定阈值的骨架 import numpy as np def calibrate_threshold(pos_scores, neg_scores): """在正负样本分数分布的谷地附近选阈值""" lo = np.percentile(pos_scores, 5) # 正样本的下五分位 hi = np.percentile(neg_scores, 95) # 负样本的上五分位 if lo > hi: return (lo + hi) / 2 # 两峰分离,取谷地中点 return lo # 有重叠,宁可保守取正样本下界 # pos_scores 来自人工确认的相关查询对,neg_scores 来自随机配对 print("建议阈值:", calibrate_threshold(pos_scores, neg_scores))
本节要点回顾
- 内积看方向加长度,欧氏看位置,余弦只看方向——位置最近的点与方向最像的点可以完全不同。
- 归一化之后三种度量的排序完全等价,内积是其中计算最省的。
- 推荐召回用内积让模长承载热度,语义检索用余弦摆脱长度噪声。
- 距离与相似度换算方向搞混是高频事故,阈值配置要核对口径。
- 换度量口径等于全量重建索引,必须在建库前定死。
度量选好了,下一节讲预处理:归一化怎么做才不出错,入库前还要清理哪些脏东西。