2.3 向量规范化与预处理
2.3 向量规范化与预处理
度量口径在上一节定了下来,本节处理入库前的最后一道工序。承接 2.2 的结论——归一化能让三种度量排序等价——本节先用一个可复现的实验把这条性质钉死,再补齐预处理清单里剩下的项目:类型统一、脏数据清理、重复向量剔除。这一节是通往第三章的桥:索引算法默认进来的是自洽的数据,这道工序就是自洽的保证。
把"归一化后排序等价"跑成实验
口说无凭,用一段代码同时验证 2.2 的手算结论:
import numpy as np rng = np.random.default_rng(42) X = rng.normal(size=(8, 4)) * rng.uniform(0.5, 3.0, size=(8, 1)) # 模长各不相同 q = rng.normal(size=4) Xn = X / np.linalg.norm(X, axis=1, keepdims=True) # L2 归一化 qn = q / np.linalg.norm(q) ip_rank = np.argsort(-(X @ q)) # 原始内积排序 cos_rank = np.argsort(-(Xn @ qn)) # 归一化后内积,即余弦排序 neg_l2 = np.argsort([np.linalg.norm(x - qn) for x in Xn]) # 欧氏升序 print("原始内积排序 :", ip_rank) print("余弦排序 :", cos_rank) print("归一化后欧氏升序:", neg_l2) # 典型输出:后两者完全一致,而原始内积排序与它们不同
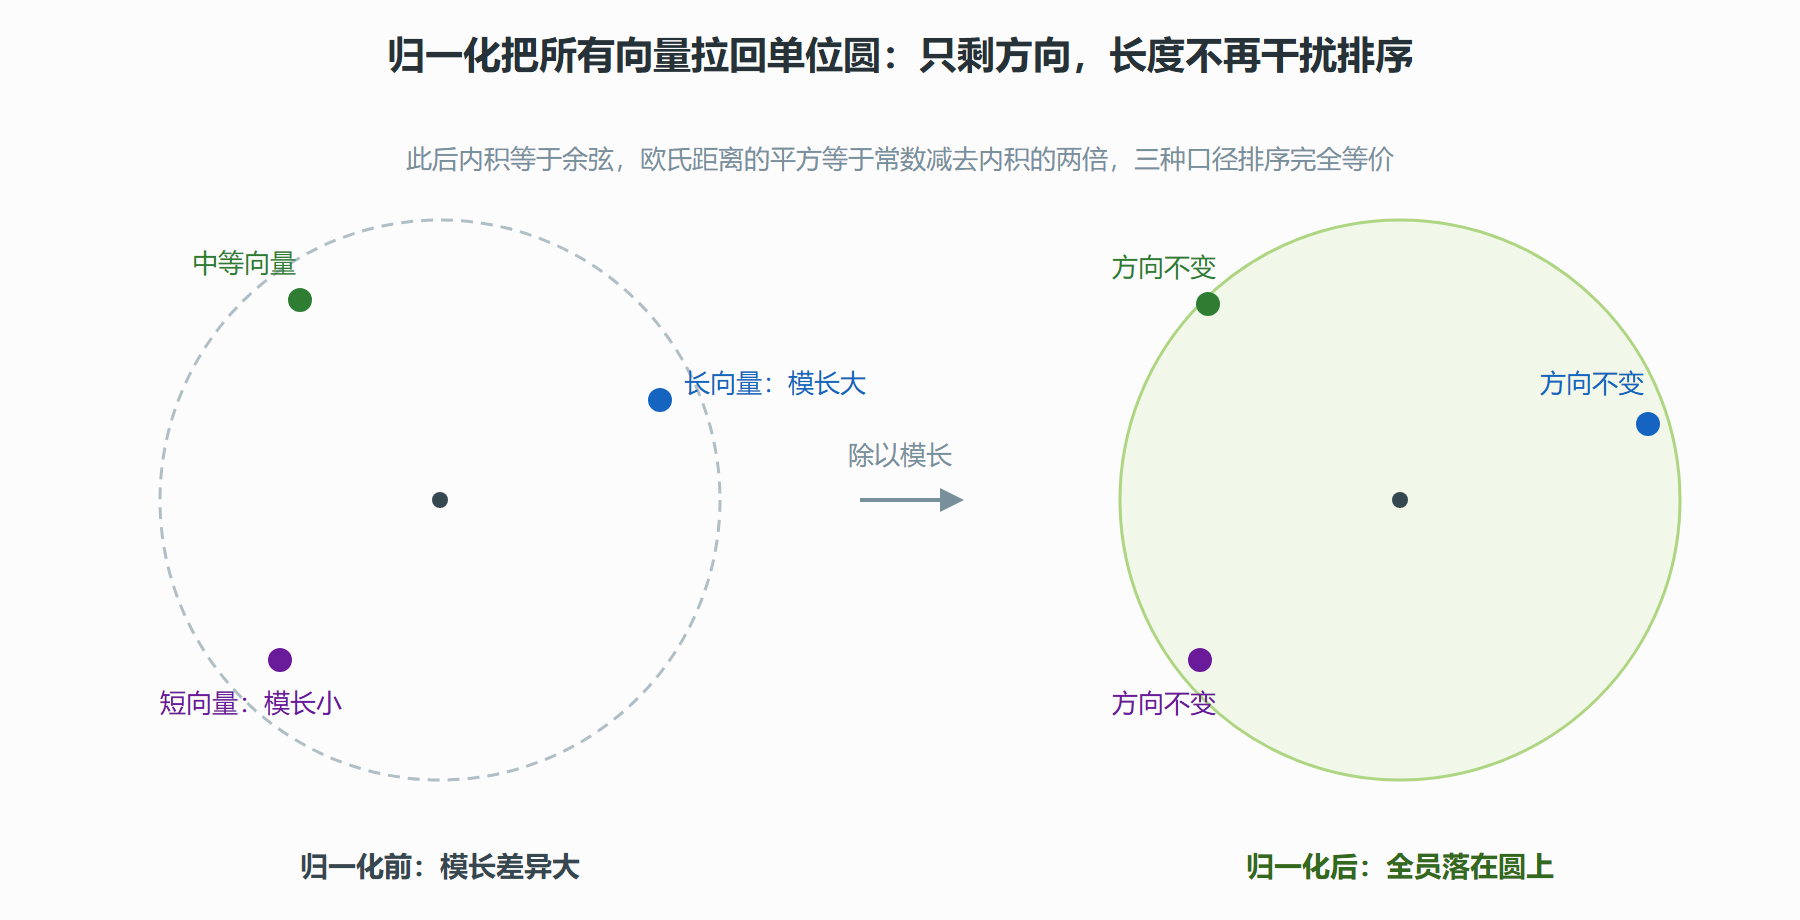
实验结果稳定复现两条结论:归一化后,内积降序与欧氏升序完全一致;不归一化时,内积排序会被大模长向量系统性抬高。工程含义直接明了——如果你的场景本该用余弦,就在入库与查询两端都做归一化,然后放心用内积,既拿到一致语义又省掉除法开销。几乎所有主流系统的高性能路径都是这么实现的。
图 2-3 归一化前后:散点投影到单位圆
预处理清单的其余项目
归一化之外,入库前还有五件事值得逐项过一遍。维度与形状校验:所有向量必须同维且等于集合声明维度,一个混入的错维向量轻则插入报错,重则让某些系统静默截断后污染索引。类型统一:统一用单精度浮点存储,避免半精度与单精度混存引发的范围与舍入问题;量化压缩留给索引层做,存储层保持原始精度。非有限值清理:无穷值与缺失值多来自空输入或异常批次,务必在写入前拒绝而不是让它们进索引。重复与近重复处理:同一内容被多次入库会让 TopK 被同源结果霸屏,业务上要么在写入端按内容指纹去重,要么在查询端按来源分组取最优。离群向量治理:训练分布之外的异常向量(损坏的图片、乱码文本)会在空间里产生孤立点,轻则浪费索引内存,重则干扰聚类类索引的质心,入库前用模长与数值范围做粗筛即可拦下绝大多数。
案例:一次召回率暗降的完整复盘
背景。 某知识库问答系统运行数月后,运营反馈"答非所问变多了",但监控里检索延迟正常、报错为零。团队起初怀疑索引参数漂移,调了两轮参数毫无起色。
操作。 按数据流逆向排查:先抽最近一个月新写入的向量,计算模长分布,发现新批次的模长明显小于历史批次;进一步比对新旧批次的编码任务配置,发现一个月前一次"优化"把查询端归一化保留、文档端归一化去掉了——新文档以原始模长入库,而查询向量是归一化的,两侧口径错位。历史数据是归一化过的,新数据不是,库里从此混着两种口径的向量。
结果。 对新批次补做归一化重灌后,抽样的相关性评估合格率从约六成回到约八成五,与故障前水平一致;全程没有动过任何索引参数。
解读。 这正是 2.1 强调"两端对称"、2.2 强调"归一化等价"的现实注脚:文档端没归一化时,短文档的原始模长小,内积分数被系统性压低,表现为"短文档几乎永远召不回",而指标面板上没有任何异常。表示层故障的特点就是静默,只能靠数据质量巡检兜底——把模长分布、维度分布做成例行监控项,异常批次在入库时就被拦住。
变式。 同样的排查思路适用于其他口径错位:换嵌入模型版本后没有全量重算(新旧向量不同坐标系)、切块粒度调整后只有一半数据重灌(同库不同粒度)、多租户场景某个租户单独用了不同的预处理参数。共同教训是把"向量自洽性"当作数据契约写进入库流程,而不是靠人肉记住。
一段可复用的入库前守门代码
把本节的清单落成一个守门函数,放在所有写入路径的必经之路上:
import numpy as np def guard(vec, dim=768, dedup_cache=None, fingerprint=None): """入库前守门:返回处理后的向量,或抛出带原因的异常""" v = np.asarray(vec, dtype=np.float32) if v.shape != (dim,): raise ValueError(f"维度不符: 期望 {dim} 实际 {v.shape[0]}") if not np.isfinite(v).all(): raise ValueError("存在非有限值(nan 或 inf),多半是空输入或异常批次") norm = np.linalg.norm(v) if norm < 1e-6: raise ValueError("零向量或接近零向量,检查嵌入服务返回") v = v / norm # 统一归一化,口径与查询端一致 if fingerprint and dedup_cache is not None: if fingerprint in dedup_cache: # 内容指纹去重,防同源霸屏 raise KeyError("重复内容,跳过写入") dedup_cache.add(fingerprint) return v.astype(np.float32)
守门函数的真正价值不在单次拦截,而在把口径变成组织的默认:所有写入方走同一个函数,"归一化了吗""维度对不对"就不再依赖口头约定。把它的拦截次数打进监控,拦截率突增往往对应上游变更(换模型、改管道),比召回率下跌早好几周发出预警。
两个辨析
归一化会丢信息吗? 会丢模长信息。多数文本嵌入的模长只反映文本长度或词元数这类噪声,丢掉无妨;但如果你刻意让模长承载业务含义(推荐场景的热度、置信度),归一化就会把这份信号抹平——这类库就不要做归一化,直接用内积,并在守门函数里把归一化分支关掉。归一化不是教条,是与度量口径配套的选择。
去重该在向量层面还是内容层面做? 内容层面。向量层面的"重复"(距离极近)可能正是业务想要的相似内容,按向量去重会把合法的相似文档也丢掉;内容指纹(哈希、正排指纹)去重针对的是"同一条内容被重复入库",两者语义不同。近重复的模糊地带(改了几个字的搬运文)交给查询端的同源分组(5.2 的按来源取最优)处理,比在写入端硬切更稳。
本节要点回顾
- 归一化让内积、余弦、欧氏三种口径排序等价,是高性能检索的通行前提。
- 归一化必须两端对称:查询端与文档端同做或同不做。
- 入库五查:维度、类型、非有限值、重复、离群。
- 表示层故障是静默的,模长与维度分布要做成例行监控项。
- 向量自洽性是数据契约,换模型、改参数都要有全量重算预案。
表示层至此完工。下一章进入全书心脏:面对亿级向量,索引结构怎么把"逐点比较"变成"几次跳跃就到位"。