3.1 从裸映射到纠错码:RS码与喷泉码
3.1 从裸映射到纠错码:RS码与喷泉码
本节摘要:纠错码是 DNA 存储语法的地基:2015 年 ETH 苏黎世团队把里德-所罗门码搬进 oligo 分块,给出"代数门派"的答案;2017 年厄利希与齐林斯基的 DNA 喷泉码给出"概率门派"的答案,密度逼近理论极限。本节讲清两条路线的原理、结构差异与各自的适配场景,并解释为什么冗余不能替代纠错码。
冗余为什么不够用
先把开山方案的账目摊开看。丘奇方案靠测序覆盖兜底:每个位置多测几遍,少数服从多数。戈德曼方案靠四重合成加表决:每条 oligo 四份拷贝,两两对照。这两个办法有共同的致命属性——它们只能"发现并容忍"错误,不能"以信息论最优的方式修复"错误。冗余倍数与错误率的关系是线性的:错误率高一点,冗余就得跟着加倍,而每倍冗余都直接写进合成与测序的账单。错误率若是百分之几,冗余策略就是无底洞。
纠错码的思路完全不同:往数据里注入结构化的冗余,让接收端能"解方程"般重建出错位置的原值。同样百分之一的冗余,纯拷贝只能发现错误,码字却能纠正错误——这是通信行业用了七十年的魔法,问题只在于它能不能适配分子信道的怪脾气。分子信道的怪脾气有三条:错误不只有替换,还有插入与删除(尤其纳米孔读端);整条 oligo 丢失是常态(合成失败、扩增偏好、测序掉链);读写以"条"为单位,天然是分包结构。2015 年之后的两大门派,就是对这三条脾气的两种回应。
代数门派:里德-所罗门码进试管
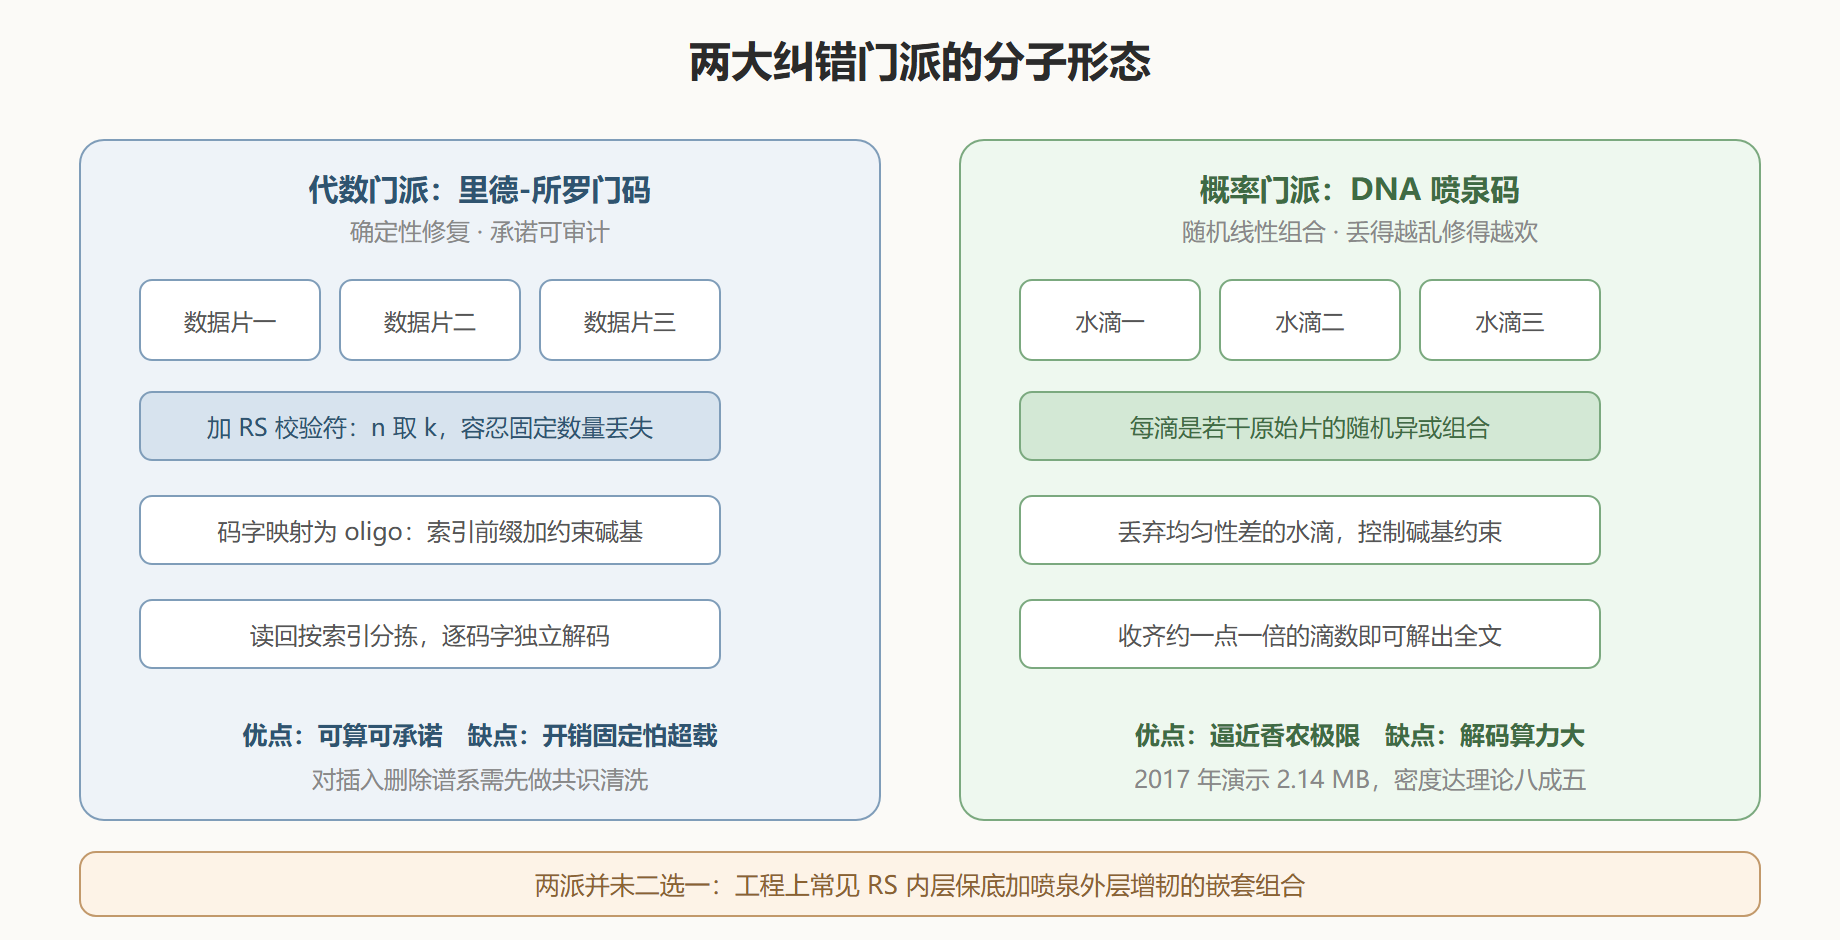
ETH 苏黎世的罗伯·格拉斯团队在 2015 年给出了第一份系统的代数答案。方案结构分三层:原始文件先切片,每片配上里德-所罗门校验符,组成一个个码字;每个码字再映射为满足碱基约束的 oligo 序列;读回后先按索引分拣,再对每个码字独立解码——只要丢失与错误的 oligo 数不超过校验容量,数据就能完整重建。里德-所罗门码的妙处在于它纠正的是"擦除":如果你知道哪条 oligo 丢了(索引对不上号就是丢),每个校验符可以换回一个未知数,代价小、逻辑清晰。
这套结构用工程师熟悉的方式画出来,是一个标准的嵌套分层:
原始文件 1.2 MB └─ 切片:每片 64 字节负载 └─ RS(n=72, k=64):8 字节校验,容忍任意 8 片丢失或出错 └─ 码字 → 碱基映射(约束过滤 + 索引前缀)→ oligo 池 读回:索引分拣 → 按码字解码 → 重组文件 → 校验和验收
代数门派的优点是确定性与可计算:丢多少、坏多少、能不能修,全都能事先算清,这正是归档行业最爱的"承诺可审计"。代价是灵活度差:码字结构写死之后, oligo 丢失率一旦超出设计余量,整块数据报废;而且校验符占用的密度开销固定在百分之十几的水平,压不下去。此外它默认错误模型偏"替换与擦除",对纳米孔时代的插入删除谱系不够贴合,需要配合共识序列先"洗"一遍。
图:RS 码分块与喷泉码包裹的嵌套结构
概率门派:喷泉码的分子直觉
2017 年,哥大与纽约基因组中心的厄利希、齐林斯基组合在《科学》发表 DNA 喷泉码,给出了第二种回应,思路与代数门派截然相反:不预先切码字,而是把文件切成大量小片,每条 oligo 装的是"若干原始片段的随机异或组合",外加一个记录组合方式的种子。读回时,只要收集到比原始片数略多的"水滴",就能像玩数独一样逐滴解出全部原始片段。它对丢失几乎免疫——水滴本来就是随机的,再丢一些也只是多收几滴的事。
这个概率结构对分子信道的适配近乎量身定做。团队还做了两处分子化改造:一是在生成水滴时主动丢弃碱基分布不均、可能触碰约束的水滴,让"约束满足"变成生成过程的一部分而非事后过滤;二是用此方案打包了约 2.14 兆比特数据,等效密度达到理论上限的八成五上下,把戈德曼方案留下的密度赤字一举收复大半。代价是解码端的算力开销与随机性带来的小概率长尾——归档行业还没完全接受"概率性承诺"。所以今天的工程实践中,两派常见嵌套组合:内层里德-所罗门保底,外层喷泉码增韧。
要点回顾
- 冗余只能发现与容忍错误,纠错码能以信息论最优的方式修复错误;分子信道的三大脾气——插入删除、整条丢失、分包读写——决定了纠错码不能照搬通信业原版。
- 里德-所罗门方案是代数门派:分层嵌套、确定性修复、承诺可审计,代价是开销固定、怕丢失超载。
- 喷泉码是概率门派:随机组合水滴、丢失免疫、密度逼近理论极限的八成五,代价是解码算力与概率性承诺。
- 工程趋势是嵌套组合而非门派之争;选择哪派,取决于你的错误模型与"承诺口径"。
常见追问
纠错码与多重覆盖冗余能不能同时用? 不仅 能,而且必须。多重覆盖对付的是测序读段的随机差错——它产出可靠的共识序列;纠错码对付的是共识之后的残余差错与整条序列丢失——它产出可靠的文件。两者的作用层面不同:一个在分子层面"去噪",一个在码字层面"修复"。设计的关键是分工边界的划定:覆盖深度按测序错误率定,校验符数量按合成丢失率定,两层预算互相独立才不会重复花钱。
为什么说喷泉码特别"懂"分子池? 因为它把丢失从异常改写成了常态。传统码字结构里,一条序列丢失等于一个确定的坑,必须靠校验符回填;喷泉码的水滴本来就随机生成,收到的水滴凑够数量即解码,多收几滴只是多花几条序列的合成钱。分子池的丢失率随批次波动,喷泉码对波动天然免疫——这在工程上叫鲁棒性,在账本上叫省心。
RS 码的校验符吃掉多少密度? 以常用的配置为例,七十二个码字符号里六十四个装数据、八个装校验,开销约百分之十二点五;加上索引区与引物区,一条 oligo 里真正装数据的碱基往往只有一半上下。这就是 5.1 节"工程口径折损到理论值百分之一"的主要来源之一——密度的赤字,大头是买可靠性花的钱。
追问补遗
喷泉码的水滴会不会重复? 会,而且无害。两个水滴随机选中同一组原始片段的概率存在,重复水滴只是不提供新信息,解码器把它丢掉即可。工程上通过给每个水滴的随机种子加序号偏移来压低重复率,但即便有重复,也只等价于多合成几条序列——在分子信道"丢失才是大头"的背景下,这点浪费可以忽略。
为什么 RS 码在存储圈比 LDPC 更流行? LDPC 的纠错性能上限更高,但它需要长码长才能发挥,而一条 oligo 只有百来个碱基,装不下长码字;RS 码短码长下依旧强健,且解码逻辑清晰、可承诺。介质形态决定了码的选择——这是"约束优先于性能"的又一个例子。
纠错解决了"读得回",下一个问题是"找得到":亿万分子的池子里怎么捞出指定文件?下一节讲随机访问——引物地址的发明。